LLM locales
Los LLM locales son modelos de lenguaje que se ejecutan directamente en tu propio hardware — un portátil, un PC con GPU o un servidor casero — sin nube, sin suscripciones y sin que los datos salgan de tu máquina. Ollama, llama.cpp y LM Studio, junto con las versiones GGUF cuantizadas de Llama, Qwen y Gemma, lo hacen posible incluso en una tarjeta gráfica de hace una década. Aquí está toda nuestra cobertura sobre ejecutar IA en local: guías, pruebas de hardware, cuantización y privacidad.
GPTunneL y la Tendencia Forbes: Por Qué las AI-Superapps Se Están Convirtiendo en el Nuevo Motor de Crecimiento del Mercado
Habr mostró cómo entrenar una mini-LLM en C# usando ILGPU y gráficos AMD integrados
LM Studio y Qwen: cómo los LLMs locales manejan la codificación en MacBook M4 Pro
Qwen 3.5 en MacBook Pro: Comparación de ocho servidores locales para trabajo en equipo
El autor probó ocho servidores MLX en MacBook Pro M2 Max con Qwen 3.5 35B y demostró que prácticamente todas las soluciones pierden significativamente velocidad con…
Habr AI lanza guía sobre ChatGPT, Claude y mcp para quienes comienzan
Habr AI explicó sin teoría innecesaria las diferencias entre modelos locales y en la nube, por qué pagar suscripciones, cómo funcionan los agentes y por qué mcp ya…
PrismML Bonsai: Cómo ejecutar un modelo de 1 bit en CUDA con GGUF, JSON y RAG
En un nuevo tutorial de PrismML Bonsai, cubrimos cómo ejecutar Bonsai-1.7B en GPU a través de CUDA y GGUF, medir velocidad, configurar chat, salida JSON estricta y…
Phi-4-Mini de Microsoft: implementación de cuantización, RAG y LoRA en un único notebook Jupyter
Cómo YOLO y OpenCV aprendieron a analizar cartas de porte — y por qué eso no basta
Multiverse Computing lanzó una API pública con modelos comprimidos de OpenAI, Meta y DeepSeek
Apple programó WWDC 2026 para el 8-12 de junio y anunció grandes actualizaciones de IA
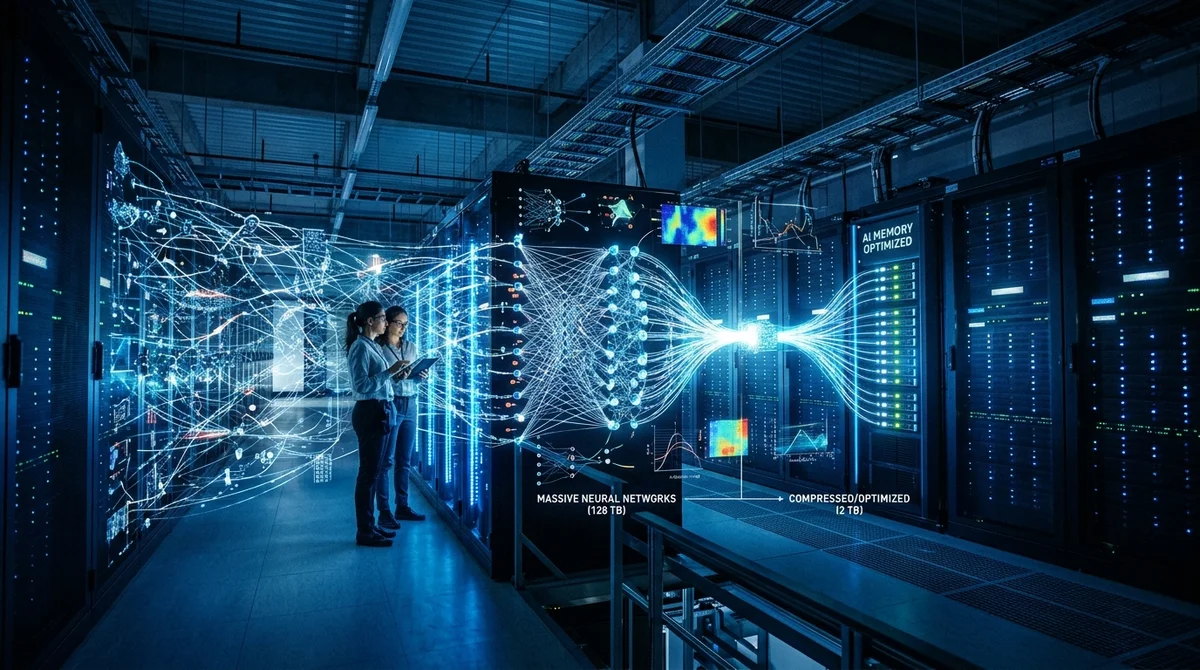
Google presenta TurboQuant — un algoritmo que comprime seis veces la memoria de trabajo de la AI
Google desarrolló TurboQuant, un algoritmo que teóricamente comprime seis veces la memoria de trabajo de las redes neuronales — internet ya lo compara con Pied…
Mistral lanzó un modelo abierto de generación de voz para smartphones y relojes inteligentes
Mistral lanzó un modelo abierto de voz que funciona directamente en un smartphone o reloj inteligente — sin recurrir a la nube, sin latencia de red y sin tarifas de…
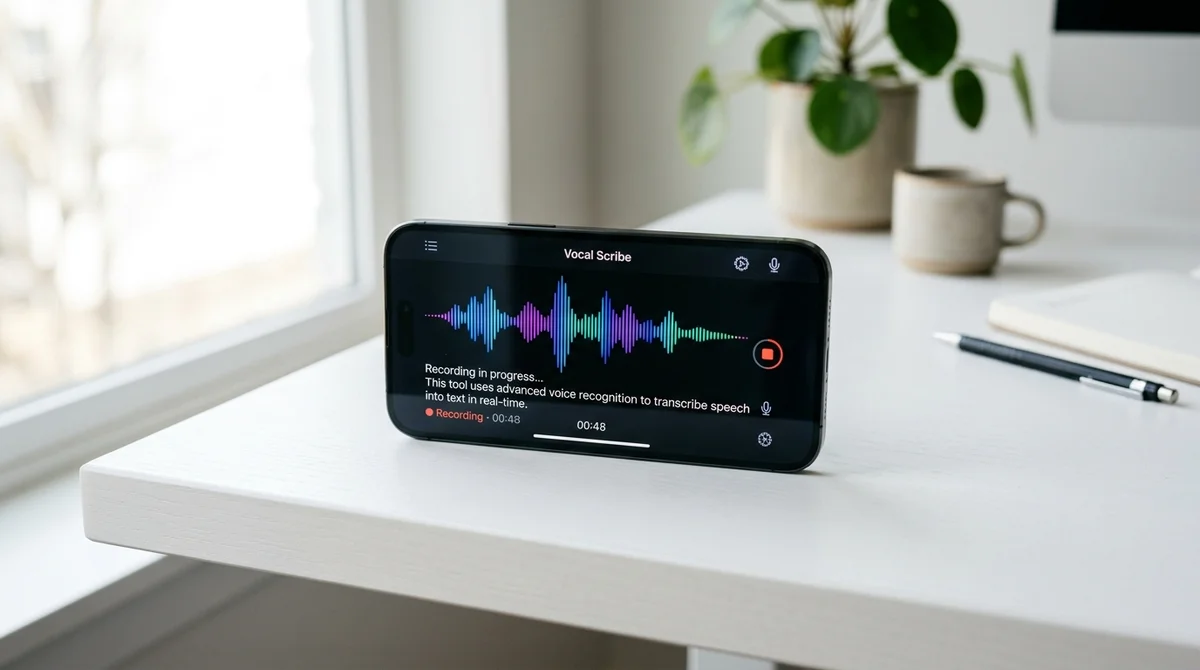
Google lanzó discretamente IA de dictado para iOS que funciona sin internet

Los agentes de IA ya escriben código para GPU: RightNow AI lanza el framework AutoKernel

La magia de la cuantización: cómo ejecutar redes neuronales gigantes en un portátil convencional

Google presenta TurboQuant: un algoritmo que reduce seis veces la memoria de los modelos de IA
Gemini 3.1 Flash-Lite: Google apuesta por un AI rápido y de bajo costo
Google presentó Gemini 3.1 Flash-Lite, el modelo más rápido y más económico de la línea Gemini 3. La compañía envía una señal al mercado: la era de los modelos de…
Decima-8: la arquitectura que busca reinventar los chips neuromórficos
La nueva arquitectura neuromórfica Decima-8 propone un enfoque radical: codificación de señales mediante niveles de energía, crossbars digitales en lugar de…