LLM locales
Los LLM locales son modelos de lenguaje que se ejecutan directamente en tu propio hardware — un portátil, un PC con GPU o un servidor casero — sin nube, sin suscripciones y sin que los datos salgan de tu máquina. Ollama, llama.cpp y LM Studio, junto con las versiones GGUF cuantizadas de Llama, Qwen y Gemma, lo hacen posible incluso en una tarjeta gráfica de hace una década. Aquí está toda nuestra cobertura sobre ejecutar IA en local: guías, pruebas de hardware, cuantización y privacidad.
Habr AI mostró cómo preparar una entrada estructurada para un agente de AI en lugar de una especificación técnica en bruto
Wonderful capta US$ 150 millones para agentes de soporte con AI y alcanza una valoración de US$ 2.000 millones
Whisper y Gemma 3 unidos con aprendizaje contrastivo para entrada de voz de bajo costo en LLMs
Stanford presentó OpenJarvis — una stack de agentes de AI locales con memoria y aprendizaje
Stanford presentó OpenJarvis — una plataforma para agentes de AI personales que funcionan directamente en el dispositivo, usan memoria y herramientas y aprenden con…
Un stack open source de 6 modelos y 9 agentes mostró cómo montar un equipo de AI en un solo servidor
Seis modelos open source y nueve agentes en un solo servidor con GPU forman un equipo autónomo de AI que diseña, escribe, prueba y despliega nuevos agentes por su…
GLiNER 2 mostró cómo los encoders compactos están alcanzando a los LLMs en NER y clasificación
Una nueva ola de encoders zero-shot, encabezada por GLiNER 2, muestra que las tareas de NER y clasificación pueden resolverse sin LLMs pesados — más rápido, más…
Nvidia convirtió OpenClaw en una plataforma empresarial con seguridad y modelos locales de AI
NVIDIA lanzó Nemotron 3 Nano 4B — un modelo híbrido compacto para ejecutarse en dispositivos
Hugging Face: los modelos open-source chinos superan a EE. UU. en descargas dentro del ecosistema de AI
Jensen Huang, de Nvidia, llamó a OpenClaw el 'próximo ChatGPT' para la era de los agentes de AI
Ollama y LiteLLM: Habr mostró cómo ejecutar un chat LLM local en Python sin nube
Una guía práctica para principiantes fue publicada en Habr: el autor muestra cómo desplegar un modelo local a través de Ollama, conectarlo a Python mediante LiteLLM…
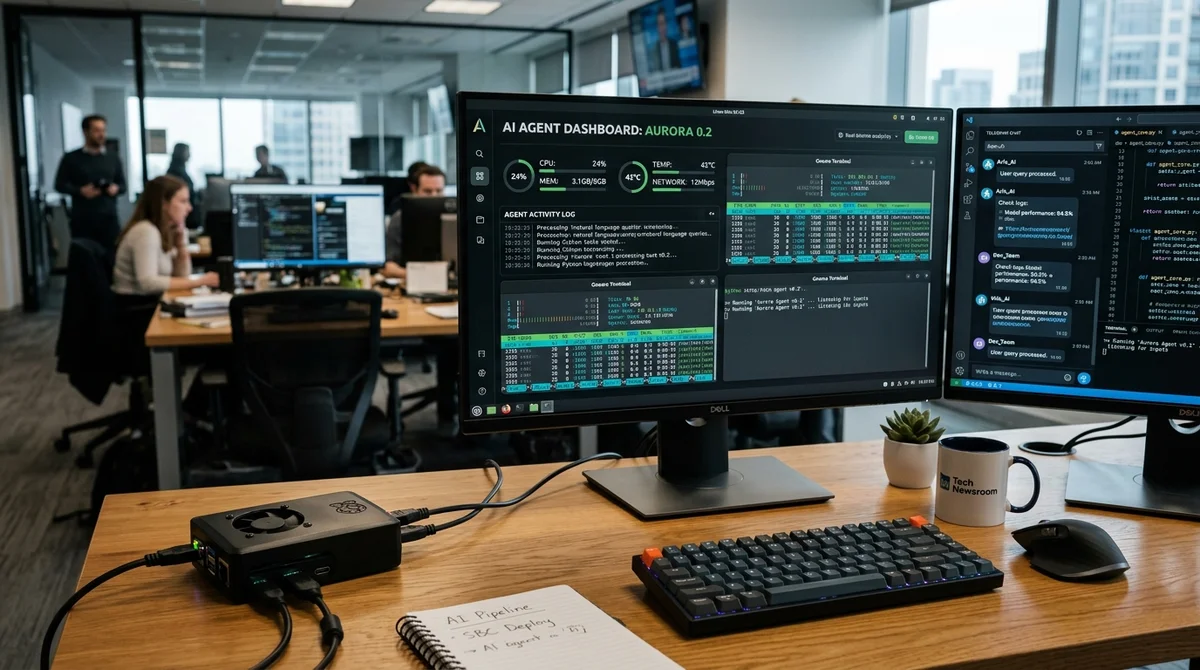
Raspberry Pi 5 y openLight: por qué los agentes de AI típicos sobrecargan el hardware modesto
El autor explica por qué los frameworks populares de agentes de AI encajan mal en Raspberry Pi 5 y creó openLight, un runtime ligero en Go con interfaz de Telegram…
Ollama y LiteLLM: cómo convertir un script de Python en un chat LLM completo en consola
AI Independence Bench comparó 49 modelos y midió su resistencia a la presión del usuario
Garage Eight: cómo AI está cambiando el trabajo de los analistas y por qué están desapareciendo los puestos junior
Apple apuesta por IA local en chips serie M, no en modelos gigantes
Doka presenta agente IA local para Rusia sin VPN, suscripción ni nube
Un desarrollador empaquetó su propio agente IA en la aplicación de escritorio Doka: el servicio funciona localmente, utiliza el modelo Qwen3 y no requiere nube, VPN…
MolmoWeb-4B de Ai2: Un agente web que ve sitios como humanos, sin parsing de HTML
Ai2 lanzó MolmoWeb-4B — un agente web multimodal de código abierto que controla un navegador usando solo capturas de pantalla, sin acceso a HTML ni árbol DOM.