LLM locales
Los LLM locales son modelos de lenguaje que se ejecutan directamente en tu propio hardware — un portátil, un PC con GPU o un servidor casero — sin nube, sin suscripciones y sin que los datos salgan de tu máquina. Ollama, llama.cpp y LM Studio, junto con las versiones GGUF cuantizadas de Llama, Qwen y Gemma, lo hacen posible incluso en una tarjeta gráfica de hace una década. Aquí está toda nuestra cobertura sobre ejecutar IA en local: guías, pruebas de hardware, cuantización y privacidad.
Project Nomad convierte un PC con Debian en un hub offline de conocimiento con AI local, mapas y Wikipedia
DeepSeek y Qwen intentaron pasarse "Everlasting Summer", pero se atascaron en el laberinto
Noi reúne ChatGPT, Claude y Gemini en una sola aplicación de escritorio sin cambios innecesarios
Kling, Veo y Sora: los 10 principales modelos de AI para la generación de video en 2026
El mercado del video con AI vuelve a cambiar de líderes: en un análisis reciente se compararon 10 modelos — desde Veo 3.1 y Kling 3.0 hasta Sora 2 y soluciones…
Habr AI mostró cómo crear tu propio RAG retriever en LangChain para nombres y términos
Habr AI publicó una guía práctica sobre cómo crear un RAG retriever personalizado con TF-IDF y LangChain para casos en los que la búsqueda vectorial funciona peor…
Ollama acelera la ejecución local de AI en Apple M5: se necesita un Mac con al menos 32 GB de memoria
Ollama 0.19 incorpora un backend MLX para Apple M5, M5 Pro y M5 Max: los modelos locales y los agentes de código responden más rápido, pero la aceleración requiere…
WACV 2026 en Tucson mostró el giro de la visión por computadora hacia la multimodalidad y los datos sintéticos
Gemma 4 de Google: cómo ejecutar tool calling de forma local con Python y Ollama
KDnuggets mostró cómo ejecutar Qwen3.5 en un portátil antiguo con Ollama y OpenCode
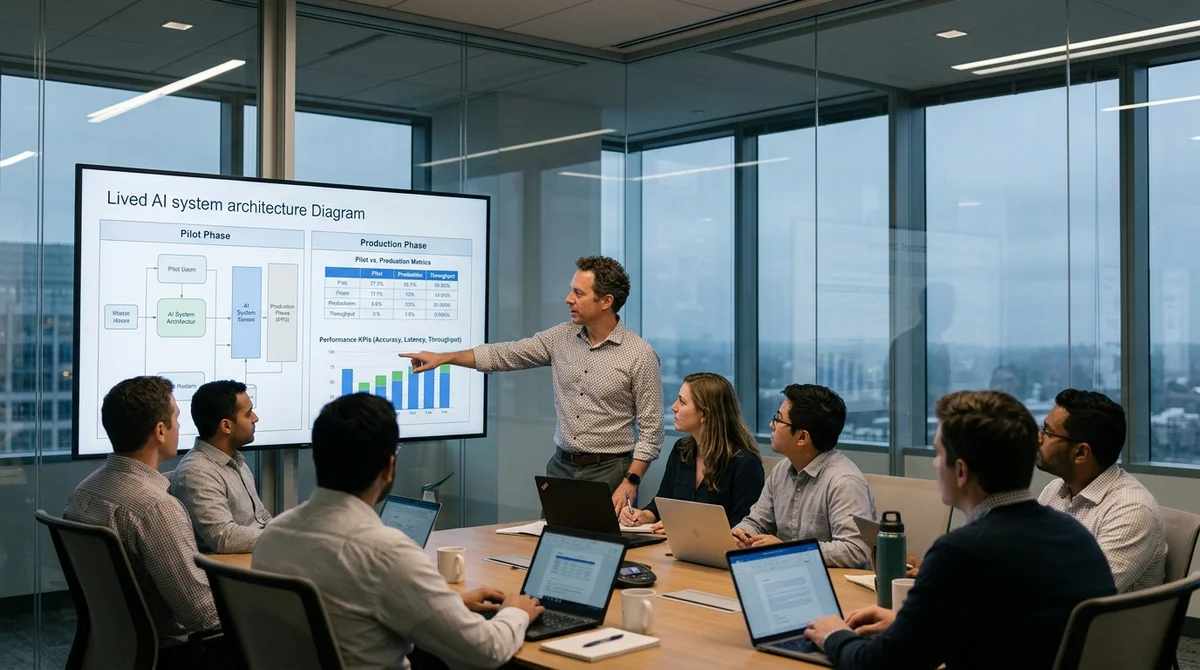
VTB explicó por qué los pilotos de AI se atascan antes de llegar a producción y cómo la arquitectura puede corregirlo
Overworld lanzó Waypoint-1.5: mundos interactivos en 720p para GPUs de consumo
Overworld lanzó Waypoint-1.5, un world model para ejecución local en GPUs de consumo: hasta 720p y 60 FPS, además de una versión 360p más ligera para una gama más…
OpenAI, Qwen y GigaChat: por qué a las empresas rusas les resulta cada vez más difícil elegir modelos de AI
El autor analiza cómo las empresas rusas quedan atrapadas entre las restricciones de OpenAI y Anthropic, la costosa inferencia local y el compromiso de recurrir a…
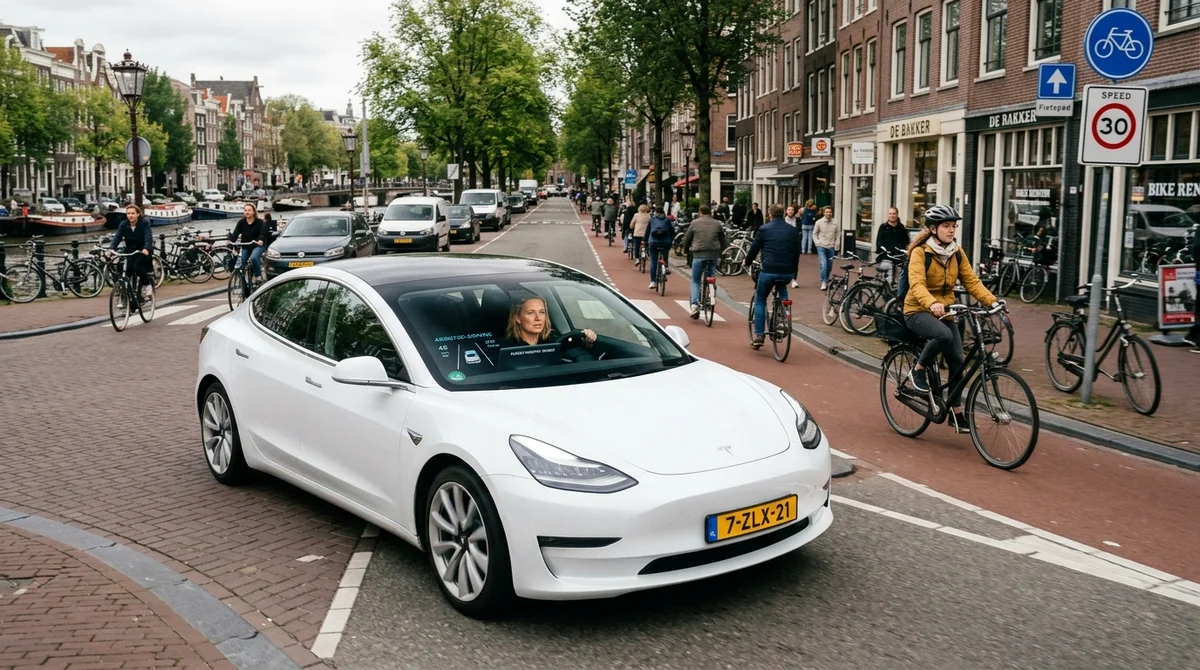
Tesla obtiene la primera autorización en Europa para FSD Supervised — arranca en los Países Bajos
Google Gemma 4 obligó a las empresas a replantear el control de AI en dispositivos locales
OpenGrall presenta el modo “Ingeniero”: el robot escribe drivers y configura módulos por sí mismo
Google mostró por accidente el asistente de AI COSMO en la Play Store y ocultó la app rápidamente
OpenCode, Ollama y Qwen3-Coder: cómo ejecutar un AI coder local sin nube ni límites
Reg.Oblako: la AI generativa entró en su fase de internet de 1997 y la ventana para entrar se estrecha
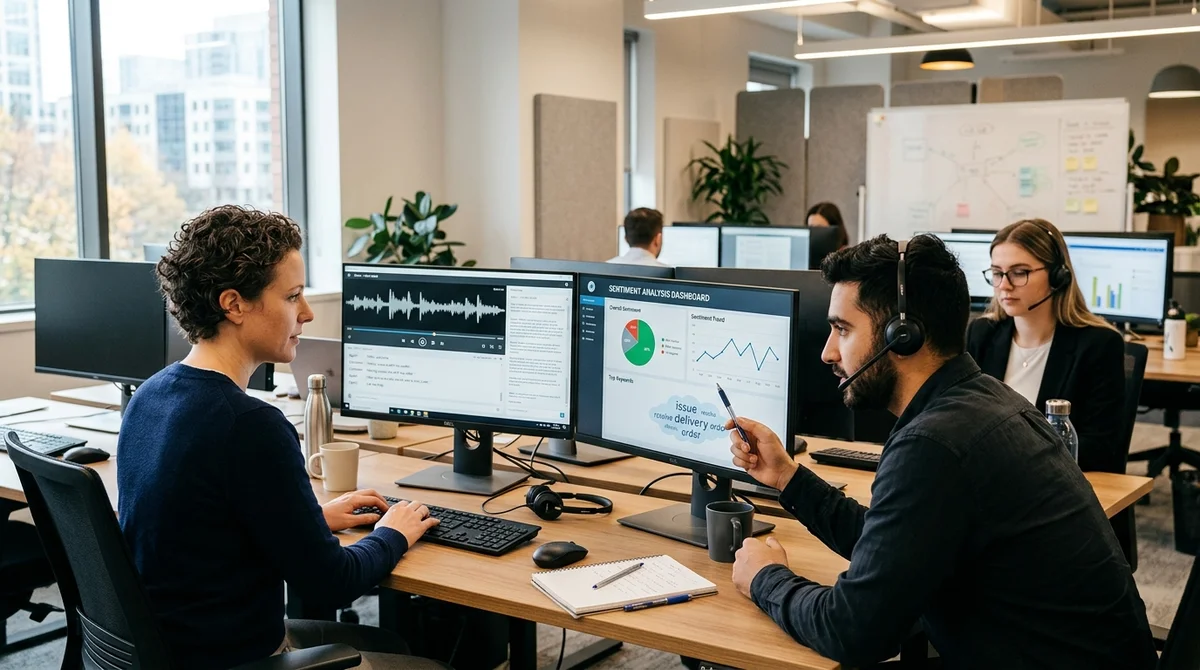
KDnuggets publicó una guía sobre análisis local de llamadas con Whisper, BERTopic y Streamlit
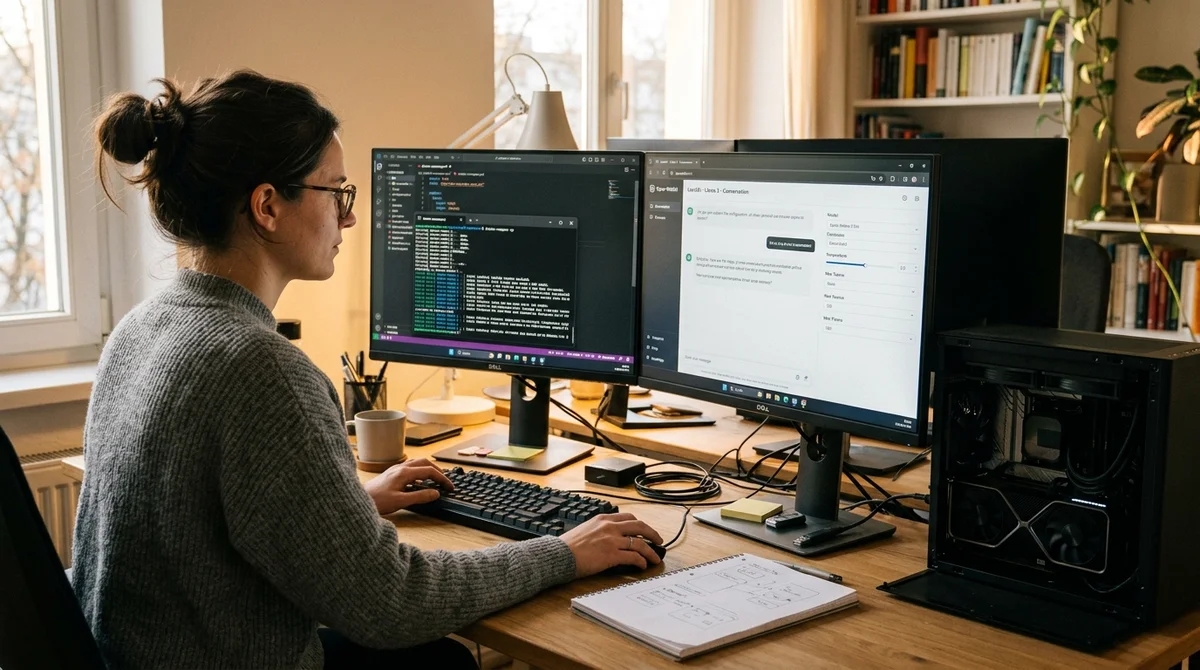
Open WebUI y llama.cpp: cómo configurar búsqueda web local con Qwen y Docker en Windows
El autor de una guía práctica mostró cómo convertir la combinación de Open WebUI y llama.cpp, de una búsqueda web débil, en un stack local funcional con Qwen, Tika…
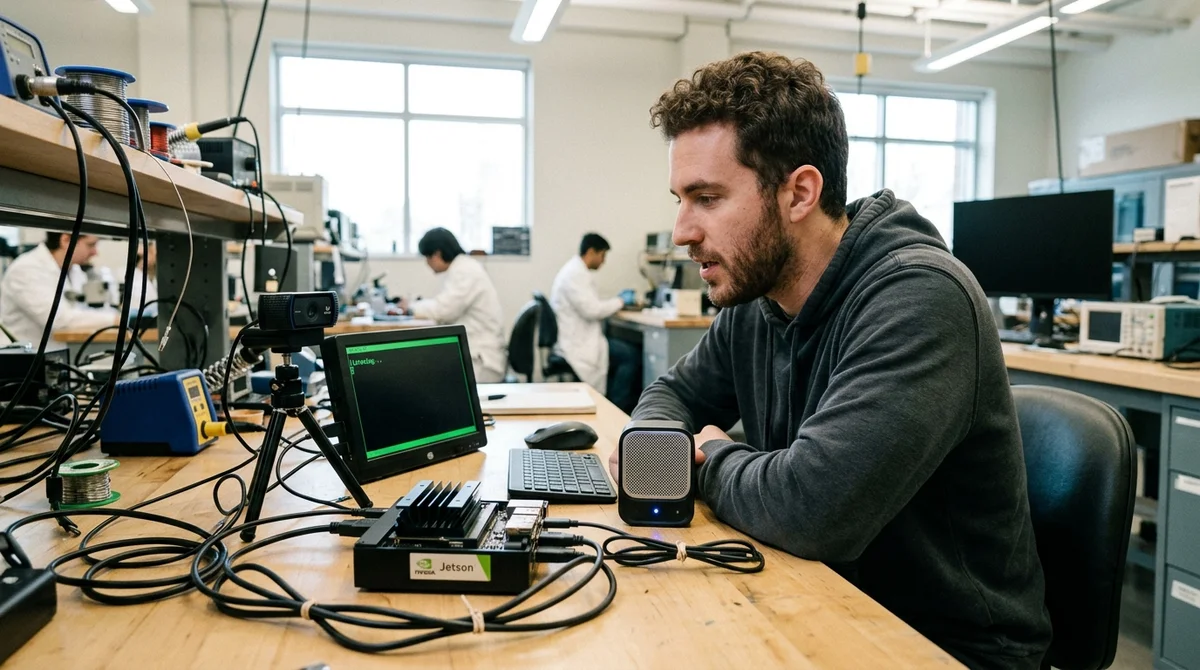
NVIDIA mostró cómo Gemma 4 con voz y cámara web funciona en Jetson Orin Nano Super
NVIDIA publicó una demo en la que Gemma 4 decide por sí sola cuándo activar la cámara web y responde por voz: todo se ejecuta localmente en Jetson Orin Nano Super…