NVIDIA Developer Blog
Fuente de noticias de IA. Los artículos son seleccionados y adaptados por la redacción de Hamidun News.
Últimas publicaciones

NVIDIA presenta ReplaySSM: cómo acelerar la decodificación de los modelos híbridos Mamba y GDN
NVIDIA analiza cómo almacenar el estado de las capas SSM al decodificar LLM híbridos. El tema afecta a Nemotron 3, Qwen3.5–3.8, Kimi-K3 y GLM-5.3-Flash.

NVIDIA escala el determinismo bit a bit en Megatron Core a 2.432 GPU con solo un 2% de sobrecarga
NVIDIA ha logrado determinismo bit a bit al entrenar un modelo Nemotron de un billón de parámetros en 2.432 GPU con una sobrecarga de apenas el 2%, lo que permite reproducir de forma fiable errores críticos, depurar pico

NVIDIA describe 5 pasos para preparar activos SimReady para robots mediante agentes de IA
NVIDIA ha mostrado un flujo de trabajo para convertir modelos CAD en activos OpenUSD para robots. Modelos de frontera como GPT-6 Astra automatizan la preparación: conversión, configuración de propiedades físicas y valida

NVIDIA KGMON queda segunda en la KDD Cup 2026 tras simplificar el harness de su agente
El equipo NVIDIA KGMON fue segundo en KDD Cup 2026 Data Agents: su agente respondía preguntas sobre seis tipos de datos, de bases de datos a vídeo. Su apuesta fue un harness compacto.

NVIDIA CCCL Runtime: abstracciones modernas de C++ para un desarrollo seguro en CUDA
NVIDIA añade a las bibliotecas CCCL el grupo de herramientas Runtime: abstracciones modernas de C++ que hacen más seguro el desarrollo para GPU y reducen el código repetitivo habitual.

NVIDIA logra el 100% en ARC-AGI-3: el protagonista no es el modelo, sino el harness
La arquitectura NVIDIA AVO obtuvo un resultado absoluto en el benchmark interactivo ARC-AGI-3. La conclusión clave: no resuelve el modelo, sino el harness, el sistema que gestiona su contexto, sus herramientas y su recup

NVIDIA Exemplar Cloud: por qué clústeres de IA idénticos pierden hasta un 12% de rendimiento
NVIDIA ha documentado una brecha sistemática del 8–12% en training throughput entre clústeres de IA idénticos con H100 y GB200 NVL72. La causa está en la configuración, no en el hardware.

NVIDIA acelera consultas analíticas Presto en la plataforma GPU GB200 NVL72
NVIDIA mostró la aceleración de GPU del motor SQL abierto Presto en la plataforma GB200 NVL72 para análisis de baja latencia en conjuntos de datos muy grandes.

NVIDIA presenta perfil LangChain Deep Agents para modelo Nemotron 3 Ultra
NVIDIA lanzó orientaciones sobre configuración de un perfil harness LangChain Deep Agents bajo su modelo abierto Nemotron 3 Ultra — la configuración adecuada debe acercar la precisión a modelos de frontera propietarios c

NVIDIA describió paralelismo tensorial no uniforme para el entrenamiento de LLM en GPU
NVIDIA publicó en Developer Blog un análisis de la técnica de paralelismo tensorial no uniforme que aumenta el goodput en el entrenamiento de modelos de lenguaje grande en clusters de miles de GPU.

NVIDIA mostró optimización del pipeline NuRec a través de Nsight Developer Tools
NVIDIA explicó cómo los ingenieros aceleran la reconstrucción 3D de redes neuronales en Omniverse NuRec usando perfiladores Nsight Developer Tools.

NVIDIA Developer Blog Explica Técnicas de Aprendizaje Reforzado para Agentes de IA
NVIDIA Developer Blog publicó un desglose de técnicas de aprendizaje por refuerzo para agentes de IA—desde RLHF clásico hasta nuevos enfoques de entrenamiento de modelos basados en retroalimentación.

NVIDIA describe GQE — plataforma para motores de procesamiento de consultas acelerados por GPU
NVIDIA publicó material técnico sobre GQE — una plataforma para diseñar motores de procesamiento de consultas acelerados por GPU limitados por ancho de banda de memoria.

NVIDIA XR AI: Cómo la Empresa Ayuda a los Desarrolladores a Construir Agentes de IA para Gafas AR
NVIDIA describió la brecha de infraestructura en el desarrollo de agentes de IA para gafas AR y dispositivos XR: el hardware está listo, pero integrar servicios de IA en vivo sigue siendo complejo.

NVIDIA Explica Cómo Crear un Transaction Foundation Model para Análisis Financiero
NVIDIA describió un enfoque para crear un modelo de fundación propio basado en datos de transacciones bancarias para la detección de fraude y un análisis más preciso del comportamiento financiero de los clientes.

NVIDIA DSX OS: sistema operativo abierto para fábricas de IA de cualquier escala
NVIDIA lanzó un SO modular para gestionar mega centros de datos con aceleradores de IA, resolviendo el problema de fragmentación del mercado.

NVIDIA Vera CPU: Nuevo Estándar para Tareas de IA Agéntica en Fábricas
El procesador Vera está especialmente optimizado para ejecutar cargas de trabajo agentivas en la era de la inferencia de IA escalable.

NVIDIA Cosmos 3: modelos para razonamiento y acciones en el mundo físico de robots
NVIDIA presentó Cosmos 3 — un conjunto de modelos fundamentales para IA física, incluidos modelos de mundo, modelos de razonamiento y modelos de acción para robots y sistemas autónomos.

NVIDIA DGX Spark: Agentes de IA Locales en Modelos Acelerados con Agrupamiento
NVIDIA introdujo soporte para agentes de IA locales en DGX Spark con modelos más rápidos y capacidades de clustering de múltiples nodos para cargas de trabajo escalables.

NVIDIA Alpamayo: Entrenamiento de Modelos en Bucle Cerrado para Vehículos Autónomos
NVIDIA presentó Alpamayo—una plataforma para el entrenamiento posterior de modelos de vehículos autónomos utilizando un ciclo cerrado de simulación y datos del mundo real.

NVIDIA DOCA: seguridad integrada para infraestructura de agentes de IA
NVIDIA presentó DOCA — una plataforma integrada en chips de red que proporciona garantías de seguridad integradas para "fábricas de IA" procesando datos en computación de redes neuronales.

NVIDIA NeMo genera datos financieros sintéticos para AI
NVIDIA presentó un método de generación sintética de datos financieros para entrenar LLMs, resolviendo el problema del desequilibrio de eventos raros en las noticias reales.

NVIDIA BioNeMo Agent Toolkit: acelerando la predicción de la estructura de proteínas
NVIDIA presentó BioNeMo Agent Toolkit para orquestar agentes de AI que automatizan todo el pipeline de predicción de la estructura de proteínas y co-folding, acelerando el desarrollo farmacéutico.

LLMs y hardware: NVIDIA sobre el equilibrio entre precisión, throughput y capacidad de respuesta
NVIDIA publicó recomendaciones para el diseño de LLM que exigen la optimización simultánea de tres parámetros: precisión, throughput y velocidad de respuesta para el usuario.
NVIDIA Vera CPU Aumenta el Rendimiento de AI-Factories para Cargas de Trabajo Agentivas
NVIDIA explicó cómo el procesador Vera CPU reduce los retrasos entre pasos de inferencia GPU y acelera los pipelines multi-paso agentivos en AI-factories industriales.
NVIDIA Confidential Computing: protección de datos durante la inferencia de AI sin pérdida de velocidad
NVIDIA explicó cómo la tecnología Confidential Computing protege los datos corporativos directamente durante la computación en GPU, sin sacrificar el rendimiento.
NVIDIA TensorRT ahora escala la inferencia de AI generativa en múltiples GPU
NVIDIA añadió a TensorRT soporte nativo para múltiples GPU — los modelos de generación de contenido multimedia escalan en producción sin perder las optimizaciones clave del motor.
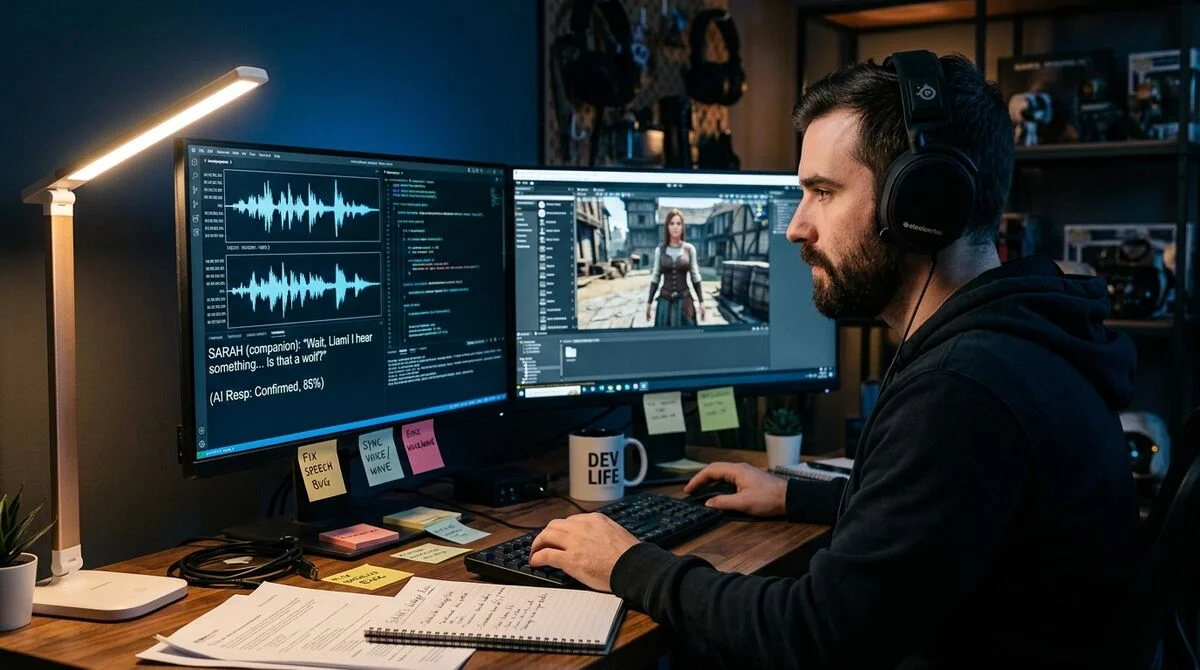
KRAFTON integró en PUBG a Ally, un compañero AI de voz basado en NVIDIA ACE
PUBG Ally es un compañero AI en PUBG: BATTLEGROUNDS que escucha comandos de voz, toma decisiones tácticas y responde con una voz sintetizada basada en NVIDIA ACE.
NVIDIA optimizó el BEV pooling en GPU para vehículos autónomos, robots y AI espacial
NVIDIA publicó una guía para acelerar el BEV pooling en GPU — una operación clave para la percepción espacial en vehículos autónomos, robots y sistemas de AI espacial.
NVIDIA lanza una guía para desplegar AI-Q Blueprint en Oracle Cloud Infrastructure
NVIDIA hizo posible el despliegue en producción de agentes de AI de largo plazo: AI-Q Blueprint ya está listo para ejecutarse en Oracle Cloud con seguridad de nivel empresarial.