NVIDIA Developer Blog
Fuente de noticias de IA. Los artículos son seleccionados y adaptados por la redacción de Hamidun News.
Últimas publicaciones
NVIDIA DAQIRI: inferencia de IA en tiempo real para la adquisición de datos de alta velocidad
NVIDIA presentó DAQIRI, un framework que integra la IA directamente en el flujo de datos de sensores e instrumentos científicos sin demoras.
NVIDIA presenta Halos, un sistema de seguridad funcional para robots con IA
NVIDIA Halos es una pila completa de seguridad funcional para la IA física: robots que trabajan junto a personas en fábricas, almacenes y hospitales.
NVIDIA explicó cómo entrenar transformers con precisión reducida sin perder calidad
NVIDIA publicó una guía para optimizar modelos transformer con FP8 y BF16 — cómo acelerar el entrenamiento y reducir el uso de memoria GPU sin perder precisión.
NVIDIA explicó cómo gestionar agentes autónomos en fábricas de AI empresariales
Los agentes de AI han ido mucho más allá del chat: trabajan durante horas con datos y sistemas empresariales, y NVIDIA explicó en detalle cómo construir un entorno seguro y gestionable para su despliegue.
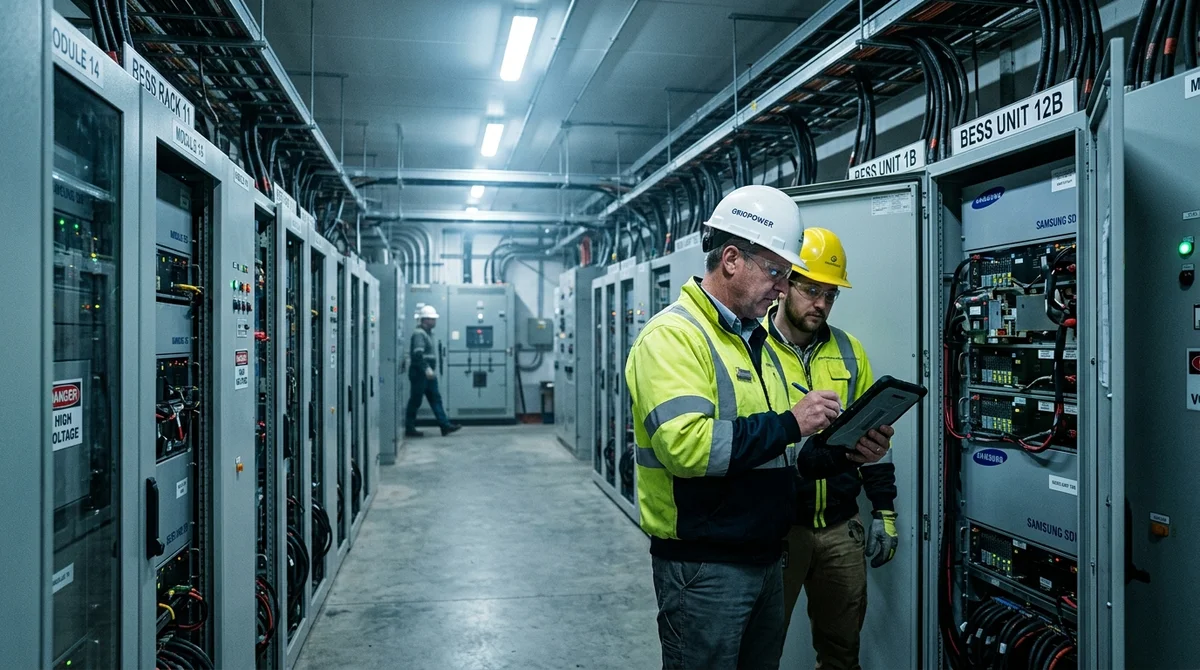
NVIDIA: cómo diseñar sistemas de almacenamiento de energía en baterías para fábricas de AI
NVIDIA explicó en qué se diferencian las fábricas de AI de los centros de datos convencionales en términos de consumo energético y describió los requisitos para los sistemas de almacenamiento de energía en baterías (BESS
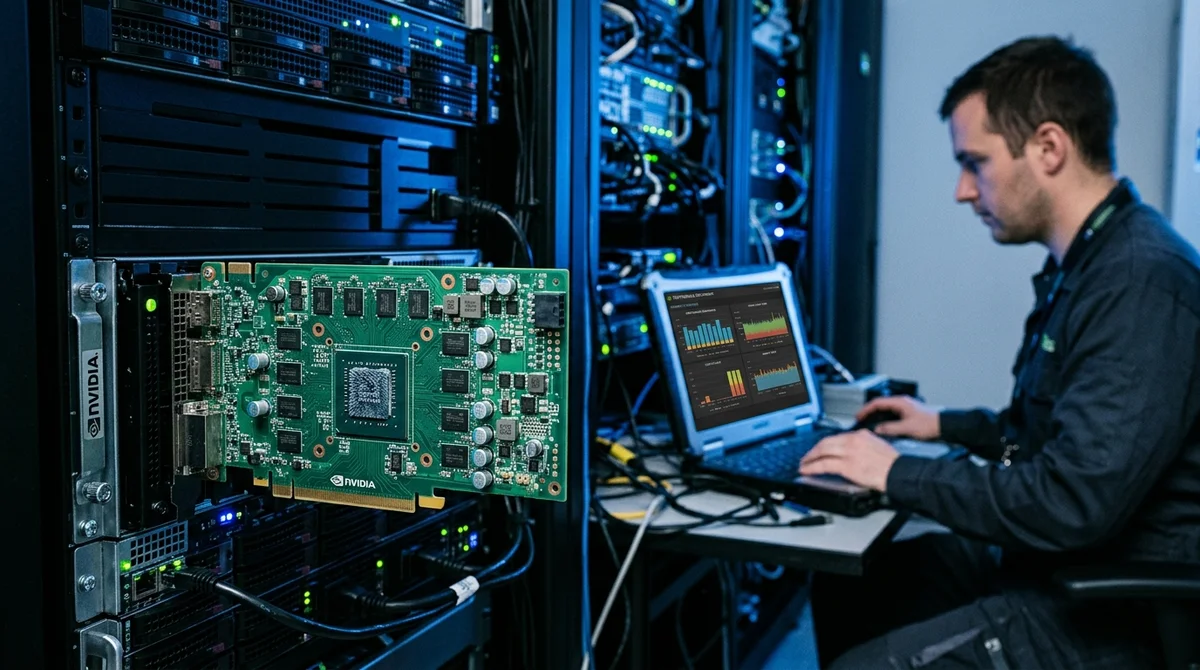
NVIDIA TensorRT convierte checkpoints FP8 en motores para inferencia rápida
NVIDIA explicó cómo convertir un checkpoint cuantizado en FP8 en un motor TensorRT — un paso que convierte un modelo optimizado en una herramienta real de producción.
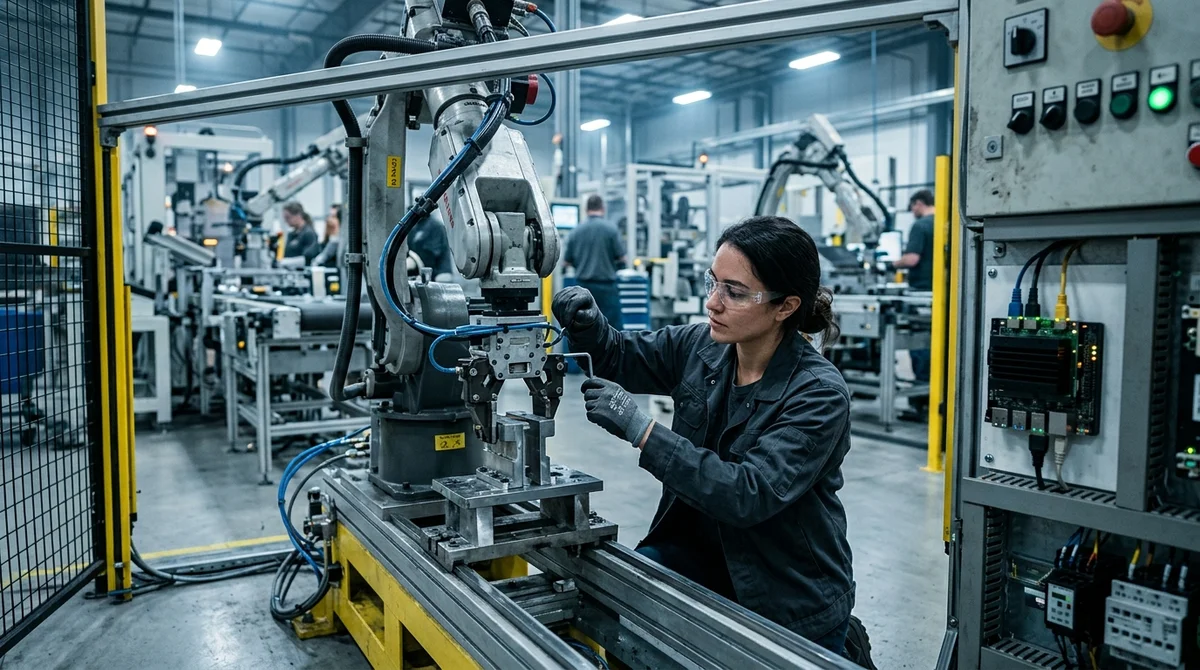
NVIDIA JetPack 7.2: agentes de AI en dispositivos de borde con un solo comando de despliegue
NVIDIA lanzó JetPack 7.2 para la plataforma Jetson — un solo comando CLI despliega un stack completo de agentes con privacidad y optimización de memoria.
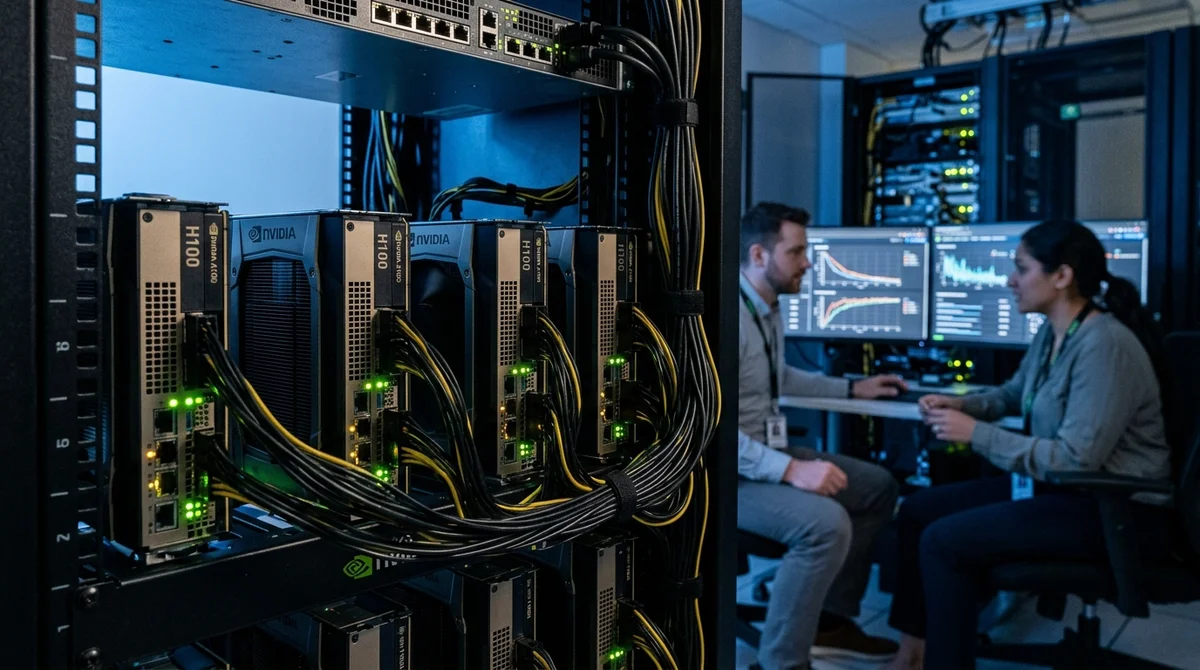
NVIDIA acelera el preentrenamiento de LLM: NVFP4 en Blackwell junto con JAX y MaxText
NVIDIA mostró cómo el formato NVFP4 en los chips Blackwell, junto con JAX y MaxText, reduce el tiempo de preentrenamiento de modelos frontier y los costes de cómputo.
NVIDIA BioNeMo permite reentrenar modelos de IA biológica con LoRA en horas
NVIDIA ha lanzado BioNeMo Recipes, pipelines listos para el ajuste fino de los modelos de lenguaje ESM2 y Evo 2 mediante el método LoRA. Ahora especializarlos para tareas biológicas es posible con un par de GPU.
NVIDIA acelera la inferencia en Blackwell hasta 15 veces con DFlash Speculative Decoding
NVIDIA publicó la técnica DFlash Speculative Decoding para la arquitectura Blackwell: la velocidad de inferencia de los modelos de lenguaje aumentó 15 veces con la misma precisión.
NVIDIA Explica la Diferencia Entre VLA y WAM — Dos Enfoques para el Control de Robots
NVIDIA diferencia entre VLA y WAM — dos clases de modelos robóticos: los primeros aprenden del lenguaje, los segundos de la predicción de la física del mundo. La diferencia definirá la arquitectura de la IA física.
NVIDIA lidera el primer benchmark industrial para agentes de IA AA-AgentPerf
Artificial Analysis lanzó AA-AgentPerf — el primer estándar abierto y multi-proveedor para evaluar la codificación agentica. NVIDIA aseguró la posición líder en métricas clave.
Google DeepMind presenta DiffusionGemma para la generación rápida de texto en NVIDIA
Google DeepMind ha optimizado el nuevo modelo DiffusionGemma para plataformas NVIDIA a fin de acelerar la generación de texto en tiempo real en chats, copilots y agentes.
NVIDIA MCG Toolkit automatiza la documentación de modelos de AI para nuevas regulaciones
NVIDIA presenta una herramienta para automatizar la documentación de modelos de AI, que ayuda a los equipos a cumplir requisitos regulatorios como el EU AI Act y a crear model cards verificables sin trabajo manual.
NVIDIA presenta DynoSim para la optimización de parámetros en LLM serving
NVIDIA presenta DynoSim, una herramienta para optimizar automáticamente la configuración del servicio de grandes modelos de lenguaje mediante simulación de la frontera de Pareto.
NVIDIA RTX presenta DLSS 4.5 y personajes IA multilingües para juegos
NVIDIA presentó una actualización RTX con soporte para personajes IA multilingües a través de ACE y nuevo DLSS 4.5 para Unreal Engine, simplificando el desarrollo de juegos con IA.
El nuevo CompileIQ de NVIDIA descubre el potencial oculto de los núcleos GPU mediante el ajuste automático de parámetros del compilador
NVIDIA presentó CompileIQ, herramienta con IA que ajusta automáticamente parámetros del compilador para maximizar rendimiento de GPU, encontrando aceleraciones donde la optimización manual se agota.
NVIDIA Blackwell estableció récord STAC-AI en trading de IA financiera
La arquitectura NVIDIA Blackwell demostró el mejor rendimiento en la prueba STAC-AI para IA financiera, procesando mayor volumen de datos más rápido que todos los competidores.
NVIDIA Dynamo Snapshot: aceleración del lanzamiento de modelos en Kubernetes
NVIDIA ha presentado una herramienta para reducir el tiempo de carga de modelos de inferencia en Kubernetes de minutos a segundos, una solución para evitar pérdidas de GPU durante picos de tráfico.
StepFun presentó Step 3.7 Flash en GPU NVIDIA para trabajo multimodal
StepFun lanzó Step 3.7 Flash — un modelo de IA multimodal con 198 mil millones de parámetros que procesa simultáneamente texto, imágenes, vídeo y documentos en aceleradores NVIDIA.
NVIDIA RTX PRO 4500 Blackwell: aceleración de genómica y modelado de proteínas
NVIDIA lanzó la tarjeta gráfica RTX PRO 4500 Blackwell para acelerar cálculos genómicos y modelado de proteínas, componentes clave de la medicina de precisión.
NVIDIA CUDA 13.3 simplifica el desarrollo en GPU con Tile programming en C++
NVIDIA lanzó CUDA 13.3 con Tile programming en C++, que automatiza la optimización de operaciones de bajo nivel con memoria GPU para desarrolladores.
NVIDIA añadió CUDA Tile para optimizar núcleos GPU en C++
NVIDIA presentó CUDA Tile, una tecnología integrada en C++ para desarrollar núcleos GPU de alto rendimiento basados en un enfoque orientado a tiles.
NVIDIA Ayuda a Empresas de Telecomunicaciones a Desplegar Fábricas de IA Soberanas con Token-Metering
Las empresas de telecomunicaciones están construyendo infraestructuras de IA soberana en la arquitectura NVIDIA Cloud Partner, utilizando token-metering para acceso controlado—un enfoque para servicios escalables y de al
NVIDIA GB200: Computación a Escala Exascalar en un Rack mediante Planificación Inteligente de Tareas
NVIDIA demostró cómo maximizar el rendimiento del GB200 NVL72 a través de Slurm con conocimiento de topología de red—los resultados muestran computación a escala exascalar en un único rack.
NVIDIA Muestra Cómo Rastrear GPUs en Clústeres de Kubernetes
La mayoría de los equipos subutilizan GPUs en clústeres de Kubernetes porque simplemente no ven quién las está usando, cuánta memoria se consume y si los contenedores se cuelgan.
NVIDIA mostró cómo los sistemas multi-agente encuentran señales en los mercados financieros
Los sistemas multi-agente de IA ayudan a los investigadores a automatizar la búsqueda de señales comerciales en datos de mercado, analizando precios, indicadores económicos y fuentes alternativas para identificar patrone
NVIDIA presenta herramienta para generación de imágenes médicas 3D
NVIDIA presentó el framework NV-Generate-CTMR para síntesis automática de imágenes médicas 3D realistas, resolviendo la escasez de datos en radiología y acelerando el entrenamiento de modelos de AI generalizados.
NVIDIA Vera Rubin: cómo los desarrolladores escalarán la IA de agentes sin latencias
NVIDIA presentó Vera Rubin, una plataforma para escalar la IA de agentes que combina la GPU Vera Rubin NVL72 y el acelerador Groq 3 LPX para lograr 400 tokens por segundo en modelos de un billón de parámetros.
NVIDIA mostró la diferencia entre la evaluación de modelos y la evaluación de agentes de IA
Los benchmarks de modelos y la evaluación de agentes resuelven tareas diferentes: los primeros prueban la comprensión del lenguaje, los segundos el comportamiento real del sistema en acción.