FlashAttention-4: cómo Together AI aceleró la atención en las GPU Blackwell
FlashAttention-4 rediseña el kernel de atención específicamente para Blackwell. La aceleración viene de la nueva memoria tensorial (TMEM) y del modo 2-CTA MMA, que atacan el verdadero cuello de botella: no la velocidad de las operaciones matriciales, sino la SFU del softmax y la memoria. El resultado: 1605 TFLOPs/s (71 % de utilización), 1.3× más rápido que cuDNN y 2.7× más que Triton.
Procesado por IA desde Together AI Blog; editado por Hamidun News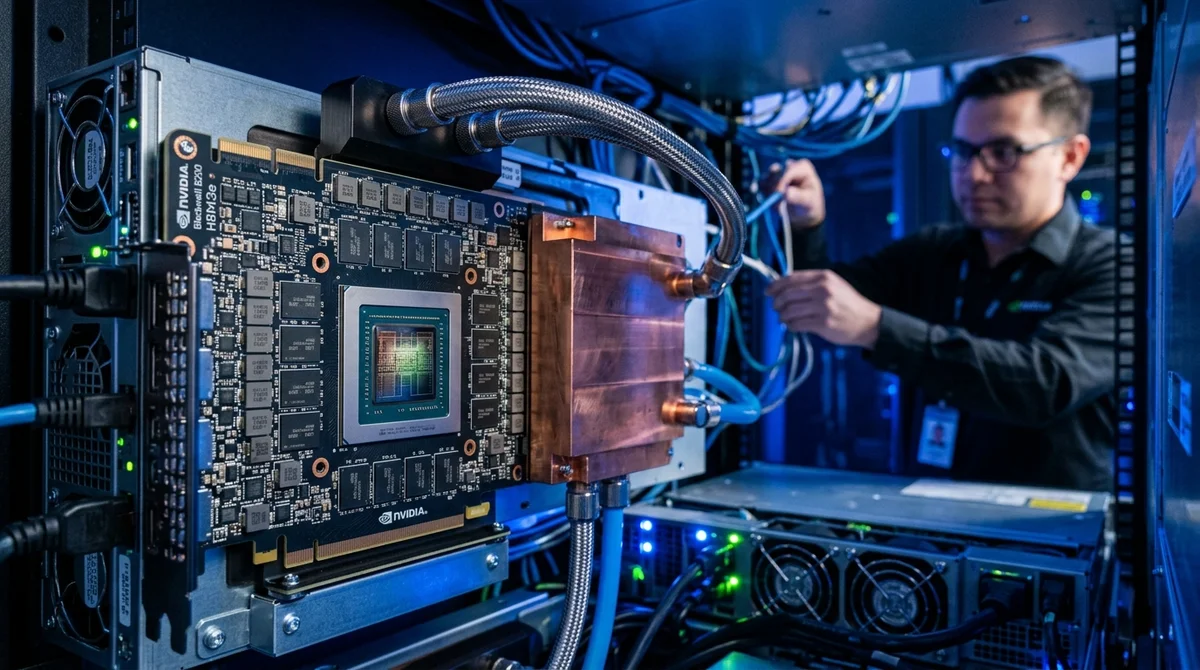
FlashAttention-4 es un rediseño del algoritmo de atención pensado específicamente para las GPU modernas, en las que los núcleos tensoriales mejoran su rendimiento mucho más rápido que la memoria y otros recursos.
Por qué el enfoque estándar ya no funciona
A primera vista, el rendimiento de la atención (attention) depende de la velocidad de dos multiplicaciones de matrices: S = Q × K^T y O = P × V. Pero el análisis de la Blackwell B200 revela algo inesperado: el cuello de botella no está en los núcleos tensoriales, sino en las unidades de funciones especiales (SFU) que calculan la exponencial en el softmax (forward pass) y en el tráfico de la memoria compartida (backward pass). De Hopper (H100) a Blackwell (B200), el rendimiento de los núcleos tensoriales en BF16 pasó de 1 a 2.
25 petaflops, mientras que el número de SFU y el ancho de banda de la memoria compartida se mantuvieron igual. Esta asimetría rompe la optimización estándar: no se puede suponer sin más que los núcleos determinan por completo el rendimiento. En la práctica, se estorban entre sí.
Cómo resolvió el problema Together AI
El equipo de investigación, junto con ingenieros de NVIDIA, Meta* y Princeton, propuso tres ideas clave:
- Nuevo pipelining: cauces por software que solapan al máximo el trabajo de los núcleos tensoriales, la SFU y la memoria, sin tiempos muertos.
- Emulación de la exponencial mediante polinomios: en lugar de la lenta SFU, el forward pass calcula la exponencial en las rápidas unidades FMA (fused multiply-add).
- TMEM y 2-CTA MMA: uso de la nueva memoria tensorial (256 KB por SM) más un modo en el que dos bloques de hilos trabajan sobre una misma operación matricial, lo que reduce el tráfico de la memoria compartida.
Las capacidades de Blackwell que lo hicieron posible
Blackwell incorporó varias funciones pensadas para este tipo de optimizaciones:
La memoria tensorial (TMEM) es un almacenamiento rápido en el chip (256 KB por cada SM), conectado directamente a los núcleos tensoriales. Los resultados intermedios pueden quedarse en la TMEM sin pasar por la más lenta memoria compartida, lo que reduce drásticamente la latencia de acceso.
Núcleos tensoriales asíncronos de 5.ª generación: cada operación la lanza un solo hilo y acumula los resultados en la TMEM. El tile máximo para BF16 es de 128×256×16 (aproximadamente el doble que en Hopper), lo que permite un pipelining más profundo sin desbordar los registros.
2-CTA MMA es un modo nuevo en el que dos bloques de hilos trabajan a la vez sobre una misma operación matricial. Reduce a la mitad la carga sobre la memoria compartida y disminuye el número de operaciones atómicas.
Cifras y resultados
En una Blackwell B200 con BF16, FlashAttention-4 alcanza 1605 TFLOPs/s (71 % de utilización). Es 1.3× más rápido que cuDNN 9.13 y 2.7× más rápido que Triton. Para situarlo: 1605 TFLOPs es casi la mitad del rendimiento máximo de Blackwell, pero se logra exprimiendo un kernel de atención complejo.
Qué significa
FlashAttention-4 muestra cómo trabajar en la era del escalado asimétrico de las GPU: en lugar de apretar tuercas en algoritmos antiguos, rehacerlos junto con las nuevas capacidades del hardware. El resultado parece un logro, pero es solo el comienzo de la adaptación a la nueva realidad del hardware.
*Meta está reconocida como organización extremista y prohibida en Rusia.
- 1 nov 2026La capa de seguridad MoneyGate frenó las 42 peticiones fraudulentas a IA locales
- 31 oct 2026KTMS 1.0, el gateway LLM open source, conecta GPU propias a la nube y resiste fallos de dependencias
- 31 oct 2026LTX-2.5, de 22.000 millones de parámetros, funciona en una RTX 3080 de 10 GB, pero tarda 5 minutos por plano
- 29 oct 2026T-Tech desarrolla LIMe, un método que entrena modelos de lenguaje con un 15% menos de cómputo
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué el enfoque estándar ya no funciona?
A primera vista, el rendimiento de la atención (attention) depende de la velocidad de dos multiplicaciones de matrices: S = Q × K^T y O = P × V. Pero el análisis de la Blackwell B200 revela algo inesperado: el cuello de botella no está en los núcleos tensoriales, sino en las unidades de funciones especiales (SFU) que calculan la exponencial en el softmax (forward pass) y en el tráfico de la memoria compartida (backward pass). De Hopper (H100) a Blackwell (B200), el rendimiento de los núcleos tensoriales en BF16 pasó de 1 a 2.25 petaflops, mientras que el número de SFU y el
Cómo resolvió el problema Together AI?
El equipo de investigación, junto con ingenieros de NVIDIA, Meta y Princeton, propuso tres ideas clave: Nuevo pipelining: cauces por software que solapan al máximo el trabajo de los núcleos tensoriales, la SFU y la memoria, sin tiempos muertos. Emulación de la exponencial mediante polinomios: en lugar de la lenta SFU, el forward pass calcula la exponencial en las rápidas unidades FMA (fused multiply-add). TMEM y 2-CTA MMA: uso de la nueva memoria tensorial (256 KB por SM) más un modo en el que dos bloques de hilos trabajan sobre una misma operación matricial, lo que reduce
¿Qué se sabe sobre Las capacidades de Blackwell que lo hicieron posible?
Blackwell incorporó varias funciones pensadas para este tipo de optimizaciones: La memoria tensorial (TMEM) es un almacenamiento rápido en el chip (256 KB por cada SM), conectado directamente a los núcleos tensoriales. Los resultados intermedios pueden quedarse en la TMEM sin pasar por la más lenta memoria compartida, lo que reduce drásticamente la latencia de acceso. Núcleos tensoriales asíncronos de 5.ª generación: cada operación la lanza un solo hilo y acumula los resultados en la TMEM. El tile máximo para BF16 es de 128×256×16 (aproximadamente el doble que en Hopper), l
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.