Usar ChatGPT en ruso cuesta el doble: la culpa es de la tokenización
En ChatGPT y otros LLM en la nube, procesar texto en ruso cuesta 2 veces más que hacerlo en inglés. La causa está en cómo las redes neuronales dividen el texto en tokens. Una palabra en inglés suele ocupar un solo token, mientras que una en ruso necesita 2-4 fragmentos. Como consecuencia, la ventana de contexto se reduce a la mitad.
Procesado por IA desde Habr AI; editado por Hamidun News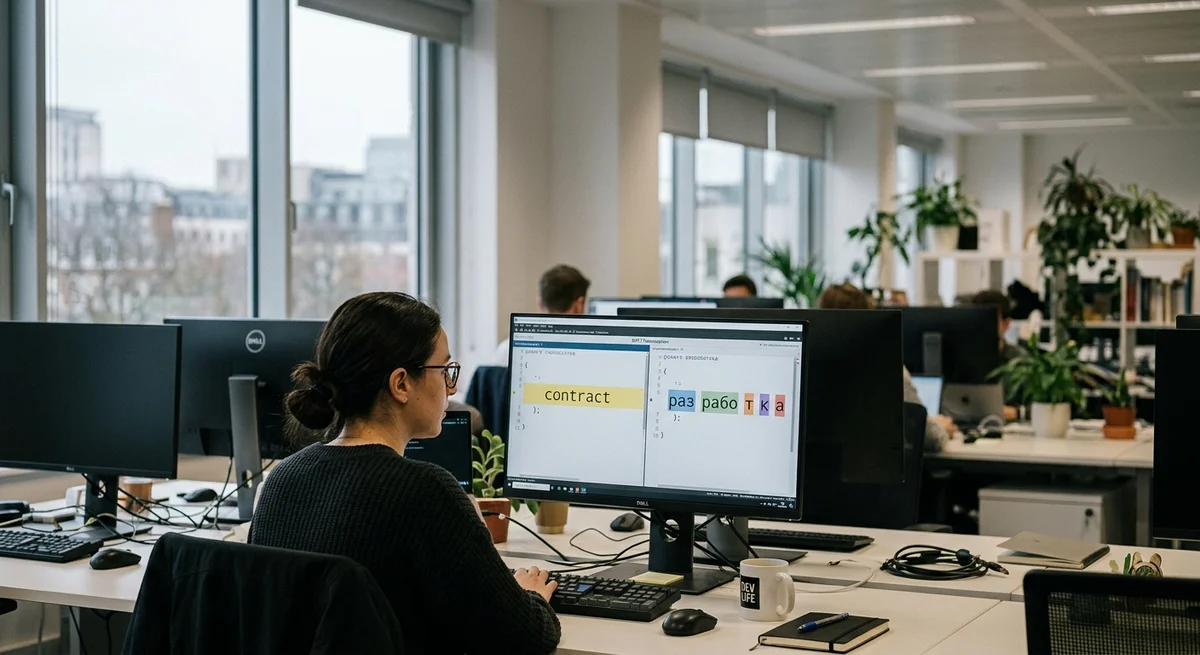
Cuando envías una petición a ChatGPT o a otra red neuronal en la nube, el modelo no trabaja directamente con letras ni palabras. Primero divide el texto en tokens, pequeños fragmentos de significado que puede procesar. De esa división dependen el coste de la petición, la velocidad de la respuesta y la cantidad de información que cabe de una vez en la ventana de contexto.
Cómo funciona la tokenización
La tokenización es el proceso con el que las redes neuronales trocean el texto, y cada una lo hace de forma distinta. El texto en inglés se divide de manera muy eficiente: una palabra suele ocupar uno o dos tokens. La palabra «contract» es siempre un solo token. Un texto en inglés de 1000 palabras requiere aproximadamente 1200-1500 tokens.
El ruso no tiene tanta suerte: el mismo contenido necesita 2-3 veces más fragmentos. La palabra «разработка» («desarrollo») necesita dos o tres tokens. «Программирование» («programación»), entre tres y cuatro. Y un adjetivo como «искусственный» («artificial») puede ocupar cuatro o cinco tokens. Un texto en ruso de 1000 palabras requiere ya 2500-3500 tokens.
Esto ocurre porque en el entrenamiento de los grandes modelos de lenguaje actuales se usó el inglés con mucha más intensidad que el ruso. Su léxico está mejor representado en el vocabulario de tokens, que los creadores del modelo construyeron a partir de enormes volúmenes de contenido en inglés. Para las redes neuronales, el cirílico sigue siendo un extranjero.
Lo que cuesta en la práctica
Por esta desigualdad en la tokenización, en servicios en la nube como OpenAI el texto en ruso cuesta aproximadamente 2 veces más que el inglés para la misma cantidad de información real. Si pagas 1 dólar por procesar 1000 tokens de texto en inglés, el ruso te costará 2 dólares.
Donde más se nota es en los proyectos grandes: localizar una aplicación al ruso, traducir documentación o mantener un chatbot en ruso cuesta el doble que esos mismos servicios para un usuario angloparlante.
Pero el precio es solo el principio de los problemas. El procesamiento del texto en ruso es notablemente más lento, porque el modelo tiene que procesar más tokens. Cuantos más tokens, más tarda en llegar la respuesta. Y la ventana de contexto, es decir, la memoria en la que el modelo puede retener información, se reduce a la mitad en contenido real. Si un modelo tiene una ventana de contexto de 128 mil tokens, en ruso solo podrás meter la mitad de información.
A quién afecta especialmente
- Desarrolladores rusohablantes que usan AI para trabajar con documentación y código
- Empresas que procesan grandes volúmenes de texto en ruso (traducciones, chatbots, analítica)
- Startups en ruso que construyen productos basados en LLM y no pueden permitirse los costes de OpenAI
- Investigadores que trabajan con el idioma ruso y necesitan análisis en profundidad mediante redes neuronales
- Autores y editores que quieren usar AI para editar y reescribir textos
Cómo medirlo con tus propios datos
El autor del artículo recomienda comprobar la proporción real de tokens con tus propios textos: toma una muestra en inglés y otra en ruso, cuenta los tokens con la API de OpenAI y compáralos. Lleva unos cinco minutos y te mostrará el precio exacto para tu caso.
Qué significa
La desigualdad en la tokenización es un impuesto oculto sobre el ruso en la era de los grandes modelos de lenguaje. No se trata de un error de los desarrolladores, sino de una consecuencia natural de cómo se construyeron estos modelos: con el contenido en inglés de la primera generación de internet.
Para la comunidad rusohablante, esto supone aceptar la realidad: o pagar más y recibir respuestas más lentas, o buscar alternativas entrenadas con un mejor soporte para el cirílico.
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Google admite que AI Mode reduce los ingresos de su buscador: las acciones caen un 15%
- 31 oct 2026Un autor sometió su guion a un jurado de IA: el veredicto costó 850 000 tokens
- 31 oct 2026Anthropic: fusionar subagentes en un solo bucle duplicó la velocidad de las tareas de un cliente
Preguntas frecuentes sobre la noticia
Cómo funciona la tokenización?
La tokenización es el proceso con el que las redes neuronales trocean el texto, y cada una lo hace de forma distinta. El texto en inglés se divide de manera muy eficiente: una palabra suele ocupar uno o dos tokens. La palabra «contract» es siempre un solo token. Un texto en inglés de 1000 palabras requiere aproximadamente 1200-1500 tokens. El ruso no tiene tanta suerte: el mismo contenido necesita 2-3 veces más fragmentos. La palabra «разработка» («desarrollo») necesita dos o tres tokens. «Программирование» («programación»), entre tres y cuatro. Y un adjetivo como «искусств
¿Qué se sabe sobre Lo que cuesta en la práctica?
Por esta desigualdad en la tokenización, en servicios en la nube como OpenAI el texto en ruso cuesta aproximadamente 2 veces más que el inglés para la misma cantidad de información real. Si pagas 1 dólar por procesar 1000 tokens de texto en inglés, el ruso te costará 2 dólares. Donde más se nota es en los proyectos grandes: localizar una aplicación al ruso, traducir documentación o mantener un chatbot en ruso cuesta el doble que esos mismos servicios para un usuario angloparlante. Pero el precio es solo el principio de los problemas. El procesamiento del texto en ruso es no
¿Qué se sabe sobre A quién afecta especialmente?
Desarrolladores rusohablantes que usan AI para trabajar con documentación y código Empresas que procesan grandes volúmenes de texto en ruso (traducciones, chatbots, analítica) Startups en ruso que construyen productos basados en LLM y no pueden permitirse los costes de OpenAI Investigadores que trabajan con el idioma ruso y necesitan análisis en profundidad mediante redes neuronales Autores y editores que quieren usar AI para editar y reescribir textos
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.