Mira Murati presenta el primer sistema de diálogo natural con IA en tiempo real
El laboratorio de Mira Murati, Thinking Machines, ha presentado TML-Interaction-Small, un modelo de 276.000 millones de parámetros. El sistema procesa audio, vídeo y texto de forma simultánea, en fragmentos de 200 milisegundos. Por primera vez, una IA puede escuchar al usuario y responder en paralelo, sin congelar la percepción. Es un paso hacia un diálogo natural con la inteligencia artificial.
Procesado por IA desde MarkTechPost; editado por Hamidun News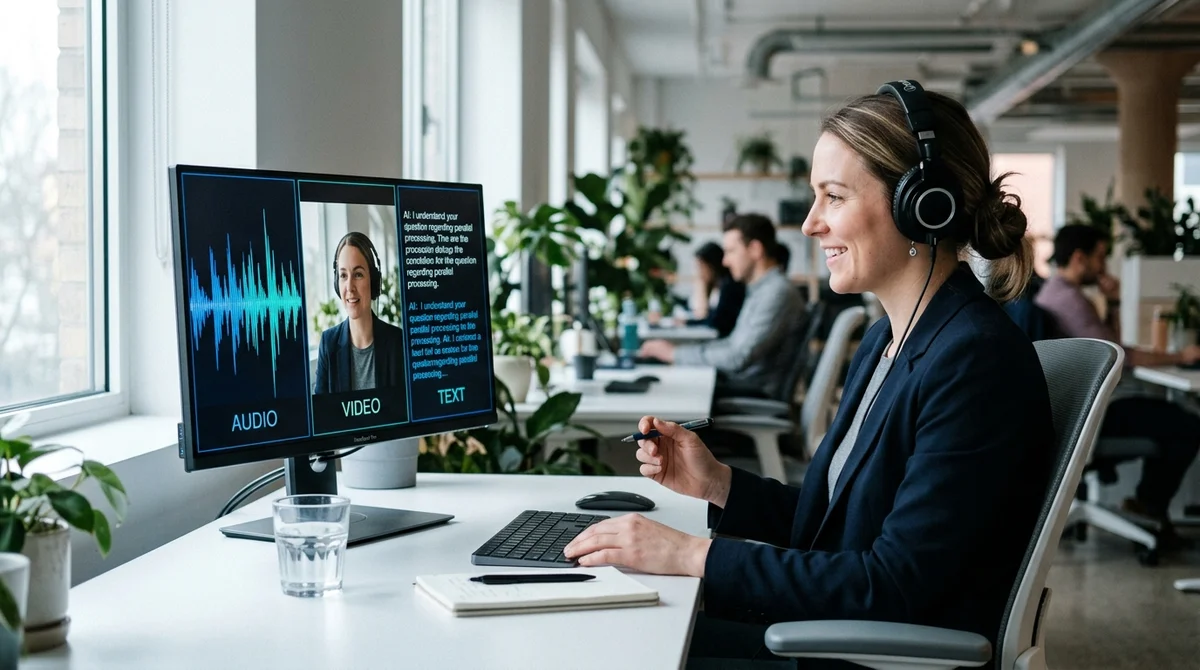
Pensar y escuchar al mismo tiempo es algo que la mayoría de los sistemas de IA no ha podido hacer hasta ahora. Thinking Machines Lab, el laboratorio de Mira Murati, ha mostrado un primer prototipo que cambia esa regla. El modelo TML-Interaction-Small funciona como una conversación real entre personas: te escucha y prepara su respuesta en el mismo momento.
Cómo funciona la arquitectura multiflujo
TML-Interaction-Small es un modelo de 276.000 millones de parámetros, de los cuales solo 12.000 millones están activos (formato Mixture-of-Experts). La principal diferencia arquitectónica: el sistema procesa audio, vídeo y texto de forma simultánea, en un único flujo de datos. Todos los datos de entrada se dividen en fragmentos de 200 milisegundos, justo lo necesario para que el modelo siga sincronizado con una conversación real y no se quede atrás respecto al ritmo del habla humana.
Otro detalle: el sistema funciona sin módulos externos de detección de voz (voice-activity detection). Estos módulos suelen ser un cuello de botella, porque añaden latencia y complican la arquitectura. Aquí todo está integrado en la propia red neuronal. Así se eliminan retrasos innecesarios y el sistema responde mucho mejor y resulta más natural.
Motores paralelos para tareas distintas
El sistema trabaja con dos componentes en paralelo. El primero, un real-time interaction model, se encarga del diálogo en vivo con el usuario y ofrece un intercambio de información full-duplex (puedes interrumpir al sistema y hablar a la vez). El segundo, un asynchronous background model, piensa mientras tanto en segundo plano, trabaja con herramientas externas y bases de datos, y siempre tiene acceso completo al contexto de la conversación.
- El primer motor se encarga de las respuestas rápidas en tiempo real
- El segundo motor aporta razonamiento profundo y operaciones complejas
- Ambos componentes ven y comprenden el contexto completo de toda la conversación
- La percepción no se congela mientras se genera la respuesta
- La información se procesa en un flujo continuo, no en etapas separadas
Del procesamiento secuencial al paralelo
Casi todos los asistentes de IA actuales funcionan con un esquema secuencial: terminas de hablar → el sistema congela la percepción → procesa las palabras → entrega una respuesta ya terminada. TML-Interaction-Small rompe esa lógica. Escucha al usuario y prepara la respuesta al mismo tiempo, como en una conversación real entre dos personas.
Este enfoque requiere una arquitectura completamente distinta. En lugar de momentos discretos, el sistema trata los datos multimodales como un flujo continuo. Eso permite al modelo captar la entonación, las pausas, las emociones y el contexto de la conversación. Como resultado, el asistente de IA no parece robótico, sino un interlocutor vivo.
Qué significa para la interacción
Es el primer paso práctico hacia un diálogo verdaderamente natural entre humanos e IA. En lugar de esperar la siguiente respuesta, podrás interrumpir, precisar y discutir, e interactuar como con un consultor real. Para las empresas, esto abre nuevas posibilidades para crear asistentes que parezcan vivos y no fríos y distantes.
Preguntas frecuentes sobre la noticia
Cómo funciona la arquitectura multiflujo?
TML-Interaction-Small es un modelo de 276.000 millones de parámetros, de los cuales solo 12.000 millones están activos (formato Mixture-of-Experts). La principal diferencia arquitectónica: el sistema procesa audio, vídeo y texto de forma simultánea, en un único flujo de datos. Todos los datos de entrada se dividen en fragmentos de 200 milisegundos, justo lo necesario para que el modelo siga sincronizado con una conversación real y no se quede atrás respecto al ritmo del habla humana. Otro detalle: el sistema funciona sin módulos externos de detección de voz (voice-activity
¿Qué se sabe sobre Motores paralelos para tareas distintas?
El sistema trabaja con dos componentes en paralelo. El primero, un real-time interaction model, se encarga del diálogo en vivo con el usuario y ofrece un intercambio de información full-duplex (puedes interrumpir al sistema y hablar a la vez). El segundo, un asynchronous background model, piensa mientras tanto en segundo plano, trabaja con herramientas externas y bases de datos, y siempre tiene acceso completo al contexto de la conversación. El primer motor se encarga de las respuestas rápidas en tiempo real El segundo motor aporta razonamiento profundo y operaciones comple
¿Qué se sabe sobre Del procesamiento secuencial al paralelo?
Casi todos los asistentes de IA actuales funcionan con un esquema secuencial: terminas de hablar → el sistema congela la percepción → procesa las palabras → entrega una respuesta ya terminada. TML-Interaction-Small rompe esa lógica. Escucha al usuario y prepara la respuesta al mismo tiempo, como en una conversación real entre dos personas. Este enfoque requiere una arquitectura completamente distinta. En lugar de momentos discretos, el sistema trata los datos multimodales como un flujo continuo. Eso permite al modelo captar la entonación, las pausas, las emociones y el cont
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.