Cómo BERTopic con un LLM local ayuda a Rostelecom a analizar grandes volúmenes de texto
Un desarrollador de NLP de Rostelecom ha presentado un pipeline de BERTopic que automatiza por completo el análisis de grandes volúmenes de texto: reseñas, solicitudes de soporte, comentarios y redes sociales. La mejora clave es un modelo de lenguaje local integrado que genera nombres de temas interpretables sin enviar datos a la nube, lo que preserva la confidencialidad. En la práctica, el método reduce el trabajo manual de varias semanas a unas pocas horas.
Procesado por IA desde Habr AI; editado por Hamidun News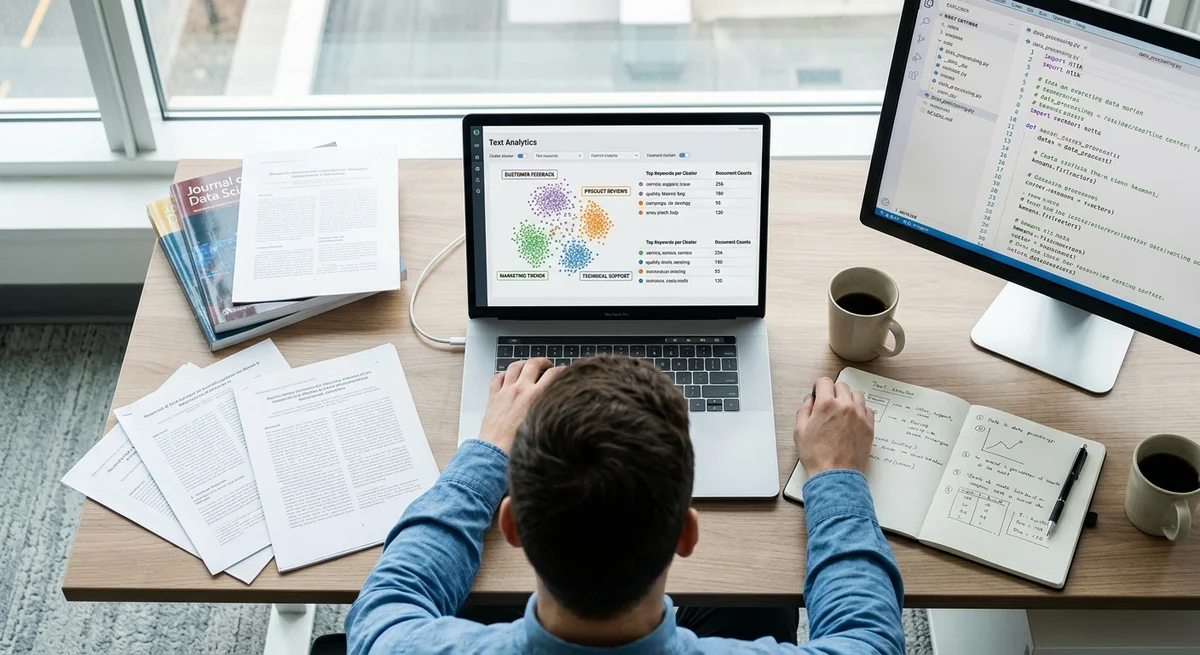
Automatizar el análisis de textos es una de las tareas más laboriosas e infravaloradas del NLP. Cuando una empresa recibe decenas de miles de reseñas, solicitudes de soporte o comentarios al día, la categorización manual no solo es imposible, sino también absurda desde el punto de vista del ROI. Anton, ingeniero de NLP de Rostelecom, ha propuesto una solución: un pipeline basado en BERTopic con un LLM local integrado para obtener nombres de temas interpretables.
Por qué automatizar el análisis de textos
Los grandes volúmenes de texto son una mina de oro de datos no estructurados para cualquier empresa. En las reseñas se esconden quejas sobre errores y defectos concretos, en las solicitudes de soporte se ven problemas sistémicos y puntos débiles, y en los comentarios de redes sociales hay ideas para nuevas funciones y productos. Pero ni siquiera un equipo pequeño de analistas puede revisar todo esto a mano en un día ni en una semana.
El enfoque clásico consiste en leer cada texto manualmente, entender su esencia y repartirlo por categorías. Con volúmenes de 10 000 textos o más, resulta económicamente inviable, agotador para el especialista y lento. A ello se suma la subjetividad: un analista clasifica una queja como "problemas de red", otro como "calidad del servicio" y un tercero como "otros". Se pierde la coherencia y las conclusiones dejan de ser fiables.
Cómo BERTopic resuelve el problema del clustering
BERTopic es un framework que combina varias técnicas de aprendizaje automático para encontrar temas en los textos de forma automática. El proceso funciona así:
- Embeddings (BERT): cada texto se convierte en un vector de números (embedding), de modo que los textos semánticamente similares quedan cerca en un espacio multidimensional. Para texto en ruso se puede usar ruBERT u otros modelos.
- Clustering (HDBSCAN): un algoritmo rápido encuentra agrupaciones naturales de textos en ese espacio, sin necesidad de conocer de antemano el número de temas.
- Interpretación: BERTopic genera el nombre de cada clúster a partir de TF-IDF, es decir, las palabras más significativas del grupo.
¿El resultado? Del caos de 50 000 textos salen, por ejemplo, 15 temas claros y naturales: "problemas con internet", "consultas de facturación", "errores en la aplicación móvil", "solicitudes de beneficios", etcétera.
Pero hay un inconveniente. La interpretación estándar de BERTopic suele dar nombres raros como "абонент_услуга_номер" o "бага_баг_ошибка" (algo así como "abonado_servicio_número" y "fallo_bug_error"), difíciles de explicar al negocio. Aquí entra el modelo de lenguaje.
Integrar un LLM local para la interpretación
En lugar de elegir palabras del clúster de forma mecánica, un modelo de lenguaje local (por ejemplo, Mistral 7B o Llama 2) lee las palabras principales y los documentos principales del clúster y genera una descripción completa en ruso: "Los clientes se quejan de la lentitud de internet en zonas rurales, sobre todo los fines de semana".
"Integrar un LLM local protege la confidencialidad de los datos: todos los datos actuales permanecen en la empresa, sin enviarse a OpenAI, a la API de Claude ni a otros servicios en la nube.
Es crítico para empresas que trabajan con información sensible", subraya Anton.
Además, el modelo local funciona más rápido que las peticiones a una API y es totalmente independiente de cuotas, límites y del coste por token procesado. El pipeline funciona sin internet, lo que reduce la latencia y aumenta la fiabilidad del sistema.
Resultado práctico y escalado
El pipeline de Rostelecom permite hacer en unas horas lo que antes requería varias semanas de trabajo manual:
1. Cargar un conjunto de textos en BERTopic (pueden ser miles o decenas de miles de registros) 2. Obtener clústeres listos con descripciones de temas generadas por el LLM, en un lenguaje comprensible para el negocio 3. Exportar los resultados a Excel, CSV o una base de datos para que sigan trabajando con ellos analistas y product managers
Además, es reutilizable: ¿ha llegado un nuevo lote a soporte? El pipeline se reentrena en minutos y vuelve a entregar un resultado estructurado.
Qué significa para la industria del NLP
Las herramientas de NLP salen del laboratorio y de los artículos científicos hacia producción real. Cuando un solo ingeniero puede montar en un día un pipeline completo que antes exigía dos o tres semanas de trabajo manual y la experiencia de un equipo entero, el NLP pasa a ser una herramienta práctica y no un experimento científico al alcance solo de las grandes empresas de TI.
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Kimi logra un 96,2 % en un test de analítica sobre una base de 1C y se perfila como plan B ante un bloqueo de Claude
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Google admite que AI Mode reduce los ingresos de su buscador: las acciones caen un 15%
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué automatizar el análisis de textos?
Los grandes volúmenes de texto son una mina de oro de datos no estructurados para cualquier empresa. En las reseñas se esconden quejas sobre errores y defectos concretos, en las solicitudes de soporte se ven problemas sistémicos y puntos débiles, y en los comentarios de redes sociales hay ideas para nuevas funciones y productos. Pero ni siquiera un equipo pequeño de analistas puede revisar todo esto a mano en un día ni en una semana. El enfoque clásico consiste en leer cada texto manualmente, entender su esencia y repartirlo por categorías. Con volúmenes de 10 000 textos o
Cómo BERTopic resuelve el problema del clustering?
BERTopic es un framework que combina varias técnicas de aprendizaje automático para encontrar temas en los textos de forma automática. El proceso funciona así: Embeddings (BERT): cada texto se convierte en un vector de números (embedding), de modo que los textos semánticamente similares quedan cerca en un espacio multidimensional. Para texto en ruso se puede usar ruBERT u otros modelos. Clustering (HDBSCAN): un algoritmo rápido encuentra agrupaciones naturales de textos en ese espacio, sin necesidad de conocer de antemano el número de temas. Interpretación: BERTopic genera
¿Qué se sabe sobre Integrar un LLM local para la interpretación?
En lugar de elegir palabras del clúster de forma mecánica, un modelo de lenguaje local (por ejemplo, Mistral 7B o Llama 2) lee las palabras principales y los documentos principales del clúster y genera una descripción completa en ruso: "Los clientes se quejan de la lentitud de internet en zonas rurales, sobre todo los fines de semana". "Integrar un LLM local protege la confidencialidad de los datos: todos los datos actuales permanecen en la empresa, sin enviarse a OpenAI, a la API de Claude ni a otros servicios en la nube. Es crítico para empresas que trabajan con informaci
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.