KDnuggets publica una guía para analizar llamadas en local con Whisper, BERTopic y Streamlit
KDnuggets ha mostrado cómo montar un analizador local de llamadas de clientes sin APIs en la nube. La combinación usa Whisper para transcribir el audio, RoBERTa de Hugging Face para sentimiento y emociones, BERTopic para los temas y Streamlit para el panel. El proyecto se ejecuta en la propia máquina y requiere Python 3.9+, FFmpeg y unos 1,5–2 GB para los modelos.
Procesado por IA desde KDnuggets; editado por Hamidun News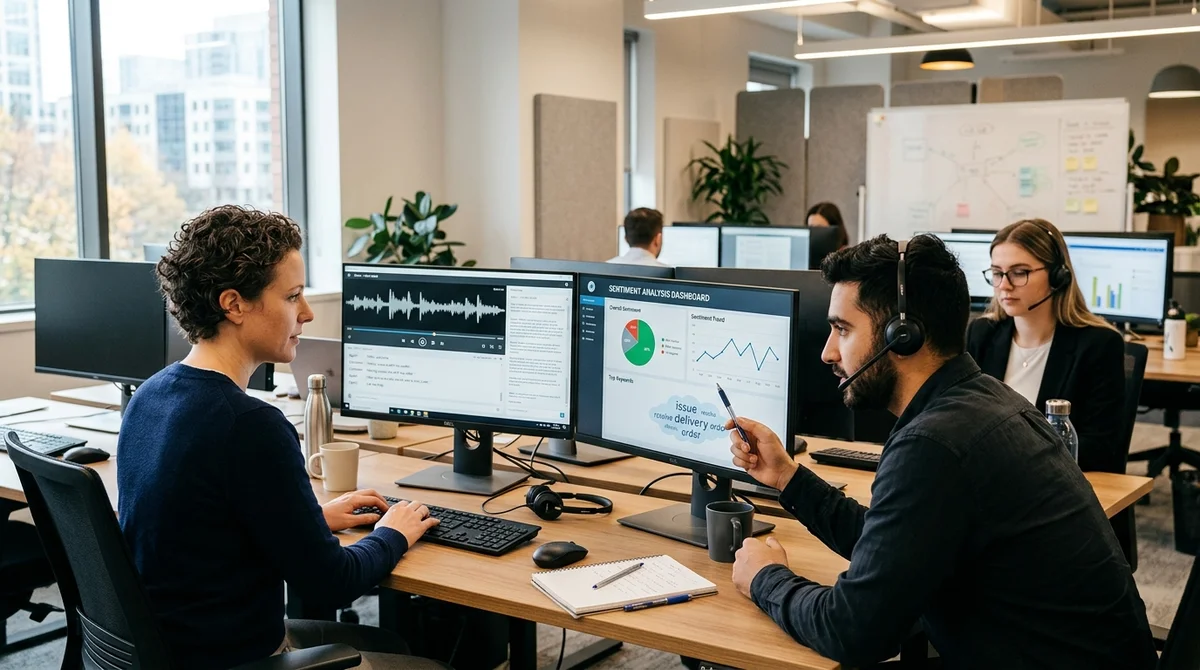
El 17 de abril de 2026, KDnuggets publicó un análisis paso a paso de una herramienta de código abierto para analizar llamadas de clientes. El proyecto monta un pipeline local: Whisper transcribe el audio, los modelos de Transformers detectan sentimiento y emociones, y BERTopic encuentra temas recurrentes sin enviar las grabaciones a APIs externas.
Cómo funciona el stack
El artículo se construye en torno a un esquema modular sencillo que se puede replicar en un equipo corriente. Primero, Whisper convierte la grabación de la llamada en texto y la divide en segmentos con marcas de tiempo. El autor usa la versión base o small del modelo como compromiso entre velocidad y calidad.
Después, la transcripción pasa al modelo cardiffnlp/twitter-roberta-base-sentiment-latest, que calcula las probabilidades de positive, neutral y negative y luego devuelve una etiqueta final y una puntuación compound de menos uno a más uno. A continuación, BERTopic agrupa las conversaciones por significado y extrae temas clave, como problemas de facturación, de entrega o de soporte técnico.
Por separado, el autor explica por qué el tema y el sentimiento resuelven problemas distintos. El sentimiento responde a si la experiencia fue buena o mala, mientras que las emociones muestran qué siente exactamente el cliente: irritación, urgencia, satisfacción. Para los temas se usa una combinación de sentence-transformers, UMAP, HDBSCAN y c-TF-IDF.
Un detalle práctico importante: la extracción de temas no empieza a funcionar bien con una sola llamada, sino con un conjunto de al menos cinco a diez transcripciones, donde ya se aprecian patrones repetidos.
Por qué ejecutarlo en local
La idea central del artículo no es hacer otro proyecto de demostración de NLP, sino mostrar un escenario empresarial útil sin depender de APIs en la nube. Para los centros de llamadas, esto se reduce a privacidad, coste y requisitos de almacenamiento de datos. Tras la primera descarga de los modelos, que ocupa aproximadamente 1,5 GB, el sistema puede funcionar sin conexión. Para empezar hacen falta Python 3.9+, FFmpeg para procesar el audio y unos 2 GB de espacio en disco, de modo que la barrera de entrada es bastante baja incluso para un equipo pequeño.
«La principal ventaja es que todo funciona en local y los datos
sensibles de los clientes no salen de tu máquina».
El artículo lo presenta como un argumento no solo de seguridad, sino también de costes predecibles. No hay pago por cada llamada a la API, ni límites del proveedor, ni riesgo de tener que entregar otra grabación de cliente a una infraestructura externa.
El autor también compara los transformers con métodos antiguos basados en diccionarios, como VADER: los modelos simples pueden equivocarse con frases que contienen negación, mientras que un transformer entiende mejor el contexto del habla coloquial, algo especialmente importante en quejas reales y formulaciones ambiguas.
Qué muestra el panel
La capa final del proyecto es una interfaz en Streamlit con gráficos de Plotly, orientada no al ingeniero de ML, sino a un gerente o analista. Permite subir varios archivos mp3 o wav, esperar el procesamiento y ver de inmediato un resumen de las llamadas. Para acelerar, se usa el almacenamiento en caché de recursos, de modo que los modelos pesados no se recarguen con cada acción en la interfaz.
Hay varios modos de ejecución: una demo sin audio, el análisis de un solo archivo, el procesamiento por lotes de un directorio y el panel completo en el navegador.
- Carga de archivos de audio y procesamiento por lotes
- Transcripción con resaltado del sentimiento
- Línea temporal de emociones para conversaciones largas
- Visualización de temas y distribución de las llamadas por clústeres
- Acceso a una conversación concreta
En esencia, es una base lista para servicios internos de soporte, analítica de producto y control de calidad de operadores. Un equipo puede tomar el repositorio, cambiar los datos de entrada, reentrenar o sustituir los modelos y obtener rápidamente una herramienta aplicada en lugar de un cuaderno abstracto. Ahí está el valor del artículo: no debate sobre el futuro de los sistemas agénticos, sino que muestra un escenario concreto y reproducible en el que una pila de código abierto ya resuelve un problema de negocio.
Qué significa
Publicaciones como esta muestran la rapidez con que las herramientas de IA pasan del experimento a la práctica de los equipos de operaciones. Si antes el análisis de llamadas solía requerir un servicio SaaS y procesamiento externo de datos, ahora se puede montar un sistema básico en local, de forma transparente y sin grandes presupuestos de API.
Preguntas frecuentes sobre la noticia
Cómo funciona el stack?
El artículo se construye en torno a un esquema modular sencillo que se puede replicar en un equipo corriente. Primero, Whisper convierte la grabación de la llamada en texto y la divide en segmentos con marcas de tiempo. El autor usa la versión base o small del modelo como compromiso entre velocidad y calidad. Después, la transcripción pasa al modelo cardiffnlp/twitter-roberta-base-sentiment-latest, que calcula las probabilidades de positive, neutral y negative y luego devuelve una etiqueta final y una puntuación compound de menos uno a más uno. A continuación, BERTopic agru
¿Qué se sabe sobre Por qué ejecutarlo en local?
La idea central del artículo no es hacer otro proyecto de demostración de NLP, sino mostrar un escenario empresarial útil sin depender de APIs en la nube. Para los centros de llamadas, esto se reduce a privacidad, coste y requisitos de almacenamiento de datos. Tras la primera descarga de los modelos, que ocupa aproximadamente 1,5 GB, el sistema puede funcionar sin conexión. Para empezar hacen falta Python 3.9+, FFmpeg para procesar el audio y unos 2 GB de espacio en disco, de modo que la barrera de entrada es bastante baja incluso para un equipo pequeño. «La principal venta
¿Qué se sabe sobre Qué muestra el panel?
La capa final del proyecto es una interfaz en Streamlit con gráficos de Plotly, orientada no al ingeniero de ML, sino a un gerente o analista. Permite subir varios archivos mp3 o wav, esperar el procesamiento y ver de inmediato un resumen de las llamadas. Para acelerar, se usa el almacenamiento en caché de recursos, de modo que los modelos pesados no se recarguen con cada acción en la interfaz. Hay varios modos de ejecución: una demo sin audio, el análisis de un solo archivo, el procesamiento por lotes de un directorio y el panel completo en el navegador. Carga de archivos
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.