Un desarrollador crea un agregador de noticias con IA basado en MCP, DeepSeek y un bot de Telegram
El proyecto nació de una carencia real: la falta de noticias rápidas durante el ataque con drones sobre Dubái del 28 de febrero de 2026. El desarrollador lanzó un agregador con más de 80+ fuentes y traducción automática, un servidor MCP para asistentes de IA, un chat basado en DeepSeek y un bot de Telegram. El parseo de RSS funciona como un servicio independiente. Para el etiquetado, el autor descartó los LLM y optó por keyword matching, con una precisión de alrededor del 85%.
Procesado por IA desde Habr AI; editado por Hamidun News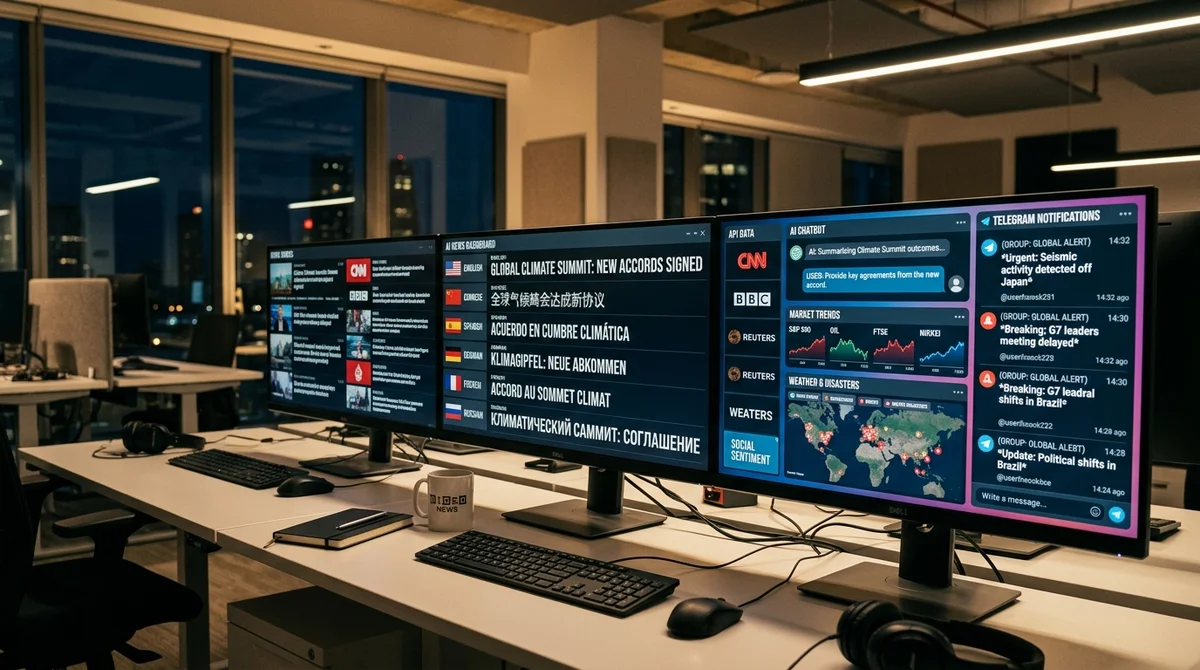
El origen de este proyecto fue un problema concreto y no una idea abstracta. El 28 de febrero de 2026, el autor estaba en Dubái durante la interceptación de drones iraníes y no logró hacerse rápidamente una imagen completa de lo que ocurría. De ahí surgió un agregador de noticias multilingüe que recopila, traduce y etiqueta noticias, y las entrega tanto a personas como a asistentes de IA.
Cómo surgió el proyecto
El autor describe el punto de partida de forma muy terrenal: en Google y Yandex aparecían artículos de hacía dos horas, y los canales de Telegram ofrecían versiones contradictorias de los hechos. Cuando las noticias se necesitan en ese mismo momento, ese retraso deja de ser una pequeña molestia y se convierte en un problema real. La primera solución fue sencilla: un canal de Telegram sobre Oriente Medio al que llegaban manualmente los feeds RSS de las grandes agencias internacionales.
El modo manual pronto chocó con el volumen. El flujo creció hasta más de 200+ publicaciones al día, y mantenerlo sin automatización dejó de tener sentido. Primero llegó un parser, luego la traducción automática y después se sumaron fuentes de IT y la agenda económica. Al final, la idea local de un canal informativo inmediato se convirtió en un producto completo: un sitio agregador con feed de noticias, chat con IA, API, servidor MCP y un bot de Telegram independiente.
Qué hay dentro del sistema
El proyecto está construido como un conjunto de componentes independientes, no como un monolito. Un servicio aparte, FeedManager, recoge los RSS, procesa los feeds y escribe los datos en MySQL. La parte en Flask lee artículos ya preparados y no depende de que el parser se haya quedado colgado en alguna fuente inestable. El etiquetado automático funciona como un proceso autónomo: lee los materiales recientes de la base de datos y escribe de vuelta los resultados, mientras que el bot de Telegram atiende a los usuarios en su propio circuito.
- 80+ fuentes en un único flujo, incluidas agencias internacionales, medios de IT y publicaciones económicas
- 9 categorías temáticas y unas 50 etiquetas para navegar por el feed
- traducción automática de los materiales al ruso justo después de su publicación
- REST API con búsqueda y filtros por etiquetas, fechas y fuentes
- Servidor MCP, que permite a los asistentes de IA trabajar con la base de noticias como una herramienta
Sobre el agregador funcionan la API y un servidor MCP para clientes externos y agentes de IA. El detalle clave es que, en lugar de devolver JSON en bruto, ofrece respuestas estructuradas mediante modelos Pydantic como ArticleSummary y SearchResult. Esto reduce los errores de procesamiento y ahorra tokens. Según la idea del autor, el asistente puede encontrar por sí mismo la etiqueta adecuada, solicitar artículos de los últimos días, leer los textos completos y elaborar un resumen sin preparación manual de datos. Las herramientas se cargan dinámicamente cada cinco minutos, de modo que se pueden añadir nuevas funciones sin reescribir la lógica del agente.
Por qué sin IA innecesaria
En este proyecto la IA no se usa en todas partes, sino solo donde realmente compensa. Para la interfaz de chat se eligió DeepSeek: según el autor, es entre 15 y 30 veces más barato que las alternativas, con una calidad comparable para buscar y resumir noticias. Para un producto gratuito, esto es crítico. El mismo pragmatismo se aprecia en el almacenamiento de las traducciones: las versiones multilingües de cada artículo se guardan directamente en un campo JSON del registro, lo que acelera el acceso y facilita la ampliación a nuevos idiomas.
El compromiso más revelador es el etiquetado automático. En lugar de un LLM, el autor recurrió a keyword matching sobre 47 temas y unas 600 palabras clave en inglés y ruso. Este enfoque ofrece alrededor de un 85% de precisión, tarda menos de un milisegundo por artículo y no consume ningún token. Frente a la moda generalizada de «meter una red neuronal en cada fase», parece una postura de ingeniería madura: la IA hace falta donde aporta valor, no donde simplemente queda bien.
Qué significa esto
Este caso muestra bien que hoy un producto de noticias con IA va mucho más allá de un modelo capaz de resumir textos. El valor real aparece cuando hay una recopilación de datos fiable, una estructura sólida, una API clara y un protocolo como MCP para conectar asistentes. Para medios, equipos de investigación y servicios internos de análisis, la señal es clara: un feed corriente puede convertirse en una infraestructura operativa para resúmenes en tiempo real, búsquedas y respuestas automatizadas.
- 1 nov 2026Prueba de 16 modelos en 7 buscadores: Exa obtuvo una media de 10,5 puntos de 14; SearXNG, en torno a 3
- 1 nov 2026La capa de seguridad MoneyGate frenó las 42 peticiones fraudulentas a IA locales
- 31 oct 2026DeepSeek-V4.1-Flash reduce el KV-caché en HBM a 890 bytes por token, frente a 3514
- 30 oct 2026Mistral abre los pesos de Large 4: destaca en código, pero los modelos chinos logran 32 puntos frente a 26
Preguntas frecuentes sobre la noticia
Cómo surgió el proyecto?
El autor describe el punto de partida de forma muy terrenal: en Google y Yandex aparecían artículos de hacía dos horas, y los canales de Telegram ofrecían versiones contradictorias de los hechos. Cuando las noticias se necesitan en ese mismo momento, ese retraso deja de ser una pequeña molestia y se convierte en un problema real. La primera solución fue sencilla: un canal de Telegram sobre Oriente Medio al que llegaban manualmente los feeds RSS de las grandes agencias internacionales. El modo manual pronto chocó con el volumen. El flujo creció hasta más de 200+ publicacione
¿Qué se sabe sobre Qué hay dentro del sistema?
El proyecto está construido como un conjunto de componentes independientes, no como un monolito. Un servicio aparte, FeedManager, recoge los RSS, procesa los feeds y escribe los datos en MySQL. La parte en Flask lee artículos ya preparados y no depende de que el parser se haya quedado colgado en alguna fuente inestable. El etiquetado automático funciona como un proceso autónomo: lee los materiales recientes de la base de datos y escribe de vuelta los resultados, mientras que el bot de Telegram atiende a los usuarios en su propio circuito. 80+ fuentes en un único flujo, incl
¿Qué se sabe sobre Por qué sin IA innecesaria?
En este proyecto la IA no se usa en todas partes, sino solo donde realmente compensa. Para la interfaz de chat se eligió DeepSeek: según el autor, es entre 15 y 30 veces más barato que las alternativas, con una calidad comparable para buscar y resumir noticias. Para un producto gratuito, esto es crítico. El mismo pragmatismo se aprecia en el almacenamiento de las traducciones: las versiones multilingües de cada artículo se guardan directamente en un campo JSON del registro, lo que acelera el acceso y facilita la ampliación a nuevos idiomas. El compromiso más revelador es el
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.