Claude Code ayudó a montar un CRM funcional de 46.000 líneas, y ya hay una guía
Habr AI analizó un caso real de vibe coding: un equipo de dos personas montó en mes y medio un CRM funcional de 46.000 líneas con Claude Code. Lo importante no es el volumen de código, sino la disciplina: un claude.md corto, documentación por módulos, un contexto por tarea, plan mode para los bloques grandes y revisión obligatoria.
Procesado por IA desde Habr AI; editado por Hamidun News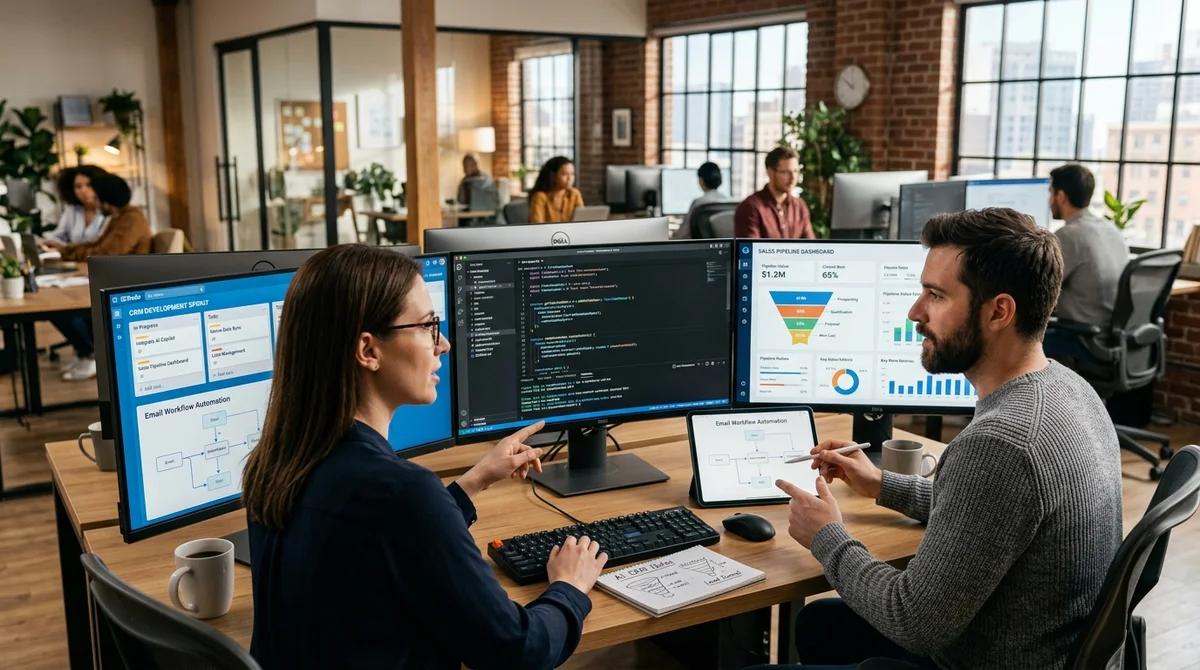
Habr AI ha publicado un caso detallado sobre cómo un equipo de dos personas construyó un CRM comercial casi por completo con Claude Code. En mes y medio obtuvieron 46.000 líneas de código, un producto funcional y un conjunto de reglas sin las cuales este modo de trabajo se convierte rápidamente en caos.
Qué construyeron
Los autores describen no un prototipo didáctico, sino un CRM funcional para gestionar solicitudes entrantes y llevar las operaciones comerciales. El sistema puede responder correos automáticamente, crear tareas y mover al cliente por el embudo.
El proyecto lo escribieron dos personas. Una combinaba los papeles de gestora y analista, recogía las tareas de las llamadas con ReadAi y las volcaba en Jira mediante MCP. La otra dirigía el proceso de desarrollo, implementación y pruebas. El stack elegido fue NestJS, NextJS, ShadCN UI y PostgreSQL.
La conclusión clave del experimento es sencilla: lo impresionante no es la cifra de 46.000 líneas, sino que un cliente ya usa el proyecto. Es una diferencia importante frente al escepticismo habitual hacia el vibe coding, que a menudo se asocia con demos de fin de semana o con una producción acelerada de deuda técnica. En este caso los autores muestran el escenario contrario: si se limitan de antemano las tareas, los roles y las reglas de trabajo, la IA puede ser no un juguete, sino una herramienta muy práctica para el desarrollo comercial.
Cómo organizaron el proceso
El artefacto principal del equipo fue un archivo claude.md corto: no un vertedero de conocimiento, sino un punto de entrada con la descripción del proyecto, el stack, enlaces a la documentación y reglas básicas. Todo lo demás se sacó a archivos md independientes por módulos: operaciones, procesamiento del correo, API y otras partes del sistema. Para backend, base de datos y otras áreas crearon sus propios «agentes» en forma de instrucciones con patrones, restricciones y errores típicos. La idea es que Claude lea solo el contexto que necesita en ese momento y no gaste tokens en todo el proyecto.
- Un claude.md corto con lo más importante
- Archivos md separados para los módulos grandes
- Instrucciones especializadas para backend y base de datos
- Un contexto por tarea
- Revisión obligatoria tras la generación
La segunda regla es no mezclar tareas en una misma ventana. Los autores aconsejan seguir el esquema «un contexto = una tarea», hacer clear al terminar y usar resume para retomar. El motivo es que, cuando el contexto se desborda, Claude comprime el historial y pierde detalles en el peor momento posible. Para los bloques grandes activaban plan mode, con el fin de dividir la implementación en subtareas independientes.
Según su estimación, incluso la suscripción básica de 20 dólares alcanza para 3–5 horas de trabajo activo, si la documentación y la estructura del proyecto ya están preparadas.
Dónde surgen los problemas
El artículo analiza por separado los fallos típicos. Claude puede confundir métodos de bibliotecas, olvidar lo ya comentado, generar código duplicado o proponer soluciones de arquitectura que encajan mal con el resto del sistema.
Las API externas son una fuente aparte de errores. Si cada vez se descarga la documentación de internet sobre la marcha, el modelo gasta más tokens y se equivoca más en los parámetros o en los escenarios de uso. Por eso, para cada integración el equipo pedía primero a la IA que reuniera un archivo md a partir de la documentación oficial y solo después pasaba al código.
Los autores también aconsejan no saltarse el discovery, no fiarse sin comprobar de una especificación que el cliente haya generado con IA y no esperar un resultado perfecto a la primera. Para tareas de arquitectura complejas conectaron Sequential Thinking, de modo que el modelo recorriera primero una cadena de razonamiento en lugar de lanzarse a escribir código. Para moverse por una base de código grande les resultó útil Serena, que ahorra contexto en la búsqueda de archivos.
Formulan el principio general con mucha franqueza:
«Lo principal es entender qué quieres obtener al final y no generar caos».
Qué significa
El caso de Habr AI muestra que el principal déficit en el vibe coding no es la generación de código, sino la capacidad de controlar el proceso. Claude Code acelera el desarrollo, pero solo si el equipo tiene disciplina en la documentación, la división de tareas, la revisión y el manejo del contexto.
Para estudios y equipos de producto, esto es en esencia una nueva habilidad operativa: no basta con saber escribir prompts, hay que saber diseñar un entorno en el que la IA no se disperse por el proyecto, sino que lo haga avanzar.
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Kimi logra un 96,2 % en un test de analítica sobre una base de 1C y se perfila como plan B ante un bloqueo de Claude
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Google admite que AI Mode reduce los ingresos de su buscador: las acciones caen un 15%
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Qué construyeron?
Los autores describen no un prototipo didáctico, sino un CRM funcional para gestionar solicitudes entrantes y llevar las operaciones comerciales. El sistema puede responder correos automáticamente, crear tareas y mover al cliente por el embudo. El proyecto lo escribieron dos personas. Una combinaba los papeles de gestora y analista, recogía las tareas de las llamadas con ReadAi y las volcaba en Jira mediante MCP. La otra dirigía el proceso de desarrollo, implementación y pruebas. El stack elegido fue NestJS, NextJS, ShadCN UI y PostgreSQL. La conclusión clave del experiment
Cómo organizaron el proceso?
El artefacto principal del equipo fue un archivo claude.md corto: no un vertedero de conocimiento, sino un punto de entrada con la descripción del proyecto, el stack, enlaces a la documentación y reglas básicas. Todo lo demás se sacó a archivos md independientes por módulos: operaciones, procesamiento del correo, API y otras partes del sistema. Para backend, base de datos y otras áreas crearon sus propios «agentes» en forma de instrucciones con patrones, restricciones y errores típicos. La idea es que Claude lea solo el contexto que necesita en ese momento y no gaste tokens
Dónde surgen los problemas?
El artículo analiza por separado los fallos típicos. Claude puede confundir métodos de bibliotecas, olvidar lo ya comentado, generar código duplicado o proponer soluciones de arquitectura que encajan mal con el resto del sistema. Las API externas son una fuente aparte de errores. Si cada vez se descarga la documentación de internet sobre la marcha, el modelo gasta más tokens y se equivoca más en los parámetros o en los escenarios de uso. Por eso, para cada integración el equipo pedía primero a la IA que reuniera un archivo md a partir de la documentación oficial y solo desp
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.