OpenAI lanza Privacy Filter, un modelo abierto para eliminar datos personales de los textos
OpenAI ha lanzado Privacy Filter, un modelo abierto que elimina automáticamente los datos personales (PII) de los textos. Aunque tiene 1.500 millones de parámetros, solo 50 millones se activan realmente, por lo que el modelo se ejecuta directamente en el navegador mediante WebAssembly, sin infraestructura de servidor. Detecta nombres, direcciones, teléfonos y documentos de identidad, y los sustituye por marcadores estándar como [NOMBRE] o [DIRECCIÓN]. Resulta adecuado para entornos autoalojados y pipelines de CI/CD.
Procesado por IA desde MarkTechPost; editado por Hamidun News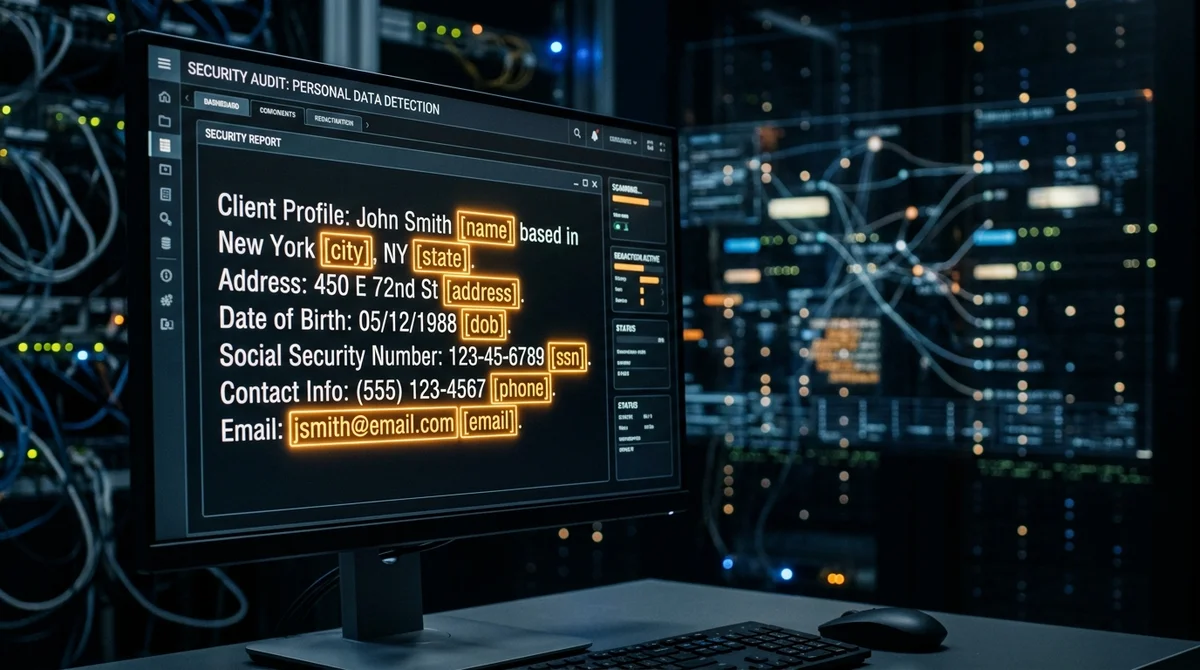
OpenAI ha publicado Privacy Filter, un modelo abierto basado en un decodificador destilado que encuentra y elimina datos personales (PII) de los textos. Aunque sus pesos suman 1.500 millones de parámetros, durante la inferencia solo se activan 50 millones, lo que permite ejecutarlo directamente en el navegador, sin infraestructura de servidor.
Qué es Privacy Filter
Privacy Filter es un modelo de lenguaje especializado en una única tarea: detectar y censurar automáticamente datos personales (Personally Identifiable Information, PII) en un texto. No es un asistente de chat generalista, sino una herramienta utilitaria centrada exclusivamente en localizar información sensible y sustituirla por marcadores estandarizados.
La especialización juega a su favor: un modelo muy ajustado a la tarea la resuelve mejor que los LLM generalistas, que con frecuencia pasan por alto datos personales formulados de forma poco habitual o se equivocan en contextos complejos.
Se basa en un decodificador destilado: un modelo maestro grande transfiere su conocimiento a un modelo alumno compacto mediante destilación. El resultado es una alta precisión de detección con requisitos de cómputo bastante menores. El modelo está disponible en abierto, de modo que cualquier empresa puede integrarlo en sus propios pipelines sin enviar datos a los servidores de OpenAI.
Arquitectura: 50 millones de 1.500 millones
El detalle técnico clave es la diferencia entre el total de parámetros (1.500 millones) y los que se activan realmente al procesar cada token (50 millones). Este enfoque es típico de las arquitecturas de activación dispersa: distintos bloques neuronales se especializan en distintos aspectos de la tarea y se activan de forma selectiva, según los datos de entrada.
Eso hace de Privacy Filter una herramienta práctica en escenarios con recursos limitados:
- Navegador: compatible con WebAssembly y ONNX, así que los datos no salen del dispositivo del usuario
- Dispositivos edge: 50M de parámetros activos permiten funcionar sin GPU en portátiles y smartphones
- Autoalojado: el modelo cabe por completo dentro de la infraestructura de la empresa
- Pipelines de CI/CD: inferencia rápida, sin dependencias de la nube ni costes adicionales
Qué sabe detectar
Privacy Filter reconoce un amplio conjunto de categorías de datos personales que cubre los requisitos clave de GDPR, LGPD y CCPA:
- Nombres, apellidos, iniciales (incluido el reconocimiento contextual sin marcadores explícitos)
- Direcciones, códigos postales, coordenadas geográficas
- Teléfonos y direcciones de correo electrónico
- Documentos de identidad: pasaportes, SSN, INN (número de identificación fiscal ruso), carnés de conducir
- Datos financieros: números de tarjeta y de cuenta bancaria
- Identificadores médicos
El modelo no se limita a marcar los fragmentos con PII: también los sustituye por marcadores estándar: [NOMBRE], [DIRECCIÓN], [TELÉFONO]. El texto de salida queda listo para seguir procesándose, sin posprocesamiento manual.
Contexto regulatorio
La presión regulatoria sobre los datos personales crece en todo el mundo. El GDPR en Europa, la LGPD en Brasil y la CCPA en California exigen a las empresas un manejo cuidadoso de la información sensible. La mayoría de las soluciones comerciales de anonimización automática se quedaban cortas en calidad o exigían enviar los datos a la nube, lo que de por sí contradecía la lógica de la confidencialidad.
Privacy Filter cubre ese hueco: un modelo abierto, compatible con el navegador, que un equipo pequeño puede integrar en un producto en un día sin sacrificar la privacidad de los usuarios.
Qué significa
OpenAI invierte de forma constante en infraestructura abierta junto a sus buques insignia comerciales. Privacy Filter muestra que la compañía ve mercado no solo en el acceso por API a GPT, sino también en herramientas utilitarias que resuelven necesidades operativas concretas. Es una señal para el sector: las herramientas de código abierto de nivel empresarial para la seguridad de datos en IA se vuelven la norma.
Para las empresas, es una solución lista para anonimizar sin desarrollar desde cero y sin depender de la nube.
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Kimi logra un 96,2 % en un test de analítica sobre una base de 1C y se perfila como plan B ante un bloqueo de Claude
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Google admite que AI Mode reduce los ingresos de su buscador: las acciones caen un 15%
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Qué es Privacy Filter?
Privacy Filter es un modelo de lenguaje especializado en una única tarea: detectar y censurar automáticamente datos personales (Personally Identifiable Information, PII) en un texto. No es un asistente de chat generalista, sino una herramienta utilitaria centrada exclusivamente en localizar información sensible y sustituirla por marcadores estandarizados. La especialización juega a su favor: un modelo muy ajustado a la tarea la resuelve mejor que los LLM generalistas, que con frecuencia pasan por alto datos personales formulados de forma poco habitual o se equivocan en cont
¿Qué se sabe sobre Arquitectura: 50 millones de 1.500 millones?
El detalle técnico clave es la diferencia entre el total de parámetros (1.500 millones) y los que se activan realmente al procesar cada token (50 millones). Este enfoque es típico de las arquitecturas de activación dispersa: distintos bloques neuronales se especializan en distintos aspectos de la tarea y se activan de forma selectiva, según los datos de entrada. Eso hace de Privacy Filter una herramienta práctica en escenarios con recursos limitados: Navegador: compatible con WebAssembly y ONNX, así que los datos no salen del dispositivo del usuario Dispositivos edge: 50M d
¿Qué se sabe sobre Qué sabe detectar?
Privacy Filter reconoce un amplio conjunto de categorías de datos personales que cubre los requisitos clave de GDPR, LGPD y CCPA: Nombres, apellidos, iniciales (incluido el reconocimiento contextual sin marcadores explícitos) Direcciones, códigos postales, coordenadas geográficas Teléfonos y direcciones de correo electrónico Documentos de identidad: pasaportes, SSN, INN (número de identificación fiscal ruso), carnés de conducir Datos financieros: números de tarjeta y de cuenta bancaria Identificadores médicos El modelo no se limita a marcar los fragmentos con PII: también l
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.