OpenAI explica qué datos usa ChatGPT para entrenarse y cómo protege la privacidad
OpenAI ha detallado cómo usa ChatGPT los datos para entrenarse y qué controles de privacidad tienen los usuarios. La compañía afirma que aplica Privacy Filter para enmascarar información personal, y que en los ajustes se puede desactivar el uso de las conversaciones nuevas para mejorar los modelos. Para un modo más cerrado existe Temporary Chat: estas conversaciones no aparecen en el historial, no crean memoria y se eliminan a los 30 días.
Procesado por IA desde OpenAI Blog; editado por Hamidun News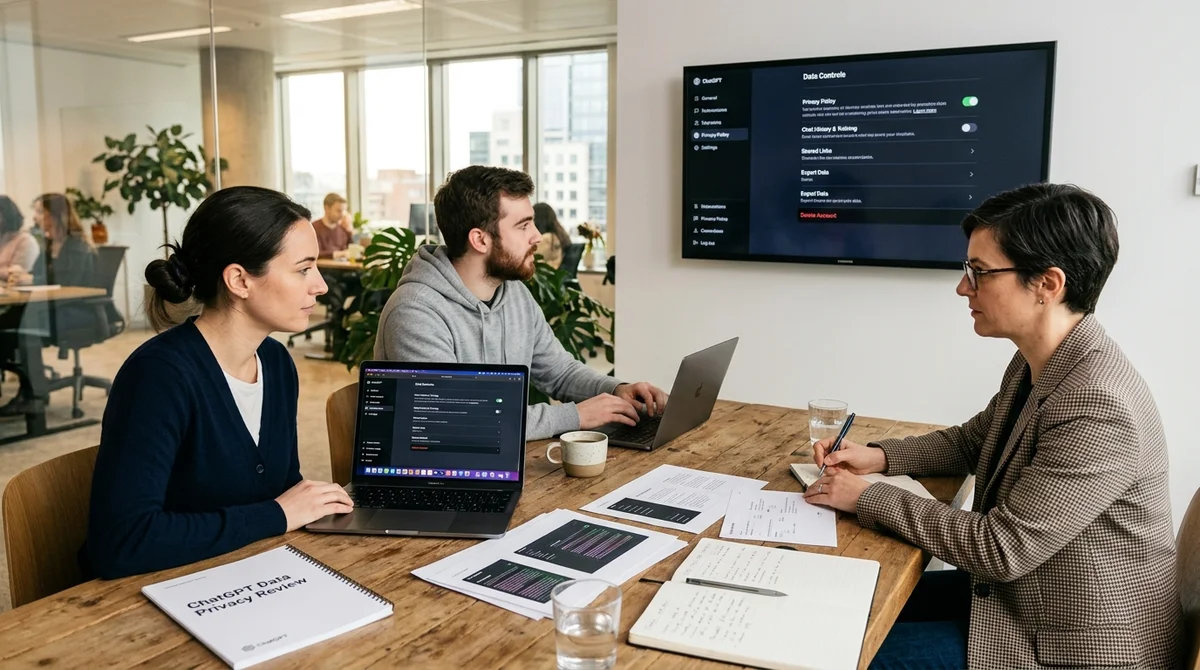
El 6 de mayo, OpenAI publicó una explicación detallada de cómo ChatGPT adquiere conocimiento sobre el mundo y, al mismo tiempo, intenta no incorporar al entrenamiento datos personales innecesarios. La compañía describió las fuentes de datos, los filtros internos y los ajustes con los que el usuario puede limitar el uso de sus propias conversaciones.
De dónde salen los datos
En la publicación, OpenAI divide las fuentes de datos en varias categorías. Para entrenar los modelos que sustentan ChatGPT, la compañía usa información públicamente accesible de internet, datos procedentes de alianzas y material aportado o generado por usuarios, contratistas e investigadores. La idea es que el modelo asimile patrones generales, hechos y relaciones entre temas, y no que memorice historias personales concretas. Según OpenAI, es precisamente esta amplia variedad de fuentes la que ayuda a que las respuestas sean más útiles, estables y seguras.
La compañía precisa además un detalle importante: del contenido de internet abierto, solo se toma para el entrenamiento el material que está en acceso libre y abierto. OpenAI cita como ejemplos las publicaciones públicas, los blogs y los debates en foros abiertos. Esto no resuelve las dudas sobre los límites del uso aceptable de datos abiertos, pero muestra que la empresa intenta formalizar una regla: no todo lo que hay en la red se considera automáticamente apto para el entrenamiento si el acceso a ese contenido está restringido.
Cómo se elimina lo personal
Antes de que los datos entren en el entrenamiento, OpenAI los pasa por un conjunto de mecanismos de protección destinados a reducir el volumen de información personal en los conjuntos de datos. El principal es Privacy Filter, una herramienta para detectar y enmascarar datos personales en el texto. Según la compañía, este filtro se aplica en varias etapas del proceso, incluidos los conjuntos de datos públicos y las conversaciones de los usuarios, si la persona tiene activada la opción Improve the model for everyone. OpenAI también indica que ha hecho Privacy Filter gratuito para otros desarrolladores, de modo que este enfoque pueda usarse fuera de ChatGPT.
Hay otra capa de protección que no tiene que ver con el entrenamiento, sino con las propias respuestas de ChatGPT. El servicio debe rechazar las solicitudes de información privada o sensible sobre personas concretas, aunque OpenAI reconoce abiertamente que aún son posibles los errores. Si aun así aparece información personal en una respuesta y la persona la considera inexacta o inapropiada, puede enviar una solicitud a través del portal de privacidad. La compañía subraya, además, que la privacidad y la respuesta a riesgos graves, como las amenazas creíbles de violencia, deben funcionar a la vez y no estorbarse mutuamente.
«La protección de la privacidad es una parte central de cómo construimos
ChatGPT».
Qué ajustes hay
La parte más práctica del material es la lista de interruptores que permiten al usuario decidir cuántos datos entrega al sistema. OpenAI recalca que el control sobre las conversaciones no está escondido en la documentación, sino integrado directamente en la interfaz de ChatGPT. Es decir, no se trata solo de principios de la empresa, sino de acciones bastante concretas: se puede desactivar la participación de los chats nuevos en el entrenamiento, eliminar la memoria o pasar a un modo temporal independiente para consultas más sensibles.
- En Settings -> Data Controls se puede desactivar la opción Improve the model for everyone. Después, los chats nuevos seguirán en el historial, pero no se usarán para entrenar modelos.
- El modo Temporary Chat inicia una conversación de un solo uso: no se guarda en el historial, no crea memoria y no se usa para mejorar los modelos.
- Los chats temporales se conservan 30 días por motivos de seguridad y después se eliminan.
- La función Memory se puede consultar, editar, borrar o desactivar por completo si no se quiere que ChatGPT recuerde detalles pasados.
- El usuario también puede exportar sus datos, eliminar su cuenta y enviar una solicitud a través del portal de privacidad.
Hay también una advertencia directa: no conviene enviar a ChatGPT información sensible que el usuario no estaría dispuesto a compartir ni siquiera en el contexto de una revisión o un procesamiento por parte del sistema. Es una salvedad importante, porque muchas personas perciben la interfaz de chat como un cuaderno privado o un interlocutor seguro por defecto. OpenAI, por el contrario, intenta transmitir un modelo de uso más sobrio: el usuario dispone de herramientas de control, pero la responsabilidad por lo que introduce en el servicio no desaparece.
Qué significa
OpenAI intenta, en la práctica, trasladar la conversación sobre privacidad de las promesas generales a un conjunto de reglas e interruptores concretos. Para los usuarios es útil: ahora está más claro qué datos pueden participar en el entrenamiento, cómo desactivar ese escenario y en qué se diferencia un chat normal de Temporary Chat. Para el mercado, es una señal de que la confianza en los productos de IA depende cada vez más no solo de la calidad del modelo, sino también de la transparencia en el manejo de la información personal.
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Kimi logra un 96,2 % en un test de analítica sobre una base de 1C y se perfila como plan B ante un bloqueo de Claude
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Google admite que AI Mode reduce los ingresos de su buscador: las acciones caen un 15%
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre De dónde salen los datos?
En la publicación, OpenAI divide las fuentes de datos en varias categorías. Para entrenar los modelos que sustentan ChatGPT, la compañía usa información públicamente accesible de internet, datos procedentes de alianzas y material aportado o generado por usuarios, contratistas e investigadores. La idea es que el modelo asimile patrones generales, hechos y relaciones entre temas, y no que memorice historias personales concretas. Según OpenAI, es precisamente esta amplia variedad de fuentes la que ayuda a que las respuestas sean más útiles, estables y seguras. La compañía prec
Cómo se elimina lo personal?
Antes de que los datos entren en el entrenamiento, OpenAI los pasa por un conjunto de mecanismos de protección destinados a reducir el volumen de información personal en los conjuntos de datos. El principal es Privacy Filter, una herramienta para detectar y enmascarar datos personales en el texto. Según la compañía, este filtro se aplica en varias etapas del proceso, incluidos los conjuntos de datos públicos y las conversaciones de los usuarios, si la persona tiene activada la opción Improve the model for everyone. OpenAI también indica que ha hecho Privacy Filter gratuito
¿Qué se sabe sobre Qué ajustes hay?
La parte más práctica del material es la lista de interruptores que permiten al usuario decidir cuántos datos entrega al sistema. OpenAI recalca que el control sobre las conversaciones no está escondido en la documentación, sino integrado directamente en la interfaz de ChatGPT. Es decir, no se trata solo de principios de la empresa, sino de acciones bastante concretas: se puede desactivar la participación de los chats nuevos en el entrenamiento, eliminar la memoria o pasar a un modo temporal independiente para consultas más sensibles. En Settings -> Data Controls se puede d
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.