Wildberries & Russ describe qué nivel de madurez de datos necesitan los agentes de IA para ser precisos
Wildberries & Russ ha propuesto un modelo de madurez para la documentación de datos, de Rare a Well-Done, y explica por qué los agentes de IA empiezan a alucinar incluso en tareas SQL sencillas cuando los metadatos son deficientes. En el nivel básico hacen falta un responsable, un modelo físico y etiquetas de confidencialidad. En el intermedio, un glosario y una capa lógica. En el nivel objetivo, una capa semántica completa para text-to-SQL y métricas de negocio precisas.
Procesado por IA desde Habr AI; editado por Hamidun News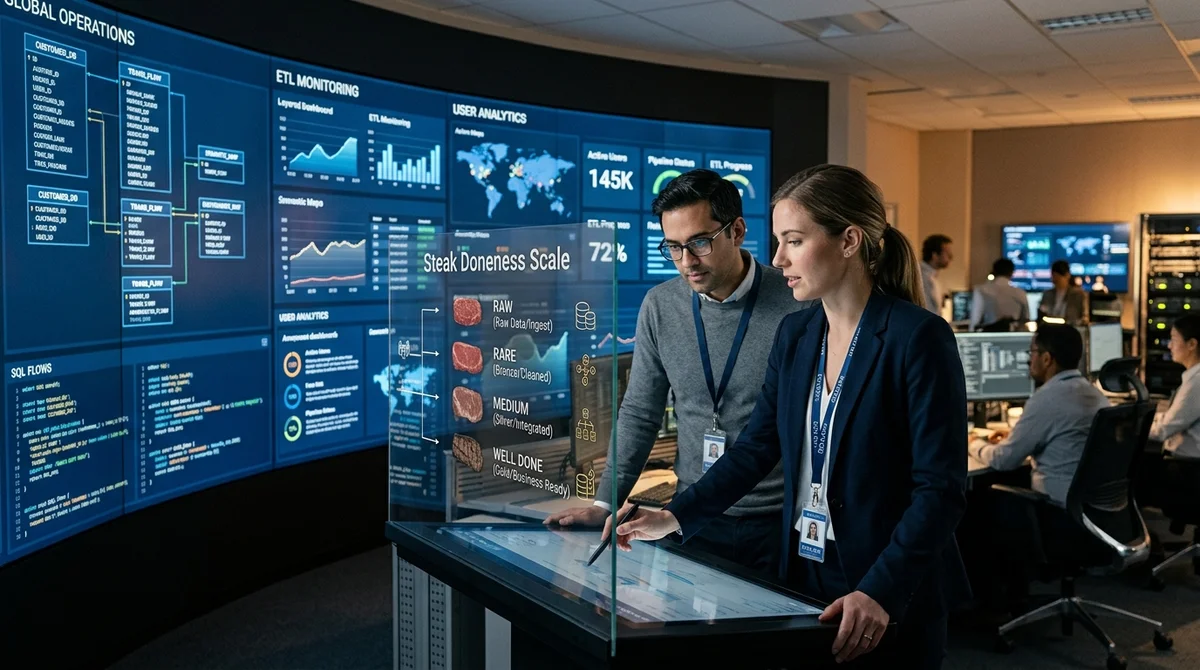
Wildberries & Russ propone evaluar la calidad de la documentación de datos con el mismo pragmatismo que el punto de cocción de un filete: de Rare a Well-Done. La idea es sencilla: cuanto mejor describe una empresa sus tablas, campos, términos de negocio y métricas, menos alucinan los agentes de IA y más se acercan a conclusiones de negocio reales, en lugar de respuestas verosímiles pero inútiles.
La compañía sostiene que el principal problema del big data hoy no es la falta de modelos, sino el escaso mantenimiento de los propios datos. En una organización grande, las tablas nuevas aparecen más rápido de lo que los equipos pueden documentarlas a mano. Como consecuencia, los analistas pierden tiempo buscando las fuentes adecuadas, las métricas divergen entre informes y el acceso a conjuntos de datos sin etiquetar se convierte en un riesgo de seguridad. Esto resulta especialmente grave donde hay datos personales y requisitos estrictos de control de acceso. En ese entorno, el enfoque manual simplemente deja de escalar.
El primer nivel de madurez, Rare, se considera el mínimo suficiente para trabajar con datos de forma segura. En él, cada conjunto debe tener un responsable, un modelo físico y un etiquetado de confidencialidad. El modelo físico puede extraerse automáticamente de las tablas del sistema y de los catálogos de datos, y si las descripciones de los campos están vacías, la IA puede intentar reconstruirlas a partir de las convenciones de nomenclatura y de las bases de conocimiento corporativas.
Con los responsables la automatización funciona peor: el modelo puede proponer un candidato, pero la responsabilidad se asigna igualmente a mano. En cambio, el etiquetado de datos sensibles parece una de las primeras tareas prácticas para los LLM: el modelo puede analizar los nombres de tablas, columnas y términos de negocio y asignar etiquetas de seguridad antes de un escaneo profundo del contenido.
En el nivel Medium, el énfasis pasa de la estructura técnica al significado de negocio. Aquí aparecen el glosario y una capa lógica que traduce el lenguaje de tablas y columnas a entidades y atributos comprensibles para el negocio. Esta capa oculta prefijos de servicio, joins complejos y detalles de almacenamiento, y los data stewards pueden usar la IA como copiloto para vincular campos con términos existentes y detectar lagunas en las descripciones.
Si un agente está conectado al catálogo de metadatos mediante MCP, puede obtener a demanda los esquemas necesarios, cotejarlos con el glosario y acelerar un trabajo que antes llevaba horas. Además, Wildberries & Russ propone extraer relaciones no solo de la estructura del almacén, sino también de los logs de consultas SQL: permiten saber qué tablas unen con más frecuencia los analistas, qué filtros usan y cómo se consumen realmente los datos.
El nivel más alto, Well-Done, no sirve solo para navegar por los datos, sino para que funcionen de verdad el text-to-SQL y los sistemas agénticos. Aquí se construye una capa semántica sobre la descripción física y lógica: hechos, métricas, dimensiones, relaciones, filtros y consultas verificadas en lenguaje natural con respuestas SQL listas. Esta capa explica al modelo qué entiende el negocio por «cliente activo», «ingresos brutos» u otra métrica, en lugar de obligarlo a adivinar el significado por los nombres de los campos.
El artículo ofrece un ejemplo revelador. Si se pregunta a una IA cuántos clientes activos hubo en marzo, un modelo sin semántica puede limitarse a contar las filas con el estado active, aunque según las reglas de la empresa un cliente activo es el que ha hecho al menos un pedido por encima de un umbral determinado. Según el autor, aquí los estándares abiertos como OSI se vuelven críticos, porque permiten describir el significado de los datos en un formato portable y compatible con las herramientas modernas de capa semántica.
También se señala el efecto práctico: en los materiales de Snowflake para Cortex Analyst se menciona un aumento de precisión de aproximadamente un 20 por ciento al trabajar con una semántica correctamente descrita, y la meta para escenarios reales es superar el 90 por ciento de precisión en SQL.
Qué significa esto en la práctica: el mercado se aleja poco a poco de la idea de que basta con conectar un LLM a una base de datos y esperar magia. El enfoque de Wildberries & Russ muestra una trayectoria más sobria: primero poner orden en responsables, estructura y clasificación de los datos, luego construir un diccionario lógico y solo después levantar la capa semántica para los agentes. Para las empresas que quieren incorporar asistentes de IA a la analítica, es una verdad incómoda pero útil: la calidad de la respuesta del modelo depende ahora no solo del modelo, sino de la madurez de la documentación de datos dentro del negocio.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.