OpenAI, Anthropic y Gemini: cómo el almacenamiento en caché de la inferencia reduce el precio y la latencia de los LLM
El almacenamiento en caché de la inferencia se está convirtiendo en una optimización básica para los servicios basados en LLM: reduce la latencia, evita cálculos repetidos y rebaja notablemente el gasto en tokens. La principal regla práctica de la nueva guía es usar primero el prefix caching para system prompts largos y estables, y activar el semantic caching solo donde muchos usuarios hacen preguntas parecidas con palabras distintas.
Procesado por IA desde Machine Learning Mastery; editado por Hamidun News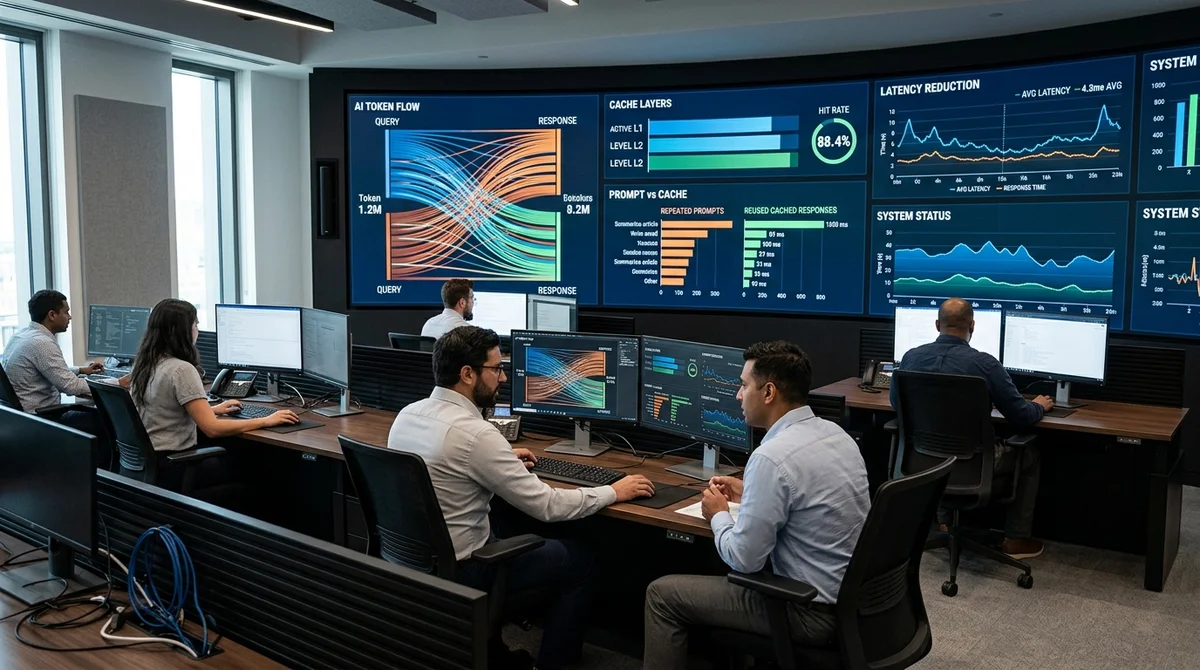
El almacenamiento en caché de la inferencia se está convirtiendo rápidamente en una de las técnicas más prácticas para trabajar con grandes modelos de lenguaje. Reduce el coste de las peticiones, recorta la latencia y evita recalcular una y otra vez las mismas partes del prompt. En servicios en producción con instrucciones de sistema largas y peticiones repetitivas, ha dejado de ser una optimización fina para convertirse en una herramienta básica de ahorro.
La idea de fondo es que un LLM dedica una parte considerable de sus recursos no a elaborar una «respuesta inteligente», sino a volver a procesar un contexto que ya conoce. Si una aplicación usa siempre el mismo system prompt, documentos compartidos, ejemplos few-shot o preguntas tipo, el modelo sin caché repite ese recorrido en cada llamada. El inference caching guarda los resultados de esos cálculos y los reutiliza cuando la siguiente petición coincide por completo o, al menos, se parece lo suficiente en significado.
Así, el sistema consume menos tokens, responde antes al usuario y escala con más facilidad ante cargas elevadas. En el nivel más básico funciona la caché KV. Durante la generación, el modelo guarda token a token los estados internos de attention —los pares key y value— para no tener que recalcularlos en cada paso de decodificación.
Esto ocurre automáticamente en casi todos los motores de inferencia actuales y acelera una petición concreta. Normalmente el usuario no tiene que activar nada a mano, pero conviene entender que sobre este mecanismo se construyen optimizaciones de nivel superior con un impacto más visible. Dicho de otro modo, la caché KV es la base que elimina el trabajo innecesario dentro de una sola llamada al modelo.
La siguiente capa es el prefix caching, que los proveedores también llaman prompt caching o context caching. La idea es sencilla: si varias peticiones comparten el mismo inicio —por ejemplo, una instrucción de sistema larga, un bloque de reglas, un documento de referencia o un conjunto de ejemplos—, ese contenido puede procesarse una vez y reutilizarse en las llamadas posteriores. Pero hay una condición estricta: el prefijo debe coincidir byte a byte.
Un espacio de más, un signo de puntuación cambiado, una fecha nueva al principio del prompt o un orden inestable de las claves en un JSON bastan para echar a perder el cache hit. Por eso conviene colocar el contenido estático al principio y llevar al final todo lo variable: el mensaje del usuario, el session ID y la fecha actual. Precisamente por ello, esta técnica ya forma parte de las API de los grandes actores: Anthropic ofrece a los desarrolladores un control explícito sobre los bloques que se almacenan en caché, OpenAI aplica automáticamente el prefix caching a los prompts largos y Google Gemini ofrece un mecanismo propio para almacenar contexto.
En entornos self-hosted, vLLM y SGLang admiten una lógica similar. La tercera capa es el semantic caching. En este caso, el sistema ya no guarda estados intermedios del modelo, sino pares «petición-respuesta», y busca coincidencias por significado mediante embeddings y una base de datos vectorial.
Si el usuario pregunta casi lo mismo que antes, la aplicación puede devolver una respuesta ya preparada sin llamar en absoluto al LLM. Este enfoque resulta especialmente útil en FAQ, bots de soporte y servicios masivos, donde la gente formula las mismas preguntas con palabras distintas. Pero el ahorro tiene un precio en infraestructura adicional: hacen falta embeddings, búsqueda vectorial, TTL y un ajuste cuidadoso del umbral de similitud; de lo contrario, aumenta el riesgo de respuestas desactualizadas o irrelevantes.
Por eso el semantic caching no está justificado en todos los casos, sino sobre todo allí donde hay un gran flujo de peticiones similares y una alta probabilidad de reutilizar una respuesta ya generada. ¿Qué significa esto en la práctica? La caché KV ya funciona por sí sola, el prefix caching suele ofrecer la mejora más rápida y segura en producción, y el semantic caching solo merece la pena donde la repetición de preguntas compensa realmente el coste de la infraestructura adicional.
Para la mayoría de los equipos, el camino óptimo es este: primero estabilizar la estructura de los prompts, llevar todo el contexto común al principio y lograr una alta tasa de cache hit por prefijo; solo después decidir si hace falta una caché semántica. En las aplicaciones con LLM, es un caso poco habitual en el que una sola disciplina de arquitectura recorta costes, acelera el producto y apenas altera la experiencia de usuario.
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Google admite que AI Mode reduce los ingresos de su buscador: las acciones caen un 15%
- 31 oct 2026Un autor sometió su guion a un jurado de IA: el veredicto costó 850.000 tokens
- 31 oct 2026Anthropic: unificar subagentes en un solo bucle duplicó la velocidad de las tareas de un cliente
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.