Machine Learning Mastery
Fuente de noticias de IA. Los artículos son seleccionados y adaptados por la redacción de Hamidun News.
Últimas publicaciones

pgvector frente a Qdrant: benchmark con 100 000 vectores de 1536 dimensiones
Machine Learning Mastery propone una medición reproducible de pgvector y Qdrant: mismo HNSW, 1536 dimensiones, 100 000 vectores, p50/p95/p99 y QPS en un portátil común.

Machine Learning Mastery muestra cómo montar un RAG con scikit-learn sin base de datos vectorial
Machine Learning Mastery desglosa un RAG ligero de extremo a extremo: embeddings de modelos abiertos, búsqueda vectorial con scikit-learn y respuesta generada a partir del contexto recuperado.

Unsloth y Llama 3: cómo enseñar a un modelo a llamar a una API de forma estable mediante JSON
Machine Learning Mastery explica cómo ajustar Llama 3 con Unsloth para generar JSON estricto en tool calling: el modelo generalista rompe el esquema de la API y LoRA ayuda a corregirlo.

Cómo crear un agente de IA para navegador con Python: la guía paso a paso de Machine Learning Mastery
Machine Learning Mastery publica una guía para crear agentes en Python que controlan el navegador: abren sitios web, hacen clic y rellenan formularios sin una API oficial.

Transformers.js y embeddings: búsqueda semántica sin infraestructura de servidor
Machine Learning Mastery explica cómo sustituir la búsqueda por palabras clave por una semántica con Transformers.js, una librería que genera embeddings vectoriales en el cliente, sin API de servidor.

Pipeline de IA agéntica: 7 componentes que separan un sistema en producción de una demo
Machine Learning Mastery publicó una guía con siete componentes de arquitectura que distinguen un sistema de IA agéntica en producción de un simple script de demostración.

Cómo los Agentes de IA Administran Ventanas de Contexto en Tareas Largas: Cinco Estrategias
Machine Learning Mastery desgrana cinco estrategias prácticas para gestionar ventanas de contexto en agentes de IA que trabajan durante horas y alcanzan los límites de tokens del modelo.

LangChain vs LlamaIndex: cómo los desarrolladores eligen un framework para aplicaciones con LLM
Los desarrolladores de aplicaciones con LLM suelen empezar con llamadas directas a la API, pero a medida que el código se vuelve más complejo, pasan a frameworks especializados como LangChain o LlamaIndex.
Cómo elegir herramientas para agentes de IA: guía completa Machine Learning Mastery
Machine Learning Mastery publicó una guía sobre selección de herramientas para agentes de IA: por qué menos es a menudo mejor y cómo la calidad de las descripciones impacta la confiabilidad del agente.
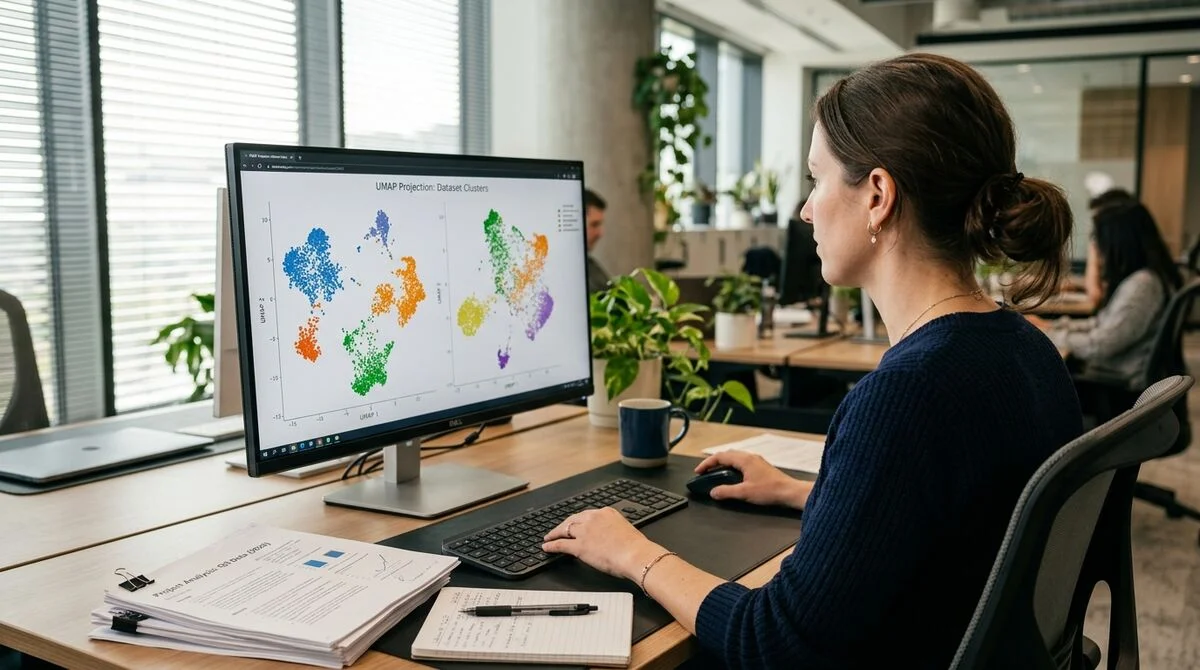
Clustering de textos sin etiquetado: embeddings de LLM y HDBSCAN de Machine Learning Mastery
Machine Learning Mastery muestra cómo agrupar texto no estructurado por temas con embeddings de LLM y HDBSCAN, sin etiquetado manual ni un número de categorías conocido de antemano.
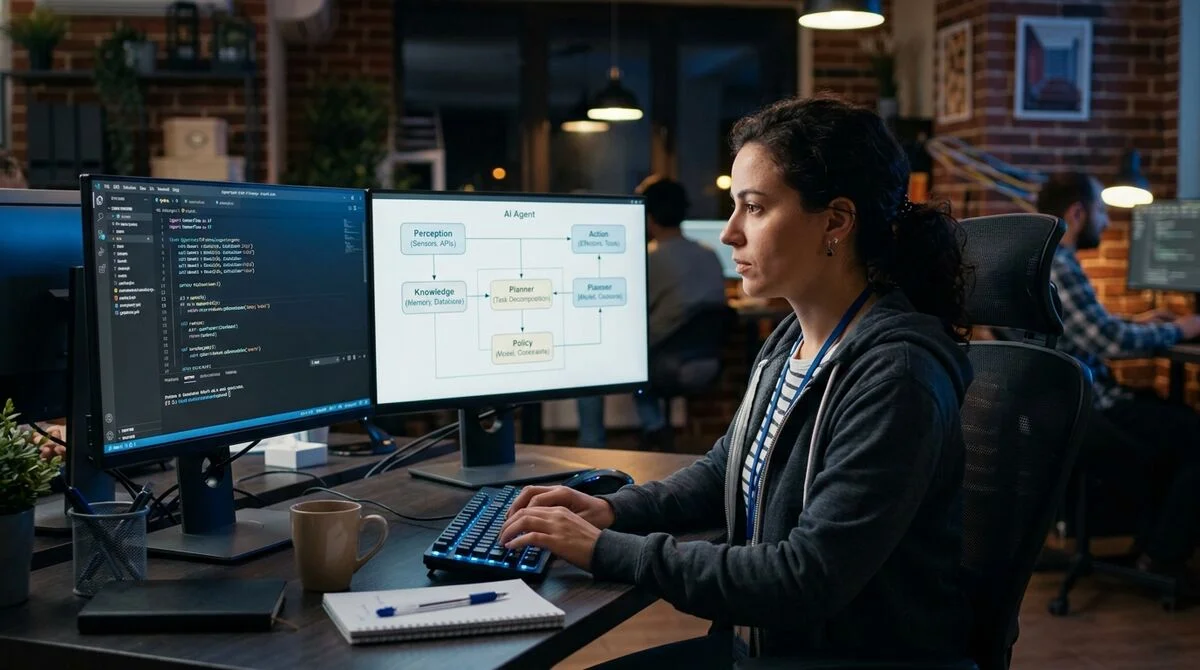
Stack técnico de los agentes de AI: LLM, orquestación, memoria vectorial y herramientas
Machine Learning Mastery explica de qué componentes se compone un agente de AI moderno: framework de orquestación, capas de memoria, herramientas para ejecutar acciones y monitorización.
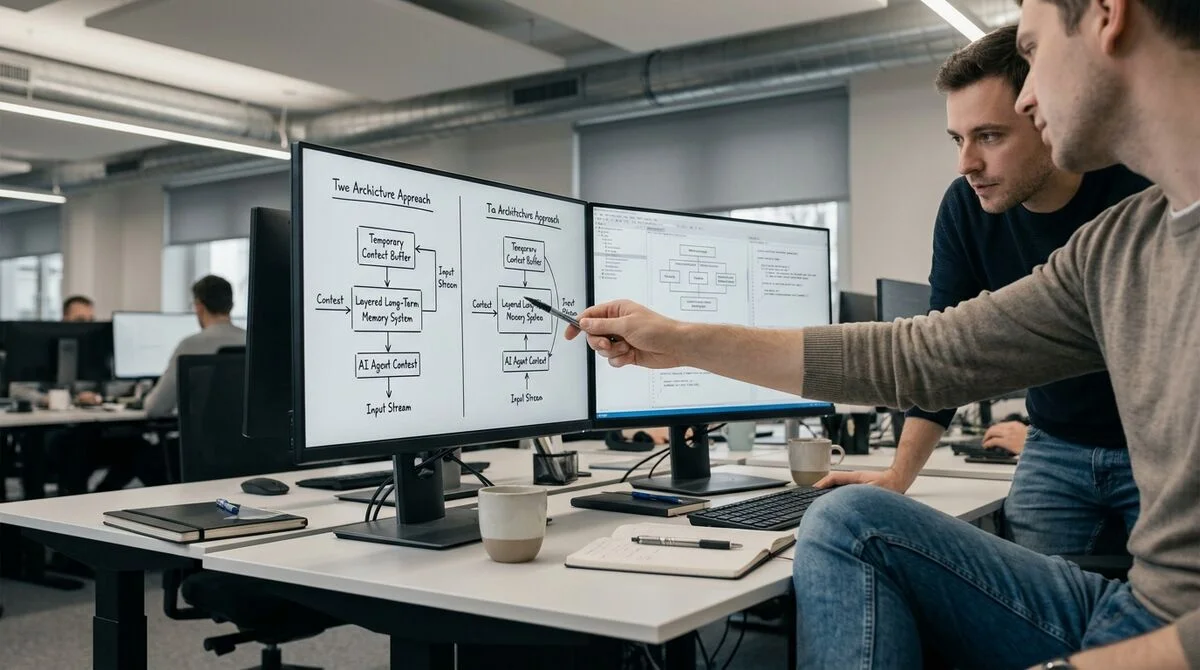
La ventana de contexto no es memoria: qué deben entender los desarrolladores de agentes AI
Los desarrolladores de agentes AI a menudo confunden una gran ventana de contexto con memoria a largo plazo — es un error de arquitectura que aparece en producción al trabajar con usuarios recurrentes.
Hoja de ruta para evaluar agentes de IA: métricas, benchmarks y métodos prácticos
Evaluar agentes de IA es más difícil que evaluar modelos de lenguaje: se necesitan métricas específicas para tareas de varios pasos, el uso de herramientas y la recuperación de errores.
Scikit-LLM: pipeline integral de análisis de sentimiento de texto con modelos de lenguaje
Scikit-LLM integra GPT y otros LLM en pipelines de sklearn: análisis de sentimiento sin etiquetado de datos ni fine-tuning, en una interfaz familiar de sklearn.
Scikit-LLM: clasificación multietiqueta de texto sin conjunto de entrenamiento con LLMs
La biblioteca Scikit-LLM permite asignar varias etiquetas a cada texto sin conjunto de entrenamiento, utilizando GPT-4 y modelos compatibles a través de la interfaz habitual de scikit-learn.
Cómo Diseñar Herramientas para Agentes de IA: Prácticas de Trabajo y Errores Comunes
Machine Learning Mastery analizó por qué un agente de IA funciona exactamente tan bien como se diseñen sus herramientas — y qué errores las hacen inútiles.
Machine Learning Mastery: Conceptos Python que todo Ingeniero de IA debe dominar para producción
Machine Learning Mastery explicó qué patrones Python distinguen scripts experimentales de sistemas de IA escalables capaces de manejar carga real.
Cómo funciona la selección de tokens en redes neuronales: logits, temperatura y top-p
Exploramos las matemáticas de la generación de texto en LLM: cómo logits, temperatura y top-p afectan el equilibrio entre precisión y creatividad en las respuestas.
Context-pruning para agentes LLM de larga duración: una técnica de gestión de memoria
Los agentes basados en grandes modelos de lenguaje requieren un nuevo enfoque para la gestión de memoria durante sesiones largas. Context-pruning permite eliminar información innecesaria y ahorrar tokens.
Búsqueda híbrida en RAG: cuando la semántica se encuentra con palabras clave
La búsqueda híbrida combina algoritmos semánticos y léxicos — es crítica para sistemas RAG listos para producción.
Asistente de investigación multiagente en Python con OpenAI SDK
OpenAI presentó Agents SDK, un marco para crear sistemas de múltiples agentes que trabajan juntos en búsqueda y análisis de información. Esto abre nuevas posibilidades para automatizar investigaciones.
Machine Learning Mastery: búsqueda semántica con embeddings en lugar de palabras clave
La búsqueda por palabras clave falla cuando el documento no contiene literalmente la palabra que busca el usuario. Machine Learning Mastery muestra cómo resolver esto con embeddings de LLM y metadatos.
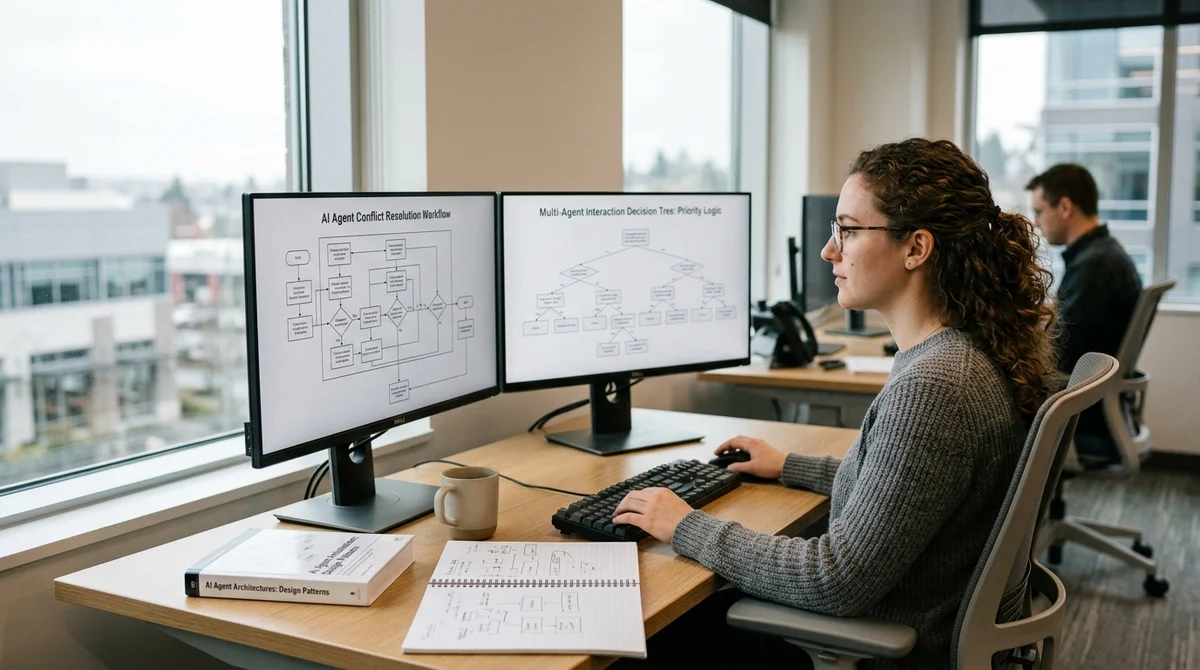
Cómo elegir la arquitectura de un agente de AI: árbol de decisión de Machine Learning Mastery
Machine Learning Mastery publicó una guía con un árbol de decisión para elegir el patrón de diseño óptimo de un agente de AI. La elección depende del tipo de tarea, los requisitos de escalabilidad y la naturaleza de la i
Machine Learning Mastery explicó cómo construir sistemas de ML sin servidores ni grandes conjuntos de datos
Machine Learning Mastery publicó una guía práctica sobre ML en condiciones de hardware limitado, mala conexión a internet y datos sucios, con énfasis en modelos simples y soluciones claras.
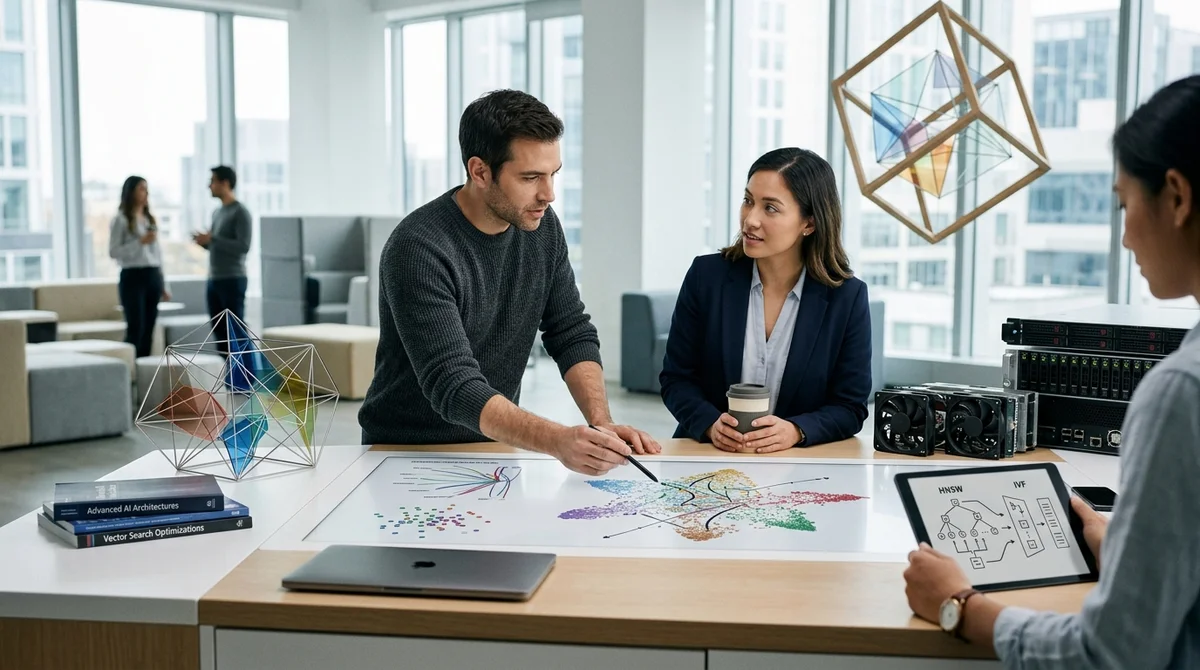
Machine Learning Mastery explicó cómo funcionan las bases de datos vectoriales, de lo simple a lo complejo
Machine Learning Mastery publicó una guía detallada sobre bases de datos vectoriales: desde embeddings y similarity search hasta HNSW, IVF, PQ y los compromisos entre precisión, memoria y latencia.
LlamaCloud añadió LlamaAgents Builder para crear y desplegar agentes de AI en minutos
LlamaCloud ahora incluye LlamaAgents Builder, un servicio beta que crea un agente de procesamiento de documentos a partir de una descripción en texto, lo despliega a través de GitHub y permite probarlo en la interfaz.
Machine Learning Mastery mostró 7 funciones de itertools para feature engineering en Python
Machine Learning Mastery publicó un análisis práctico de siete funciones de itertools de Python que ayudan a crear más rápido features de interacción, lag, polinomiales y acumulativas sin bucles voluminosos.
Machine Learning Mastery identificó 7 tendencias de ML que definirán 2026
Machine Learning Mastery destacó siete tendencias de machine learning para 2026: sistemas agénticos, AI generativa como infraestructura, modelos pequeños, edge computing y el creciente papel de MLOps.
Machine Learning Mastery mostró cómo los decoradores de Python hacen más fiables los servicios de ML
Machine Learning Mastery analizó cinco decoradores de Python para ML en producción: ayudan a soportar fallos de API, validar datos de entrada, ahorrar recursos de cómputo y mejorar la observabilidad del servicio.
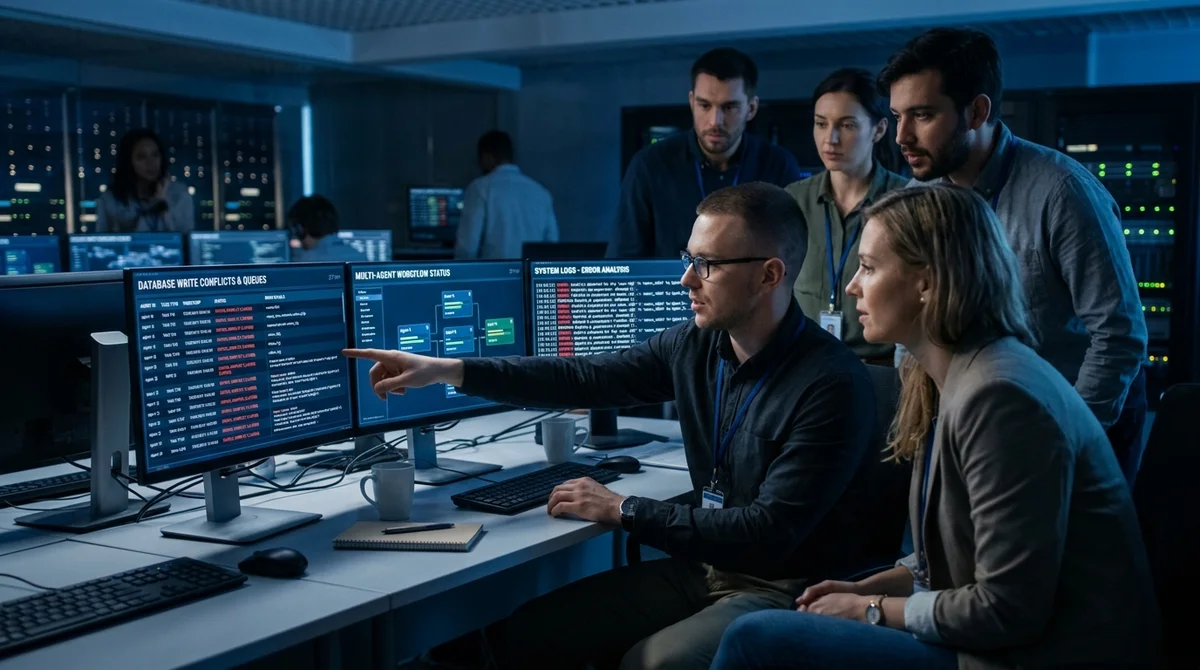
Machine Learning Mastery explicó cómo evitar condiciones de carrera en sistemas multiagentes
Machine Learning Mastery publicó un análisis sobre condiciones de carrera en sistemas multiagentes: por qué los agentes corrompen el estado compartido sin errores y qué patrones reducen el riesgo.