Databricks e Infosys: por qué los datos frenan la adopción de la inteligencia artificial
La principal barrera de la IA corporativa resulta ser más aburrida que los propios modelos: los datos. Las empresas quieren pasar de los chatbots a la automatización de procesos y a los agentes de IA, pero para ello necesitan almacenes unificados, permisos de acceso claros, control del origen de los datos y un vínculo entre sistemas analíticos y transaccionales. Sin esa base, los pilotos lucen bien, pero el escalado choca pronto con el caos y los riesgos.
Procesado por IA desde MIT Technology Review; editado por Hamidun News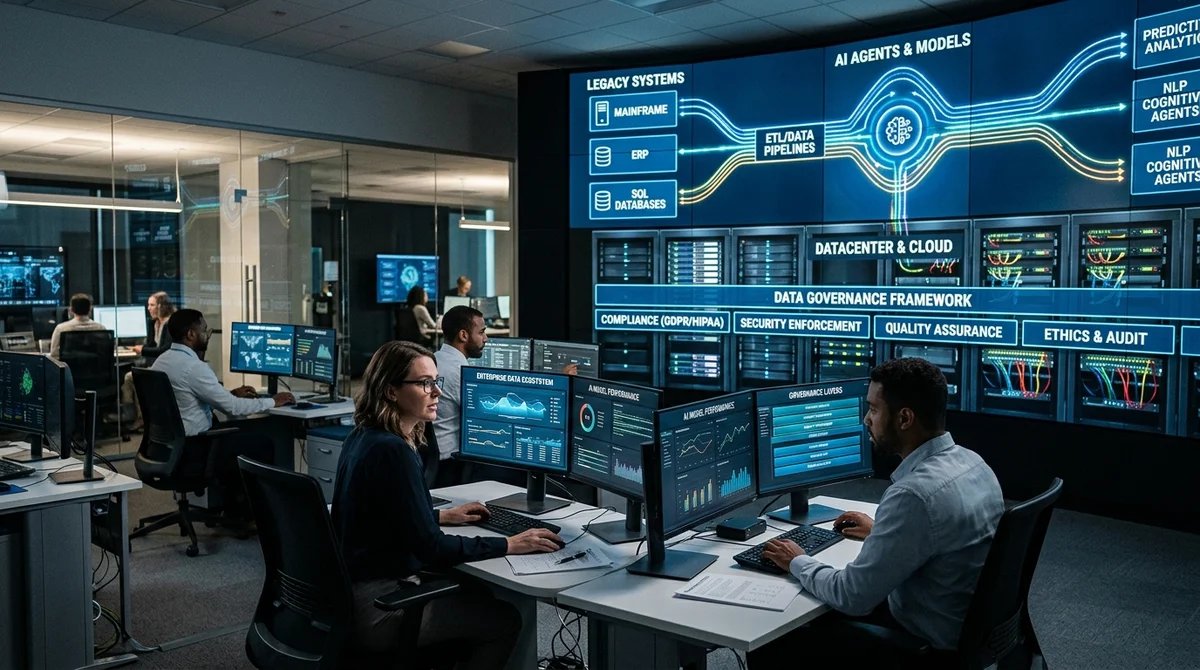
Las empresas debaten cada vez más sobre inteligencia artificial en el consejo de administración, pero el lanzamiento real de IA en el negocio se ve frenado con más frecuencia no por los modelos ni por la capacidad de cómputo, sino por el estado de los datos corporativos. Los servicios de consumo han acostumbrado al mercado a los efectos instantáneos, pero dentro de las grandes organizaciones se descubre enseguida algo más prosaico: sin una infraestructura de datos unificada, gobernada y apta para la explotación, la IA sigue siendo una demostración vistosa y no una herramienta de trabajo.
El problema central es que los datos en las empresas suelen vivir en capas demasiado distintas. Una parte está en data marts analíticos y data lakes, otra en sistemas transaccionales como CRM, ERP y aplicaciones internas, y otra más está dispersa entre archivos, correo, bases de conocimiento, tickets y servicios en la nube. Para los informes habituales, este panorama todavía se puede tolerar.
Pero cuando el negocio quiere dar al modelo acceso a datos en tiempo real, integrar la IA en los procesos o lanzar agentes que no solo responden preguntas, sino que ejecutan acciones, la fragmentación pasa a ser una limitación directa. El modelo puede ser potente, pero si no ve el contexto actual, no entiende el origen de los datos y no trabaja dentro de permisos de acceso claros, el resultado es inestable y arriesgado.
Por eso la conversación sobre IA corporativa se desplaza cada vez más de los modelos a la arquitectura. Una de las tesis clave es que las empresas necesitan no un conjunto de herramientas de IA inconexas, sino un nuevo data stack, donde los datos se almacenen en formatos abiertos, estén descritos con metadatos, sean accesibles mediante políticas unificadas y sirvan a la vez para analítica y para escenarios operativos. De ahí el interés por arquitecturas que unen los mundos OLAP y OLTP: por un lado, las compañías necesitan profundidad analítica, histórico y escala; por otro, baja latencia, transaccionalidad y capacidad de actuar con rapidez.
En este enfoque, Databricks promueve Lakebase como una capa de Postgres sin servidor para cargas operativas de IA, y Unity Catalog como una capa única de control de acceso, linaje de datos y gobernanza para datos y activos de IA. Lo importante no son los productos concretos, sino la tendencia: el negocio necesita una base sobre la que la IA pueda funcionar en producción, y no solo en un piloto.
Otra cuestión es cómo medir el efecto. En una etapa temprana, a las empresas suelen bastarles métricas vistosas, como el número de consultas al chatbot o el porcentaje de empleados que abrieron copilotos. Pero a medida que madura la adopción, eso ya no basta.
Si la IA debe automatizar procesos, acortar el ciclo de una operación, aumentar la conversión o crear nuevas líneas de ingresos, hay que evaluarla como un sistema de negocio completo. Por eso, en el debate sobre el nuevo data stack aparece también la medición del valor: el efecto de la IA debe vincularse no al efecto «guau», sino a resultados concretos para el negocio. Esto es especialmente importante en el tránsito hacia la IA agéntica, donde el modelo gana autonomía y, por tanto, los requisitos de observabilidad, registro de actividad, calidad de datos y política de acceso se vuelven mucho más estrictos.
La evolución de la IA corporativa parece bastante clara. Primero, las empresas adoptan herramientas individuales de productividad: asistentes para buscar, resumir, escribir código o preparar documentos. Después pasan a la automatización de procesos: tramitación de solicitudes, enrutamiento de tareas, soporte interno y escenarios financieros y operativos. Y solo entonces se abre la tercera etapa: el lanzamiento de nuevos productos y líneas de negocio construidos desde el principio en torno a la IA. En cada etapa crecen los requisitos para los datos. Lo que aún servía para un copiloto personal deja de servir para un proceso que exige precisión, un registro completo de acciones y la posibilidad de ejecutar operaciones de forma segura en nombre de la empresa.
De ahí la conclusión principal: la próxima batalla por la IA corporativa no se libra por la mejor interfaz de un modelo, sino por la reconstrucción de los datos para el uso por máquinas. Ganarán no las empresas que antes conectaron el último chatbot, sino las que logren que sus datos sean unificados, gobernados y compatibles con escenarios agénticos. Para el negocio, esto significa una verdad desagradable pero útil: el camino hacia una IA a gran escala no empieza con la elección de un modelo, sino con la reconstrucción del data stack.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.