Tu propio servidor para IA: deja de exprimir el portátil de casa y de escuchar a los gurús
Ejecutar un LLM en el portátil de casa es un entretenimiento para una tarde que pronto choca con la falta de memoria de vídeo y una velocidad de tortuga. Si necesitas una herramienta de trabajo y no un juguete, toca dar el salto a soluciones de servidor. Abundan los consejos sobre cómo ejecutar una Llama «recortada», pero esos modelos aportan poca utilidad práctica. La inferencia de verdad empieza donde terminan las tarjetas gráficas de consumo y comienza una configuración cuidadosa del hardware y el software. Repasamos un plan paso a paso: desde la elección de la GPU hasta la optimización de los pesos. Es una inversión en privacidad y en independencia frente a gigantes de la nube como OpenAI o Anthropic.
Procesado por IA desde Habr AI; editado por Hamidun News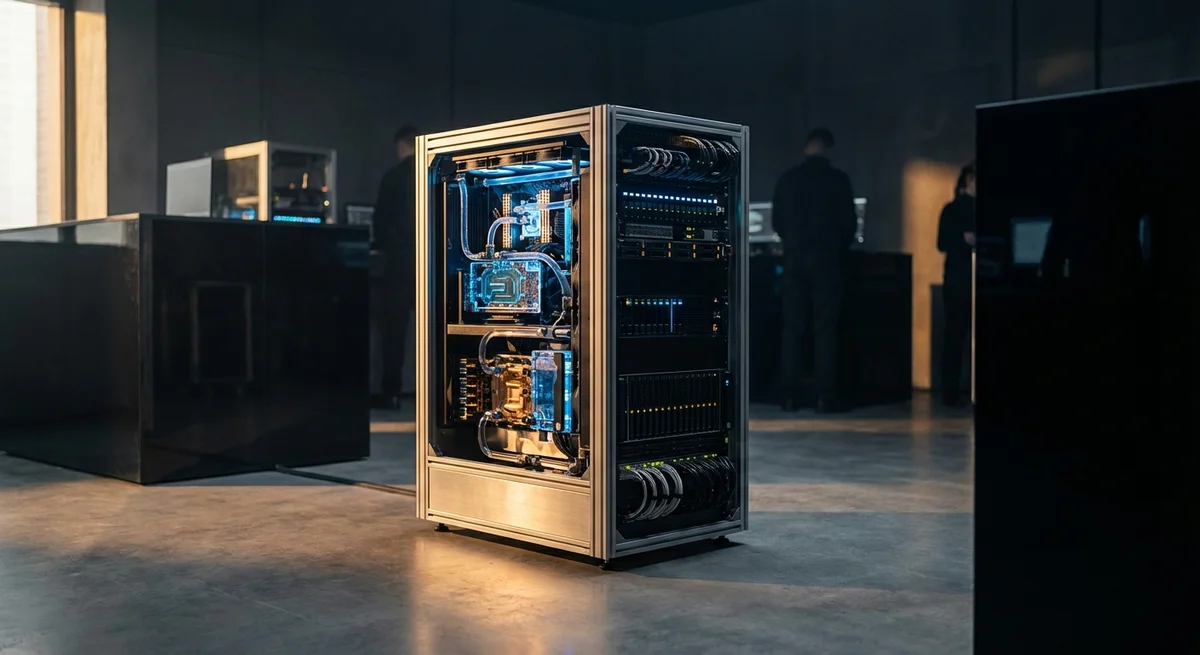
¿Recuerdas la sensación de ejecutar Llama por primera vez en tu portátil? Primero, el entusiasmo de ver que funciona; cinco minutos después, una irritación sorda: el modelo escupe dos palabras por segundo y los ventiladores del ordenador parecen a punto de despegar hacia la estratosfera. Internet está hoy repleto de guías de supuestos expertos que prometen una inteligencia artificial completa en hardware de hace cinco años.
Seamos sinceros: es un autoengaño. Trabajar en serio con modelos de lenguaje locales exige tomarse en serio la infraestructura. Si quieres que la red neuronal te ayude de verdad a programar o a analizar documentos, y no que se limite a entretenerte con chistes torpes, ha llegado el momento de montar tu propio servidor.
¿Para qué complicarse con hardware propio si tienes a mano las API de OpenAI o Anthropic? La respuesta cabe en dos palabras: privacidad y control. Las corporaciones cambian las reglas sobre la marcha, imponen una censura estricta y pueden bloquear tu cuenta sin dar explicaciones. En ese contexto, disponer de un cerebro digital propio se convierte en una cuestión de seguridad. No compartes tus secretos comerciales con servidores en California ni dependes de que Sam Altman decida mañana triplicar los precios. Además, con un uso intensivo, las facturas de la nube empiezan a parecer números de teléfono, y la compra de GPU propias se amortiza antes de lo que parece a primera vista.
El principal problema al montar un servidor así es la memoria de vídeo. Es ella, y no la frecuencia del procesador, la que determina qué modelo podrás ejecutar y lo inteligente que será. Para modelos diminutos de 7.
000 millones de parámetros basta con una tarjeta gráfica gaming de gama media, pero algo realmente potente, como Mixtral o las versiones grandes de Llama 3, requiere decenas o cientos de gigabytes de VRAM. Aquí entramos en el terreno de los compromisos difíciles. O te gastas una fortuna en tarjetas profesionales del nivel de NVIDIA A100 o H100, o aprendes el arte de la cuantización.
La cuantización permite comprimir los pesos del modelo casi sin pérdida de calidad, y es una fase de configuración crítica que separa al aficionado del profesional.
Sin embargo, la memoria es solo la mitad del problema. La otra, que los principiantes suelen olvidar, es el ancho de banda. Puedes comprar mucha memoria barata, pero si el bus de datos es estrecho, tu modelo pensará con una lentitud desesperante. Por eso las soluciones de servidor basadas en arquitecturas de alto ancho de banda valen lo que cuestan. Pasamos de la era de los usuarios corrientes de IA a la de los operadores de sistemas locales. Saber desplegar, optimizar y mantener tu propia capacidad de cómputo se valora hoy mucho más que limitarse a escribir prompts en un chatbot.
La parte de software resulta tan apasionante como la elección del hardware. Ejecutar el modelo desde la consola es solo el principio. Para convertir el servidor en una herramienta útil hay que configurar un entorno de inferencia con herramientas actuales como vLLM u Ollama. Hay que aprender a gestionar las colas de peticiones, ajustar la ventana de contexto e integrar el modelo en tus flujos de trabajo habituales. Así, un montón de hardware caro se transforma en un mecanismo bien engrasado que trabaja para ti 24 horas al día, sin fines de semana ni festivos.
En definitiva, un servidor propio significa libertad para experimentar. Con una máquina potente a mano, empiezas a probar hipótesis en las que antes simplemente no querías gastar tokens de pago. Puedes hacer fine-tuning de modelos con tus propios datos específicos, crear agentes autónomos y no temer que mañana tu acceso a la tecnología quede restringido por el enésimo cambio en la política de privacidad. Es la entrada a la primera división de la independencia tecnológica, donde tú fijas las reglas del juego y controlas cada byte de información.
Lo esencial: un servidor local es la única forma de obtener una IA verdaderamente privada y de alto rendimiento sin depender de las corporaciones. ¿Estás dispuesto a invertir en tu independencia digital o seguirás alquilando cerebros a los gigantes de Silicon Valley?
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Google admite que AI Mode reduce los ingresos de su buscador: las acciones caen un 15%
- 31 oct 2026Un autor sometió su guion a un jurado de IA: el veredicto costó 850 000 tokens
- 31 oct 2026Anthropic: fusionar subagentes en un solo bucle duplicó la velocidad de las tareas de un cliente
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.