Redes neuronales con plantilla: por qué ChatGPT, Claude y Gemini piensan igual
Pida a cualquier chatbot un número aleatorio del 1 al 10 y casi seguro obtendrá un 7. Es el síntoma de un problema sistémico: todos los grandes LLM se entrenaron con datos similares y tienden al "pensamiento de grupo". Los investigadores han documentado el patrón en Claude, ChatGPT y Gemini. Una startup desarrolla métodos para romper ese consenso y lograr que los modelos den respuestas realmente distintas.
Procesado por IA desde MIT Technology Review; editado por Hamidun News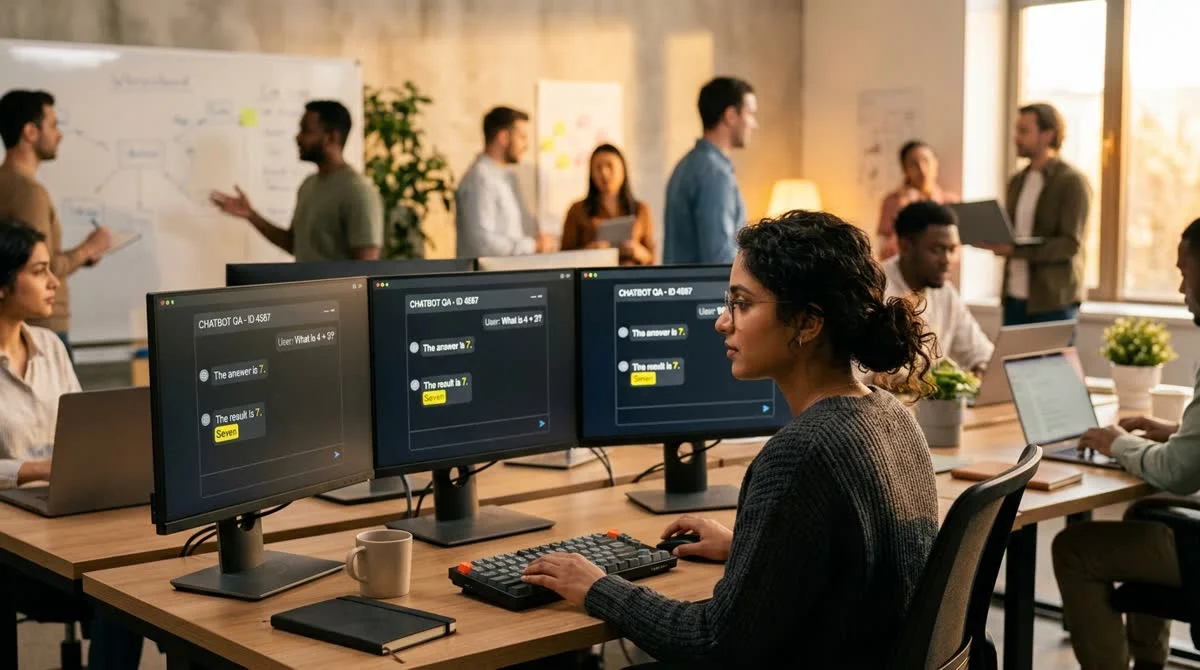
ChatGPT, Claude y Gemini dan respuestas igual de predecibles ante peticiones similares. El 1 de julio de 2026, MIT Technology Review describió este fenómeno como un "pensamiento de grupo" sistémico de los modelos de lenguaje e informó sobre una startup que desarrolla formas de superarlo.
La prueba de los números: ¿por qué no es una coincidencia?
Pida a cualquier chatbot popular un número aleatorio del 1 al 10 y casi seguro obtendrá un 7. Vuelva a preguntar y oirá un 3 o un 4; otra vez, un 8 o un 9. El patrón se repite con una estabilidad llamativa en modelos de distintas empresas.
La explicación es sencilla: todos los grandes LLM se entrenaron con corpus web similares, donde el "7" aparece como respuesta a esta pregunta con más frecuencia que otros números, porque las propias personas llaman al siete el número "más aleatorio". El ajuste fino con aprendizaje por refuerzo (RLHF) premia además las respuestas "seguras" y esperadas, las que reciben con más frecuencia buenas valoraciones de evaluadores humanos. Los modelos están, literalmente, entrenados para dar la respuesta predecible.
- El siete como número "aleatorio" es un ejemplo de manual de la tendencia de los LLM a las plantillas
- El patrón aparece en Claude (Anthropic), ChatGPT (OpenAI) y Gemini (Google DeepMind)
- La causa es la coincidencia de los datos de entrenamiento y procedimientos RLHF similares en todos los grandes laboratorios
Dónde el pensamiento de grupo causa daño real
Los números son solo un síntoma visible. En tareas reales el problema es mayor: los modelos repiten los mismos clichés culturales, formulan recomendaciones estratégicas de forma parecida y proponen soluciones de marketing similares. Cuando una empresa usa varios LLM para "diversificar puntos de vista", suele recibir versiones reformuladas de una misma opinión, con una ilusión de independencia.
"Hemos creado un ecosistema en el que todos los modelos ven el mundo igual, porque leyeron lo mismo", afirma MIT
Technology Review.
El problema es especialmente agudo donde importa la originalidad: generación de hipótesis científicas, contenido poco convencional, evaluación de riesgos no triviales. En esos casos, la "verificación independiente" con varios LLM da la ilusión de diversidad, pero no diversidad real.
Qué propone la startup
MIT Technology Review describe una startup centrada en métodos para superar el "pensamiento de plantilla" en los modelos de lenguaje. No se ha revelado la arquitectura exacta de la solución. Mientras tanto, la industria discute varios enfoques:
- Entrenar con datos más diversos, incluyendo de forma deliberada puntos de vista minoritarios
- Estocasticidad controlada durante el ajuste fino, premiando la variabilidad como objetivo explícito
- Sistemas de conjunto en los que varios modelos con distintos "sesgos" debaten entre sí
- Métricas de diversidad de respuestas como parte obligatoria de las evals, junto con la precisión y la seguridad
Qué significa
Si los métodos para superar el "consenso de grupo" logran fijar un nuevo estándar en el sector, cambiará cómo evaluamos los sistemas de IA: la diversidad y la independencia de las respuestas serán requisitos tan medibles como la precisión o la seguridad. Para los usuarios corporativos, esto abre la posibilidad de obtener de la IA perspectivas realmente distintas, y no una visión estadísticamente promediada con distintas palabras.
¿Por qué ChatGPT, Claude y Gemini dan las mismas respuestas?
MIT Technology Review identificó un fenómeno sistemático, al que llama "pensamiento de grupo" de las redes neuronales: reproducen respuestas igual de predecibles ante peticiones similares, incluso cuando se les pide que sean aleatorias.
¿Se pueden corregir las respuestas idénticas de la IA?
La startup descrita en el artículo desarrolla formas de superar este fenómeno en los modelos de lenguaje.
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Kimi logra un 96,2 % en un test de analítica sobre una base de 1C y se perfila como plan B ante un bloqueo de Claude
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Google admite que AI Mode reduce los ingresos de su buscador: las acciones caen un 15%
Preguntas frecuentes sobre la noticia
La prueba de los números: ¿por qué no es una coincidencia?
Pida a cualquier chatbot popular un número aleatorio del 1 al 10 y casi seguro obtendrá un 7. Vuelva a preguntar y oirá un 3 o un 4; otra vez, un 8 o un 9. El patrón se repite con una estabilidad llamativa en modelos de distintas empresas. La explicación es sencilla: todos los grandes LLM se entrenaron con corpus web similares, donde el "7" aparece como respuesta a esta pregunta con más frecuencia que otros números, porque las propias personas llaman al siete el número "más aleatorio". El ajuste fino con aprendizaje por refuerzo (RLHF) premia además las respuestas "seguras"
¿Por qué ChatGPT, Claude y Gemini dan las mismas respuestas?
MIT Technology Review identificó un fenómeno sistemático, al que llama "pensamiento de grupo" de las redes neuronales: reproducen respuestas igual de predecibles ante peticiones similares, incluso cuando se les pide que sean aleatorias.
¿Se pueden corregir las respuestas idénticas de la IA?
La startup descrita en el artículo desarrolla formas de superar este fenómeno en los modelos de lenguaje.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.