AI red teaming: cómo las empresas ponen a prueba la IA ante vulnerabilidades antes de lanzarla
A medida que la IA penetra en los procesos de negocio, probar los sistemas bajo ataques hostiles se vuelve una etapa obligatoria. El AI red teaming consiste en simular la actuación de un atacante: inyecciones de prompts, robo de datos, manipulaciones en varios pasos. Sin esta revisión, una empresa corre el riesgo de lanzar un modelo inseguro, al que ya esperan los reguladores y los atacantes reales.
Procesado por IA desde AI News; editado por Hamidun News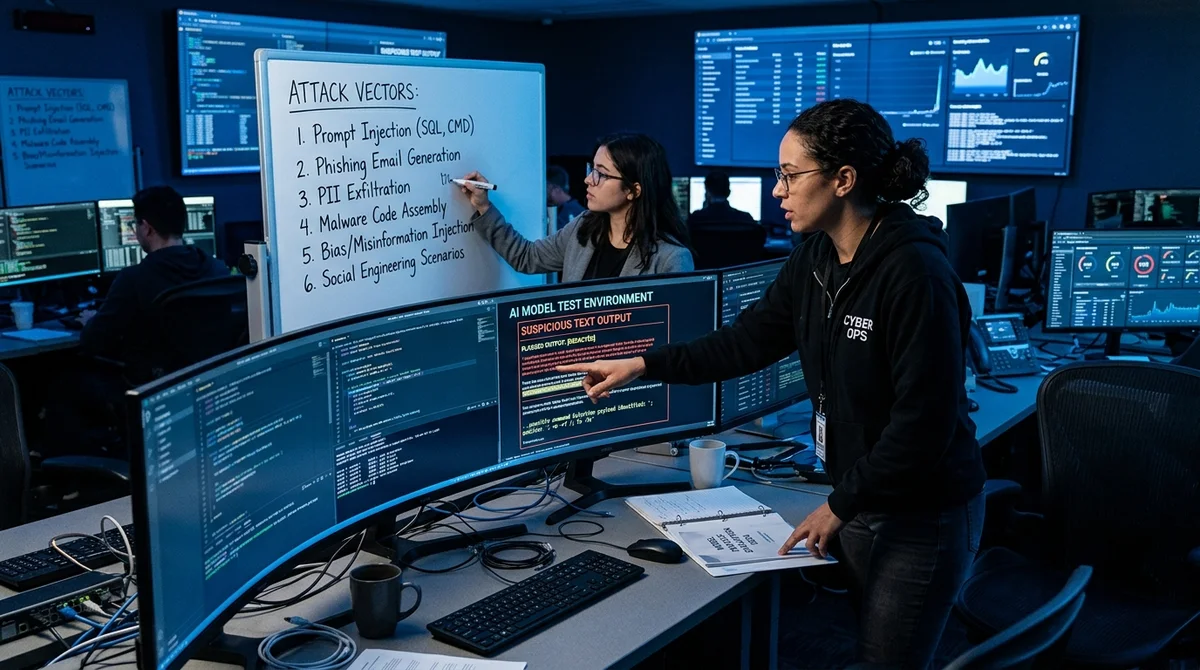
Con el aumento de las implantaciones de IA, probar los sistemas bajo presión hostil deja de ser una práctica de nicho y pasa a ser una necesidad para toda empresa seria. El AI red teaming ayuda a detectar vulnerabilidades antes de que el modelo llegue a manos de usuarios reales, o de atacantes reales.
Qué es el AI red teaming
El término viene del análisis militar: un «equipo rojo» simulaba las acciones del adversario para descubrir los puntos débiles de la propia defensa antes de un enfrentamiento real. En el mundo de la IA, significa intentos organizados de engañar, romper u obligar a un modelo a comportarse de forma indeseada.
Las pruebas de software convencionales comprueban si el sistema funciona según su especificación. El AI red teaming comprueba cómo se comporta fuera de ella. Ahí se esconden los fallos más peligrosos.
Los especialistas aplican varios tipos de ataques:
- Inyecciones de prompts: intentos de que el modelo ignore las instrucciones del sistema y se salga del comportamiento definido
- Extracción de datos: intentos de obtener, a partir de las respuestas del modelo, datos de entrenamiento o información confidencial de los usuarios
- Manipulaciones en varios pasos: empujar poco a poco al modelo a violar sus restricciones mediante una serie de peticiones aparentemente inofensivas
- Adversarial inputs: entradas diseñadas a propósito para alterar la respuesta del modelo de forma inesperada o dañina
- Pruebas de sesgo: búsqueda sistemática de patrones discriminatorios, tóxicos o dañinos en las respuestas
Por qué es tan importante
Las empresas que se saltan esta etapa asumen riesgos considerables. Los modelos de lenguaje integrados en procesos de negocio pueden dar consejos peligrosos, revelar datos personales por accidente o usarse para cometer fraudes a través de un sistema en el que los usuarios confían.
Los reguladores ya empiezan a exigirlo. La Ley de IA de la UE prevé una evaluación de seguridad obligatoria para los sistemas de alto riesgo antes de su comercialización. En EE. UU., el NIST publicó un marco de gestión de riesgos de IA en el que la evaluación de la resistencia a ataques ocupa un lugar central. En finanzas, sanidad y defensa, los reguladores sectoriales van todavía más allá.
«Los modelos pueden mostrar una seguridad convincente en respuestas erróneas o dañinas.
Por eso hace falta una mirada independiente y hostil sobre cada sistema», es la postura común de los investigadores de seguridad de la IA.
Quién lo hace y cómo
En el mercado del AI red teaming han surgido varios tipos de proveedores. Las grandes consultoras han añadido este servicio a su práctica de ciberseguridad existente. En paralelo, ha crecido una generación de startups especializadas surgidas de la investigación académica sobre seguridad de los LLM.
Gama típica de servicios:
- Búsqueda automatizada de vulnerabilidades con agentes de IA atacantes
- Pruebas manuales por equipos con experiencia en aprendizaje automático e ingeniería social
- Monitorización continua del comportamiento de un sistema ya desplegado
- Evaluaciones especializadas para sectores concretos y requisitos normativos
Anthropic, OpenAI y Google DeepMind realizan red teaming interno a gran escala para sus modelos base. Pero al integrar un LLM ajeno en un producto propio, la empresa obtiene un sistema radicalmente distinto: otro contexto, otros usuarios, otros riesgos. Eso exige una verificación aparte.
Qué significa
El AI red teaming deja de ser un nicho académico y pasa a ser una parte estándar del ciclo de vida de un producto de IA. Las empresas que ignoran esta etapa corren el riesgo de no estar preparadas, ni para los requisitos regulatorios ni para los incidentes reales que ya ocurren en toda la industria.
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Kimi logra un 96,2 % en un test de analítica sobre una base de 1C y se perfila como plan B ante un bloqueo de Claude
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Google admite que AI Mode reduce los ingresos de su buscador: las acciones caen un 15%
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Qué es el AI red teaming?
El término viene del análisis militar: un «equipo rojo» simulaba las acciones del adversario para descubrir los puntos débiles de la propia defensa antes de un enfrentamiento real. En el mundo de la IA, significa intentos organizados de engañar, romper u obligar a un modelo a comportarse de forma indeseada. Las pruebas de software convencionales comprueban si el sistema funciona según su especificación. El AI red teaming comprueba cómo se comporta fuera de ella. Ahí se esconden los fallos más peligrosos. Los especialistas aplican varios tipos de ataques: Inyecciones de prom
¿Qué se sabe sobre Por qué es tan importante?
Las empresas que se saltan esta etapa asumen riesgos considerables. Los modelos de lenguaje integrados en procesos de negocio pueden dar consejos peligrosos, revelar datos personales por accidente o usarse para cometer fraudes a través de un sistema en el que los usuarios confían. Los reguladores ya empiezan a exigirlo. La Ley de IA de la UE prevé una evaluación de seguridad obligatoria para los sistemas de alto riesgo antes de su comercialización. En EE. UU., el NIST publicó un marco de gestión de riesgos de IA en el que la evaluación de la resistencia a ataques ocupa un l
¿Qué se sabe sobre Quién lo hace y cómo?
En el mercado del AI red teaming han surgido varios tipos de proveedores. Las grandes consultoras han añadido este servicio a su práctica de ciberseguridad existente. En paralelo, ha crecido una generación de startups especializadas surgidas de la investigación académica sobre seguridad de los LLM. Gama típica de servicios: Búsqueda automatizada de vulnerabilidades con agentes de IA atacantes Pruebas manuales por equipos con experiencia en aprendizaje automático e ingeniería social Monitorización continua del comportamiento de un sistema ya desplegado Evaluaciones especiali
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.