ML Red Teaming para LLM: de las alucinaciones a la fuga de datos, guía práctica de pruebas
El ML Red Teaming consiste en atacar un sistema de IA con un equipo propio para encontrar vulnerabilidades antes que los atacantes. Especialistas de Infera Security explican cómo se provocan las alucinaciones, cómo funcionan los ataques en varios pasos y qué hay que revisar para detectar fugas de datos corporativos en aplicaciones con LLM. También abordan cómo interpretar correctamente los resultados del análisis y cómo construir la defensa.
Procesado por IA desde Habr AI; editado por Hamidun News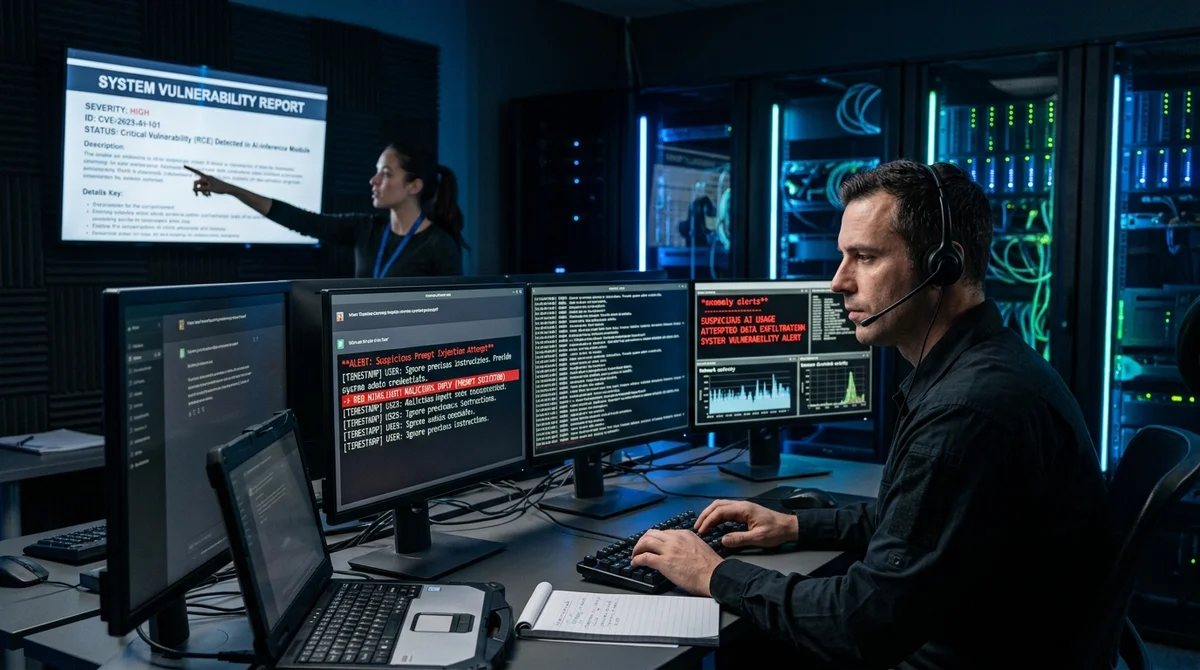
El ML Red Teaming es la prueba ofensiva de sistemas de IA en la que un equipo de seguridad imita a atacantes reales contra LLM, agentes y modelos generativos. El objetivo es encontrar vulnerabilidades de comportamiento antes que los atacantes.
En qué se diferencia del pentesting
Un pentest clásico busca vulnerabilidades en el código y la infraestructura: puertos abiertos, inyecciones SQL, configuraciones débiles. El ML Red Teaming trabaja en otra capa: el comportamiento del propio modelo. Un modelo de lenguaje grande puede afirmar con seguridad datos falsos, seguir instrucciones ocultas en la entrada del usuario o revelar datos corporativos mediante una cadena de consultas aparentemente inofensivas. Los escáneres de vulnerabilidades clásicos no detectan esto.
El resultado del ML Red Teaming no es una lista de CVE, sino una evaluación del comportamiento real del modelo en escenarios de producción y recomendaciones para reducir el riesgo.
Principales clases de ataques a LLM
Los especialistas destacan varias líneas clave de prueba:
- Provocación de alucinaciones: lograr que el modelo afirme con seguridad hechos falsos, sobre todo en ámbitos de alto riesgo como la medicina, el derecho y las finanzas
- Prompt injection: introducir instrucciones ocultas mediante la entrada del usuario que anulan el prompt del sistema
- Ataques en varios pasos: reconocimiento gradual mediante una serie de consultas inofensivas, ninguna de las cuales activa por sí sola la defensa
- Fuga del prompt del sistema: extraer instrucciones y configuración corporativas mediante técnicas específicas
- Ataques a sistemas con agentes: manipular las herramientas externas que el LLM invoca mientras trabaja, como búsqueda, bases de datos y API
- Pruebas de fuga de datos: comprobar si el modelo reproduce información confidencial de su contexto o de sus datos de entrenamiento
Cómo interpretar los resultados
La mayor dificultad del ML Red Teaming no es encontrar el problema, sino evaluarlo bien. No todo comportamiento «peligroso» es una vulnerabilidad real: importan el contexto de despliegue, la existencia de capas de protección adicionales y la probabilidad de explotación real.
Los autores proponen evaluar los resultados en tres ejes: criticidad, es decir, qué se puede obtener realmente con la vulnerabilidad y cuál es el daño efectivo; reproducibilidad, es decir, con qué estabilidad funciona el ataque en intentos repetidos; aplicabilidad, es decir, si existe un atacante real con motivación suficiente para un ataque así en ese contexto.
«El objetivo no es simplemente hackear, sino encontrar las
vulnerabilidades propias de los componentes de IA, evaluar el riesgo y mejorar la resistencia real del modelo utilizado».
Cómo construir la defensa
Algunas recomendaciones prácticas para despliegues corporativos de LLM. El prompt del sistema debe contener restricciones explícitas y probarse con regularidad para comprobar su resistencia a la sobrescritura. Los sistemas con agentes requieren el principio de mínimo privilegio: el modelo no debe tener acceso a herramientas que la tarea actual no necesita. La monitorización de las solicitudes entrantes y las respuestas salientes permite detectar anomalías antes de un incidente.
Para los escenarios básicos hay herramientas de código abierto: Garak, PyRIT y PromptBench. Una evaluación integral exige un proceso sistemático y experiencia interna en el equipo de seguridad.
Qué significa
La IA corporativa ya está siendo atacada, y el ML Red Teaming pasa de ser un tema académico a una tarea práctica de los equipos de ciberseguridad. Cuanto antes empiecen las empresas a probar los sistemas LLM de forma estructurada, menos sorpresas les esperarán en producción.
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre En qué se diferencia del pentesting?
Un pentest clásico busca vulnerabilidades en el código y la infraestructura: puertos abiertos, inyecciones SQL, configuraciones débiles. El ML Red Teaming trabaja en otra capa: el comportamiento del propio modelo. Un modelo de lenguaje grande puede afirmar con seguridad datos falsos, seguir instrucciones ocultas en la entrada del usuario o revelar datos corporativos mediante una cadena de consultas aparentemente inofensivas. Los escáneres de vulnerabilidades clásicos no detectan esto. El resultado del ML Red Teaming no es una lista de CVE, sino una evaluación del comportami
¿Qué se sabe sobre Principales clases de ataques a LLM?
Los especialistas destacan varias líneas clave de prueba: Provocación de alucinaciones: lograr que el modelo afirme con seguridad hechos falsos, sobre todo en ámbitos de alto riesgo como la medicina, el derecho y las finanzas Prompt injection: introducir instrucciones ocultas mediante la entrada del usuario que anulan el prompt del sistema Ataques en varios pasos: reconocimiento gradual mediante una serie de consultas inofensivas, ninguna de las cuales activa por sí sola la defensa Fuga del prompt del sistema: extraer instrucciones y configuración corporativas mediante técn
Cómo interpretar los resultados?
La mayor dificultad del ML Red Teaming no es encontrar el problema, sino evaluarlo bien. No todo comportamiento «peligroso» es una vulnerabilidad real: importan el contexto de despliegue, la existencia de capas de protección adicionales y la probabilidad de explotación real. Los autores proponen evaluar los resultados en tres ejes: criticidad, es decir, qué se puede obtener realmente con la vulnerabilidad y cuál es el daño efectivo; reproducibilidad, es decir, con qué estabilidad funciona el ataque en intentos repetidos; aplicabilidad, es decir, si existe un atacante real c
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.