Fix Price lanza un servicio con VLM para controlar estanterías y etiquetas de precio en 8.000 tiendas
Fix Price ha automatizado el control de estanterías y etiquetas de precio en sus más de 8.000 tiendas mediante un servicio de visión artificial basado en VLM externos. En lugar de entrenar redes neuronales propias, usa modelos multimodales ya disponibles que, a partir de una foto de la estantería, detectan huecos vacíos y errores en las etiquetas. El equipo del centro de analítica de datos de Fix Price explicó cómo puso en marcha un servicio industrial sin un largo ciclo de desarrollo de ML.
Procesado por IA desde Habr AI; editado por Hamidun News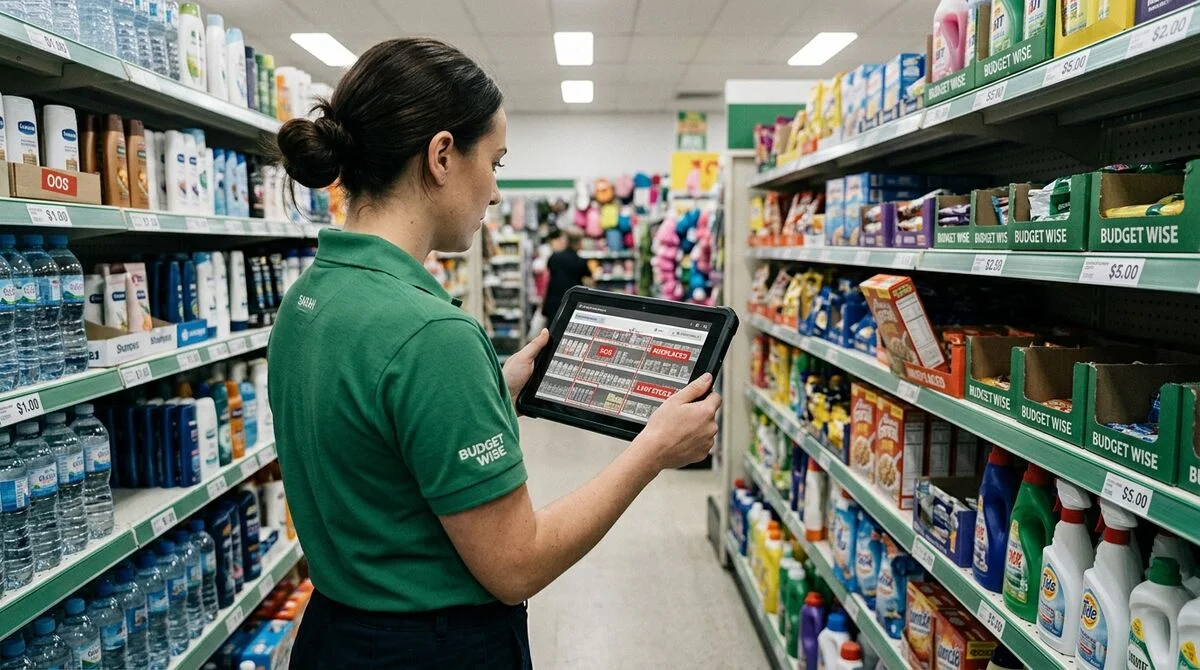
Fix Price ha automatizado el control de la exhibición de productos y de las etiquetas de precio en sus más de 8.000 tiendas al desplegar un servicio de visión artificial basado en Vision Language Models externos, sin desarrollar modelos de ML propios desde cero y sin un ciclo de entrenamiento de varios años.
8.000 tiendas, una sola tarea
Fix Price es una cadena de tiendas de precio fijo con una audiencia de decenas de millones de compradores en Rusia y la CEI. Más de 8.000 puntos de venta implican miles de estanterías que hay que revisar a diario: si los productos están colocados según el planograma, si cada artículo tiene etiqueta de precio y si hay huecos vacíos.
El control manual a esta escala es inviable: no se puede enviar cada día a un auditor a cada una de las 8.000 tiendas. Además, el error sale caro de forma directa: una estantería vacía o una etiqueta incorrecta suponen una venta perdida en ese momento y una mala experiencia para el cliente, que se recuerda mucho tiempo. En una cadena de este tamaño, incluso un pequeño porcentaje de estos casos se traduce en pérdidas financieras notables.
El centro de analítica de datos de Fix Price se enfrentó a un reto: detectar automáticamente infracciones en la exhibición y errores en las etiquetas, con rapidez, a escala industrial y sin inversiones excesivas en una infraestructura propia de CV.
Por qué VLM y no un modelo propio
El camino clásico en visión artificial para el retail consiste en entrenar una red neuronal a medida con fotos de estanterías etiquetadas. Funciona, pero exige miles de imágenes anotadas, un equipo de ingenieros de ML, infraestructura de entrenamiento y un ciclo largo cada vez que cambia el surtido.
Fix Price optó por una alternativa: Vision Language Models (VLM) externos. Son modelos multimodales capaces de analizar una imagen y responder preguntas sobre ella en lenguaje natural, con un principio similar al de GPT-4o Vision o Claude con soporte de imágenes.
Principales ventajas del enfoque VLM en este caso:
- Arranque rápido sin un gran conjunto de datos etiquetado
- Un solo modelo revisa a la vez la exhibición, las etiquetas y la disponibilidad de producto
- Los nuevos tipos de comprobación se añaden cambiando el prompt, sin reentrenar
- Flexibilidad para ampliar a nuevas categorías y formatos de tienda
- Menores costes de desarrollo y mantenimiento que con un CV a medida
Cómo funciona el servicio
Las imágenes llegan de cámaras de vigilancia o de dispositivos móviles de los empleados de la tienda. El VLM recibe la foto y analiza el fotograma según una serie de criterios: cumplimiento del planograma, etiqueta de precio en cada artículo y ausencia de huecos vacíos en la estantería.
La salida es una lista estructurada de infracciones vinculada a una tienda concreta. El empleado responsable recibe una alerta y resuelve el problema antes de que lo vea el cliente. La rapidez de reacción aumenta y las rondas manuales con libreta se reducen.
«Creo que todos sabemos cómo reaccionan los compradores ante la falta
de una etiqueta o un precio erróneo, y qué se siente ante una estantería vacía donde no está el producto por el que has venido», afirmó Kristina Istratova, directora del centro de analítica de datos de Fix Price.
Qué significa
El caso de Fix Price muestra que los VLM han reducido tanto la barrera de entrada a la visión artificial industrial que un gran minorista ha lanzado un servicio operativo sin un proyecto de ML de varios años. 8.000 tiendas no son un piloto, sino una carga real de producción. Para el resto del retail, es una señal clara: automatizar el control de estanterías ya no exige un laboratorio de ML propio.
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Google admite que AI Mode reduce los ingresos de su buscador: las acciones caen un 15%
- 31 oct 2026Un autor sometió su guion a un jurado de IA: el veredicto costó 850.000 tokens
- 31 oct 2026Anthropic: unificar subagentes en un solo bucle duplicó la velocidad de las tareas de un cliente
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre 8.000 tiendas, una sola tarea?
Fix Price es una cadena de tiendas de precio fijo con una audiencia de decenas de millones de compradores en Rusia y la CEI. Más de 8.000 puntos de venta implican miles de estanterías que hay que revisar a diario: si los productos están colocados según el planograma, si cada artículo tiene etiqueta de precio y si hay huecos vacíos. El control manual a esta escala es inviable: no se puede enviar cada día a un auditor a cada una de las 8.000 tiendas. Además, el error sale caro de forma directa: una estantería vacía o una etiqueta incorrecta suponen una venta perdida en ese mo
¿Qué se sabe sobre Por qué VLM y no un modelo propio?
El camino clásico en visión artificial para el retail consiste en entrenar una red neuronal a medida con fotos de estanterías etiquetadas. Funciona, pero exige miles de imágenes anotadas, un equipo de ingenieros de ML, infraestructura de entrenamiento y un ciclo largo cada vez que cambia el surtido. Fix Price optó por una alternativa: Vision Language Models (VLM) externos. Son modelos multimodales capaces de analizar una imagen y responder preguntas sobre ella en lenguaje natural, con un principio similar al de GPT-4o Vision o Claude con soporte de imágenes. Principales ven
Cómo funciona el servicio?
Las imágenes llegan de cámaras de vigilancia o de dispositivos móviles de los empleados de la tienda. El VLM recibe la foto y analiza el fotograma según una serie de criterios: cumplimiento del planograma, etiqueta de precio en cada artículo y ausencia de huecos vacíos en la estantería. La salida es una lista estructurada de infracciones vinculada a una tienda concreta. El empleado responsable recibe una alerta y resuelve el problema antes de que lo vea el cliente. La rapidez de reacción aumenta y las rondas manuales con libreta se reducen. «Creo que todos sabemos cómo reac
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.