Depuración visual de redes neuronales: herramientas y técnicas
Sin una visualización adecuada, el entrenamiento de redes neuronales es una caja negra. Hay herramientas especializadas que permiten seguir métricas, gradientes y activaciones. Repasamos qué herramientas conviene usar y cómo capturar los cálculos directamente desde el modelo.
Procesado por IA desde KDnuggets; editado por Hamidun News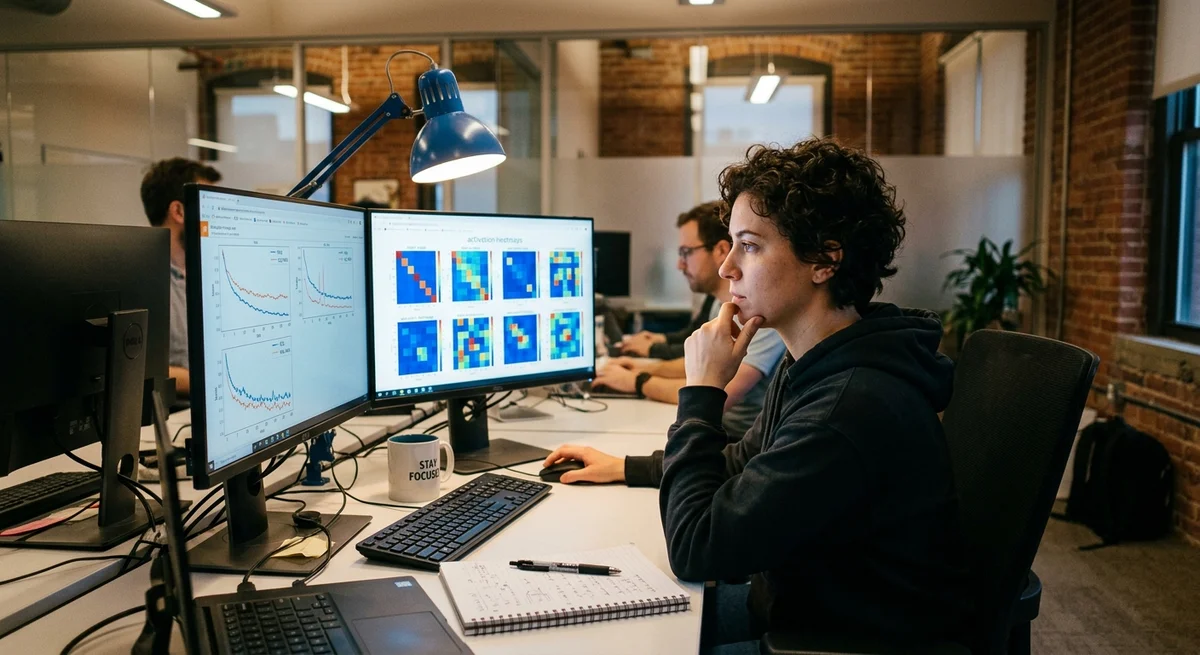
Entrenar una red neuronal a menudo se parece a volar a ciegas: la pérdida baja, pero ¿por qué? ¿De dónde salen los errores en el conjunto de validación? ¿Cómo saber qué es exactamente lo que falla: la arquitectura, los datos o la tasa de aprendizaje? Sin visualización, las respuestas solo llegan por ensayo y error, algo que cuesta mucho tiempo. Las herramientas de depuración especializadas permiten mirar dentro del modelo y ver qué ocurre en cada etapa del entrenamiento, desde los gradientes hasta las activaciones de las capas ocultas.
Qué visualizar durante el entrenamiento
Durante el entrenamiento de una red neuronal conviene seguir varias señales clave para detectar los problemas a tiempo:
- Curvas de pérdida: la evolución de la loss en los conjuntos de entrenamiento y validación muestra si el modelo sufre sobreajuste o está infraentrenado
- Distribución de los gradientes: su magnitud y su forma revelan vanishing gradients o exploding gradients
- Activaciones de las capas ocultas: qué patrones aprende cada neurona y si hay neuronas ReLU muertas
- Distribución de los pesos de los parámetros: cómo cambian los pesos capa a capa y si se quedan congelados en sus valores iniciales
- Matrices de confusión y métricas por clase: dónde se equivoca exactamente el modelo y si los errores están desequilibrados
Sin visualizar estas señales, el ingeniero trabaja a oscuras. Puede obtener la precisión final, pero quedan muchas preguntas que solo se resuelven a simple vista.
Herramientas de visualización
En la práctica se usan varios estándares.
TensorBoard es una herramienta de Google integrada en TensorFlow y PyTorch. Genera gráficas interactivas de pérdida e histogramas de pesos en tiempo real, permite proyectar datos de alta dimensión (embeddings) en 2D mediante t-SNE y consultar las gráficas en el navegador en localhost:6006.
Weights & Biases es un servicio en la nube con dashboards muy cuidados, comparación de experimentos integrada (qué hiperparámetro dio el mejor resultado) y tablas de artefactos.
Hay otras herramientas: Tensorboard X, Visdom, Neptune, MLflow; la elección depende de la escala y del presupuesto. Para experimentos puntuales, muchas veces basta con matplotlib y pandas.
Capturar los cálculos directamente con hooks y profiling
Registrar métricas agregadas es solo la mitad de la depuración. A menudo hay que mirar dentro de capas concretas con ejemplos concretos.
PyTorch ofrece el mecanismo de hooks: se puede registrar un callback que se ejecuta en la pasada hacia delante (forward hook) o en la pasada hacia atrás (backward hook) por una capa determinada. Así se capturan activaciones, gradientes y salidas de neuronas sobre la marcha, sin modificar el código del propio modelo.
Para depurar modelos de PyTorch paso a paso sirven debugpy y pdb, aunque son lentos con batches grandes (no se pueden revisar 32K ejemplos uno a uno).
El profiling (torch.profiler para PyTorch, NVIDIA Nsys para código CUDA) muestra dónde pierde tiempo exactamente el modelo: en los cálculos en GPU, en la transferencia de datos entre memorias o en la sincronización de hilos. Es fundamental para optimizar modelos en producción.
Por qué importa
La depuración visual convierte el entrenamiento de una caja negra en un proceso transparente y controlable. Los ingenieros detectan los problemas una hora antes y experimentan 10 veces más rápido. Esto resulta crítico en grandes organizaciones, donde entrenar un modelo lleva horas o días: un solo día atascado en depuración cuesta miles de rublos.
- 22 nov 2026Ahrefs: una marca con diez veces más menciones en la web recibe solo 3,7 veces más en la IA
- 22 nov 2026El modo xhigh de Gemini 4 Hydrogen cuesta seis veces más que high: 23,61 céntimos frente a 3,99 por respuesta
- 22 nov 2026Analistas calcularon: en 2028, el 87% de la energía de Anthropic provendrá del gas y el 11% del carbón
- 22 nov 2026Dos jueces de IA en una prueba jurídica de 15 LLM favorecieron a los suyos: un sesgo de 0,04 puntos sobre 1
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Qué visualizar durante el entrenamiento?
Durante el entrenamiento de una red neuronal conviene seguir varias señales clave para detectar los problemas a tiempo: Curvas de pérdida: la evolución de la loss en los conjuntos de entrenamiento y validación muestra si el modelo sufre sobreajuste o está infraentrenado Distribución de los gradientes: su magnitud y su forma revelan vanishing gradients o exploding gradients Activaciones de las capas ocultas: qué patrones aprende cada neurona y si hay neuronas ReLU muertas Distribución de los…
¿Qué se sabe sobre Herramientas de visualización?
En la práctica se usan varios estándares. TensorBoard es una herramienta de Google integrada en TensorFlow y PyTorch. Genera gráficas interactivas de pérdida e histogramas de pesos en tiempo real, permite proyectar datos de alta dimensión (embeddings) en 2D mediante t-SNE y consultar las gráficas en el navegador en localhost:6006. Weights & Biases es un servicio en la nube con dashboards muy cuidados, comparación de experimentos integrada (qué hiperparámetro dio el mejor resultado) y tablas de artefactos.
¿Qué se sabe sobre Capturar los cálculos directamente con hooks y profiling?
Registrar métricas agregadas es solo la mitad de la depuración. A menudo hay que mirar dentro de capas concretas con ejemplos concretos. PyTorch ofrece el mecanismo de hooks: se puede registrar un callback que se ejecuta en la pasada hacia delante (forward hook) o en la pasada hacia atrás (backward hook) por una capa determinada. Así se capturan activaciones, gradientes y salidas de neuronas sobre la marcha, sin modificar el código del propio modelo.
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.