MarkTechPost
مصدر أخبار الذكاء الاصطناعي. تُختار المقالات وتُعدَّل من قِبَل تحرير Hamidun News.
أحدث المنشورات
أداة لـ Claude API: إطار العمل SuperClaude
يوفّر SuperClaude Framework للمطورين مكوّنات مدمجة لبناء مسارات عمل متقدمة بالذكاء الاصطناعي: أوامر ووكلاء وأنماط تشغيل وذاكرة جلسة، كلها في نظام واحد.
ذاكرة لوكلاء الذكاء الاصطناعي: نظام محلي من Tencent
فتحت Tencent المصدر البرمجي لنظام TencentDB Agent Memory، وهو نظام ذاكرة محلي لوكلاء الذكاء الاصطناعي يقلّص استهلاك الرموز (التوكنات) بنسبة 61% ويرفع الدقة بنسبة 28%.
كيف توفّر شبكة NVIDIA العصبية الجديدة الذاكرة: Gated DeltaNet-2
طوّرت NVIDIA آلية الانتباه الخطي Gated DeltaNet-2، التي تحسّن إدارة الذاكرة في نماذج اللغة الكبيرة عبر بوابتين منفصلتين للمحو والكتابة بدلًا من بوابة واحدة.
Perplexity تفتح مصدر الماسح الذكي Bumblebee لحماية شيفرات المطورين
نشرت Perplexity الشيفرة المصدرية لأداة Bumblebee، وهي أداة لفحص الثغرات في اعتماديات أنظمة المطورين دون تشغيل الشيفرة.
Gemini 3.5 للبرمجة: نموذج ذكاء اصطناعي جديد أرخص وأسرع
كشفت Google في مؤتمر I/O 2026 عن Gemini 3.5 Flash، وهو نموذج أرخص بنسبة 75% من النسخة الرائدة، وأسرع بأربع مرات، وأكثر كفاءة في البرمجة والأتمتة.
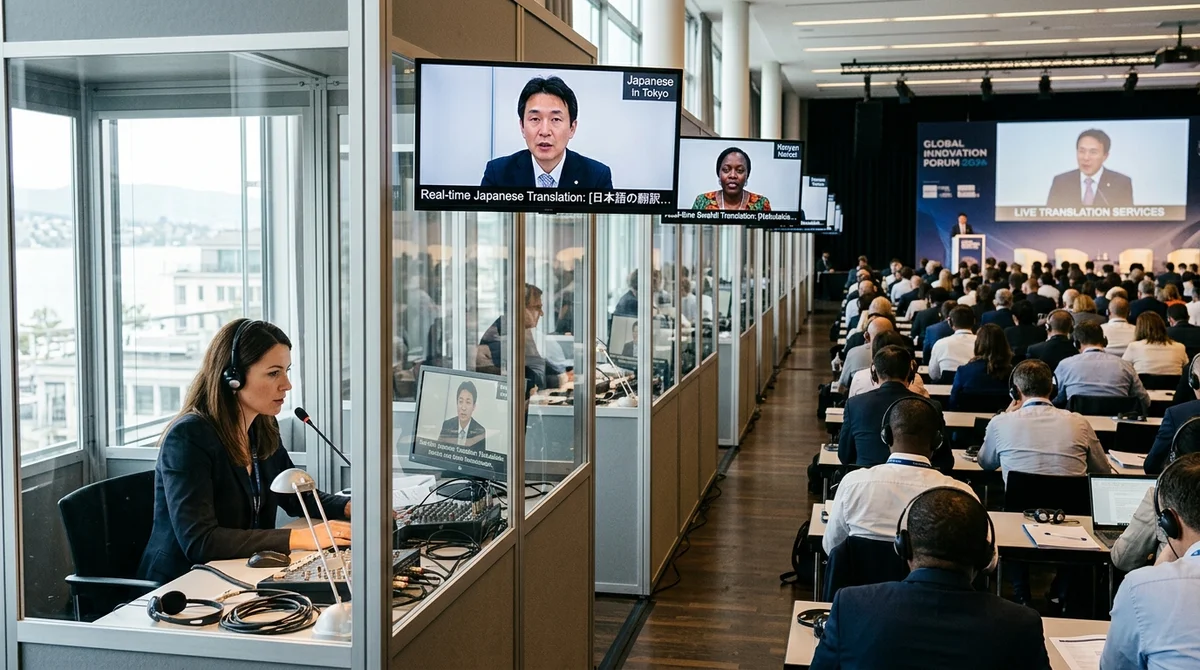
Alibaba تطلق نموذج ذكاء اصطناعي للترجمة الفورية لمقاطع الفيديو
قدّمت Alibaba نموذجًا للترجمة الفورية للفيديو والكلام في آن واحد بـ60 لغة، بأدنى قدر من التأخير ومع الحفاظ على صوت المتحدث.
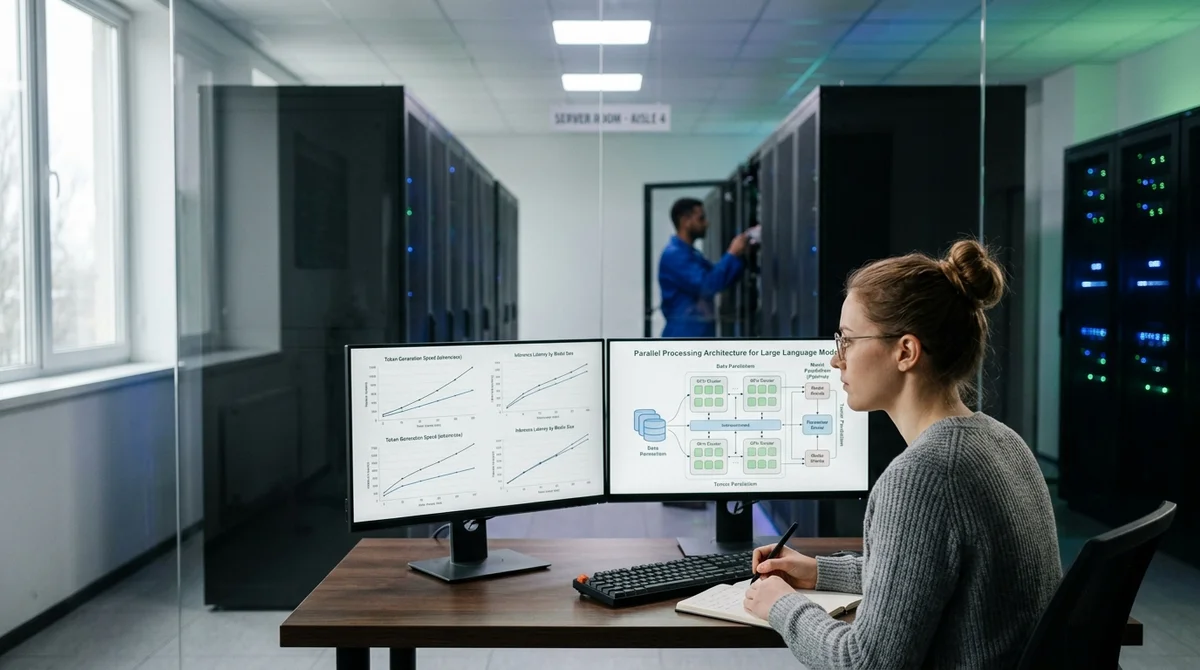
نموذج NVIDIA Nemotron النصي: ثلاثة أوضاع للتوليد
أطلقت NVIDIA نموذج Nemotron-Labs-Diffusion اللغوي الذي يجمع ثلاثة أوضاع لفك الترميز، ويعالج الرموز أسرع بست مرات من Qwen3-8B.
الرسم المعرفي لتحليل النصوص: كيف يستخرج الذكاء الاصطناعي المعلومات
دليل تطبيقي لاستخراج الكيانات والعلاقات من النصوص تلقائيًا باستخدام kg-gen، وبناء رسوم معرفية تفاعلية وتحليلها عبر NetworkX.
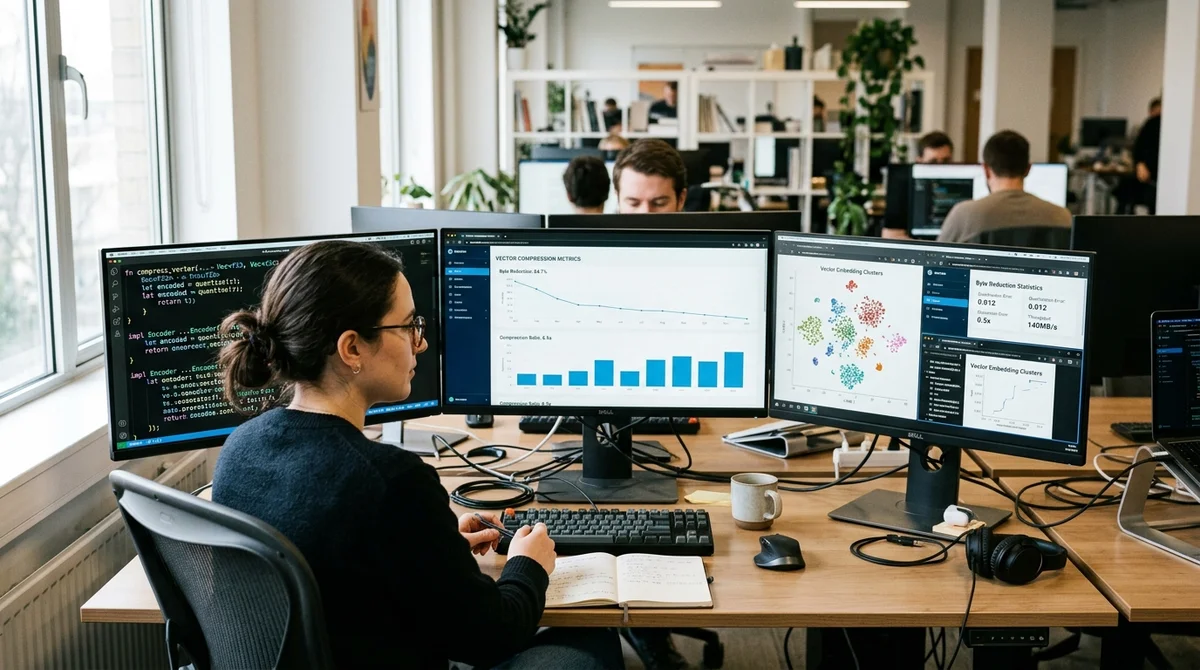
Turbovec: فهرس متجهات مكتوب بلغة Rust يعتمد خوارزمية TurboQuant من Google Research
يستخدم Turbovec خوارزمية TurboQuant من Google لضغط المتجهات 16 ضعفًا دون تدريب مسبق، ما يسهّل نشر تطبيقات RAG.
أفضل منصات الذكاء الاصطناعي الوكيلي في 2026: تصنيف يضم Salesforce وMicrosoft وغيرهما
تنتقل الشركات من المشاريع التجريبية إلى بيئة الإنتاج. أعدّ MarkTechPost تصنيفًا لأفضل 10 منصات للذكاء الاصطناعي الوكيلي، بينها Salesforce Agentforce وMicrosoft Copilot Studio وServiceNow، مع أسعار موثّقة وبيانات تطبيق فع
NVIDIA تبتكر طريقة لتدريب الشبكات العصبية بدقة 4 بت
كشفت NVIDIA عن NVFP4، منهجية لتدريب النماذج الكبيرة بدقة 4 بت بدلًا من 8 بت المعتادة، وتوفّر نصف الذاكرة دون خسارة في الجودة.
OpenAI تكشف عن بروتوكول MRC لشبكات الحواسيب العملاقة التي تضم ملايين وحدات GPU
أطلقت OpenAI بروتوكول MRC، وهو بروتوكول شبكي مفتوح لعناقيد الذكاء الاصطناعي الضخمة يوزّع البيانات على مئات المسارات ويتعافى من الأعطال في غضون ميكروثوانٍ، ما يتيح بناء حواسيب عملاقة بأكثر من 100 ألف وحدة GPU.
Meta AI تقدّم NeuralBench: إطار عمل لاختبار نماذج النشاط الدماغي
أطلقت Meta إطار NeuralBench المفتوح للاختبار الموحّد لنماذج الذكاء الاصطناعي المبنية على تخطيط الدماغ (EEG)، ويضم 36 مهمة و94 مجموعة بيانات و13,603 ساعات من التسجيلات الدماغية.
كيف تضغط نموذجًا لغويًا إلى الثلث: دليل عملي لـ FP8 وGPTQ وSmoothQuant
حصل المطورون على دليل خطوة بخطوة لضغط النماذج اللغوية الكبيرة عبر llmcompressor، مع مقارنة كفاءة تكميم FP8 وGPTQ وSmoothQuant لتخفيف الحمل عن العتاد.
OpenAI تطلق ثلاثة نماذج صوتية: الترجمة والتفريغ النصي والاستدلال في الوقت الفعلي
وسّعت OpenAI واجهة Realtime API بثلاثة نماذج صوتية جديدة لمعالجة الكلام: وكلاء الاستدلال، والترجمة متعددة اللغات، والتفريغ النصي المتدفق.
Anthropic تطوّر أداة لترجمة «أفكار» Claude إلى لغة بشرية
طوّرت Anthropic تقنية Natural Language Autoencoders التي تحوّل التنشيطات الداخلية لنموذج Claude إلى شروحات نصية، وتكشف بذلك آلية عمل الشبكة العصبية.
نموذج NVIDIA Star Elastic: توفير بمقدار 360 ضعفًا في التدريب
كشفت NVIDIA عن طريقة Star Elastic التي تجمع ثلاثة نماذج بأحجام مختلفة في checkpoint واحد، وتتدرب بكفاءة أعلى بمقدار 360 مرة.

NVIDIA تطلق cuda-oxide: مُترجِم لشيفرة Rust على وحدات GPU
فتحت NVIDIA مصدر cuda-oxide، وهي أداة تترجم دوال Rust مباشرة إلى شيفرة PTX لوحدات GPU. وهذا يبسّط تطوير تطبيقات CUDA بلغة Rust ويجعل الحوسبة المتوازية أكثر إتاحة.
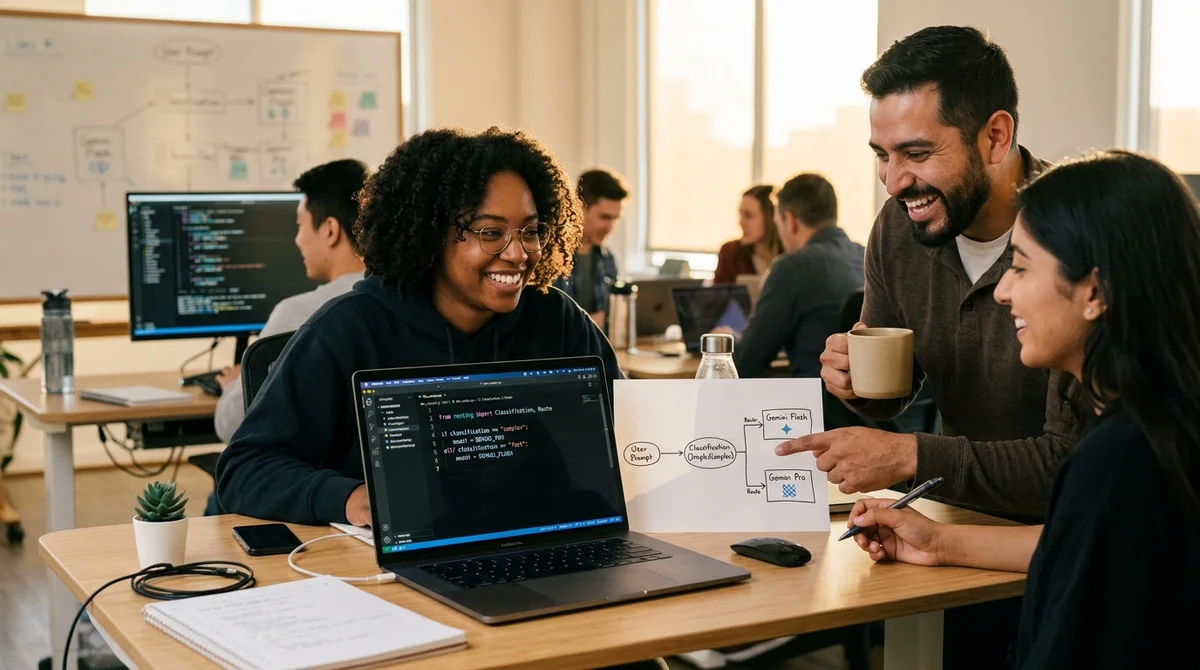
NadirClaw: خفض تكاليف الذكاء الاصطناعي عبر توجيه الطلبات
NadirClaw أداة للتوجيه الذكي للمطالبات، تصنّف الطلبات إلى بسيطة ومعقدة وتوجّهها إلى النموذج الملائم لخفض التكاليف.
Hermes: وكيل ذكاء اصطناعي مفتوح المصدر يتصدر استهلاك الرموز على OpenRouter
تفوّق وكيل الذكاء الاصطناعي المفتوح Hermes من Nous Research على المنصة المغلقة OpenClaw واحتل المرتبة الأولى على OpenRouter بتوليد 224 مليار رمز يوميًا، في ثلاثة أشهر فقط.
أنظمة البحث بالذكاء الاصطناعي في 2026: كيف تختار بين تسعة أنظمة
أصبحت تسع قواعد بيانات متجهية رائدة بنية تحتية أساسية لأنظمة RAG ووكلاء الذكاء الاصطناعي. مراجعة للبنية والسعر وقابلية التوسع تساعد على الاختيار بحسب المهمة.
الذكاء الاصطناعي للبرمجة: لغة Zero من Vercel
أطلقت Vercel لغة البرمجة Zero، التي يُصدر مترجمها (compiler) مخرجات بصيغة JSON بدل النص، ليتمكن وكلاء الذكاء الاصطناعي من كتابة البرامج الأصلية وإصلاحها ونشرها بأنفسهم.
كيف تبني Memori ذاكرة دائمة للوكلاء ونماذج LLM متعددة الجلسات
Memori بنية تحتية للذاكرة في تطبيقات LLM، تتيح للوكلاء الاحتفاظ بالسياق بين الجلسات والعمل مع عدة مستخدمين في آن واحد.
SHAP للتعلم الآلي: مقارنة بين المفسِّرات (explainers) ودليل عملي
دليل جديد يوضح كيفية الاختيار بين أربع طرق في SHAP لتفسير النماذج، من طريقة Tree السريعة إلى طريقة Kernel الشاملة.
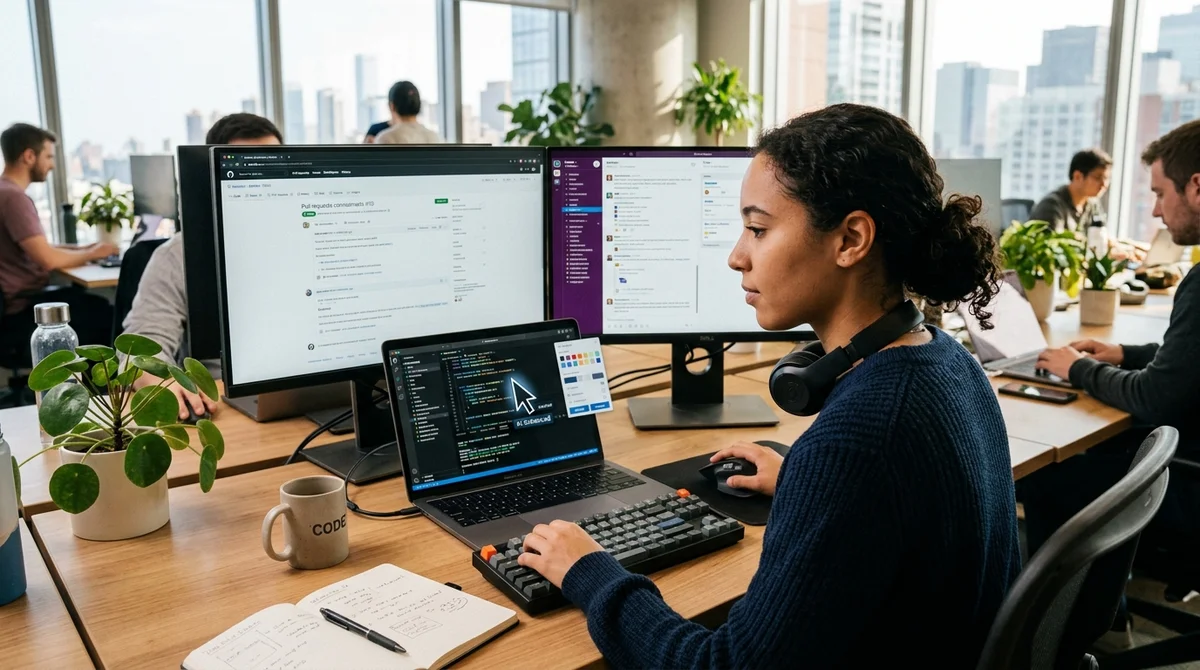
DeepMind تبتكر فأرة ذكية مدعومة بـ Gemini كي لا يضطر المستخدمون إلى التنقل بين نوافذ الدردشة
كشفت Google DeepMind عن فأرة ذكية تعمل بـ Gemini، تحلّل السياق المحيط بالمؤشر وتتيح إعطاء الأوامر بالصوت دون فتح نافذة منفصلة.
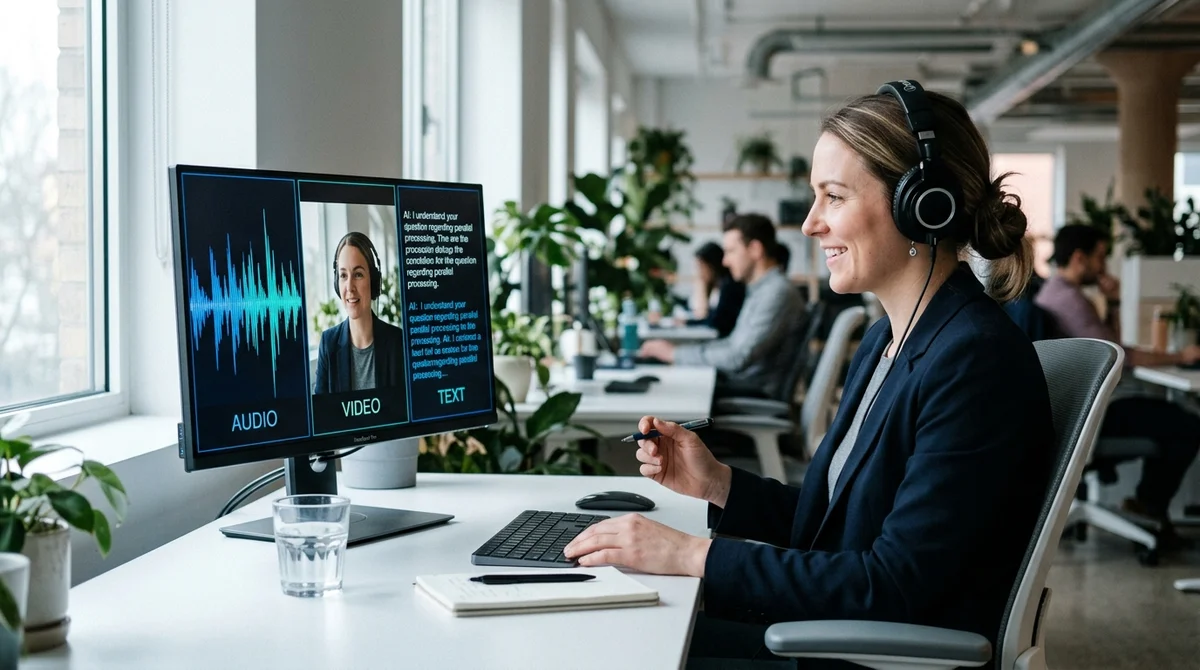
ميرا موراتي تكشف عن أول نظام للحوار الطبيعي مع الذكاء الاصطناعي في الزمن الحقيقي
كشفت Thinking Machines Lab عن نموذج TML-Interaction-Small الذي يستمع ويرد في آن واحد، ويعالج الكلام والفيديو والنص دون تأخير، في سابقة تتيح للذكاء الاصطناعي أن يتحدث كما يتحدث البشر.
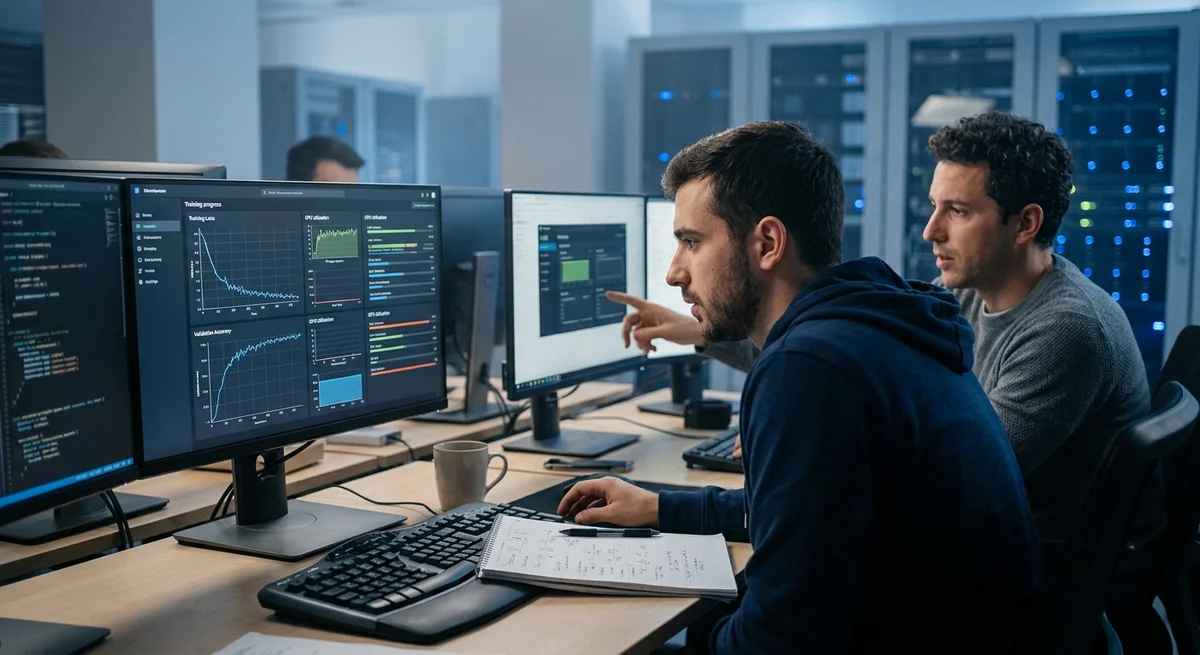
Nous Research تقدّم Lighthouse Attention لتسريع تدريب نماذج LLM
نشرت Nous Research آلية انتباه جديدة باسم Lighthouse Attention تسرّع تدريب النماذج اللغوية الكبيرة بمعدل 1.4–1.7 مرة عند العمل مع السياقات الطويلة.
GLiGuard من Fastino Labs: نموذج أمان أسرع بـ16 ضعفًا من منافسيه الكبار
أتاحت Fastino Labs نموذج GLiGuard مفتوح المصدر بـ300 مليون معلمة، وهو يفحص الأوامر النصية وفق أربعة معايير في تمريرة واحدة ويعمل أسرع بـ16 مرة من نظرائه.
الذكاء الاصطناعي الخفي في 63% من الشركات: الأدوات تسبق السياسات المؤسسية
لا تزال معظم الشركات بلا سياسات رسمية لإدارة الذكاء الاصطناعي، بينما يعتمد الموظفون الأدوات بأنفسهم، ما يخلق مخاطر أمنية جسيمة.
Nous Research تسرّع التدريب المسبق لنماذج LLM بمقدار 2.5 مرة دون تغيير البنية المعمارية
طوّرت Nous Research طريقة Token Superposition Training التي تقلّص زمن التدريب المسبق للنماذج اللغوية 2.5 مرة، دون تغيير البنية المعمارية أو سلوك النموذج أثناء الاستدلال.