Alibaba تطلق نموذج ذكاء اصطناعي للترجمة الفورية لمقاطع الفيديو
قدّمت Alibaba نموذج Qwen3.5-LiveTranslate-Flash للترجمة الفورية للفيديو والصوت في آن واحد. يدعم النموذج 60 لغة إدخال و29 لغة إخراج بزمن تأخير يبلغ 2.8 ثانية. يستنسخ النموذج صوت المتحدث، ويفهم تعابير وجهه والنص الظاهر على الشاشة، ما يجعل الترجمة طبيعية وحيّة قدر الإمكان. وعلى اختباري FLEURS وCoVoST2 تفوّق على أبرز منافسيه.
معالج بواسطة الذكاء الاصطناعي من MarkTechPost؛ بتحرير Hamidun News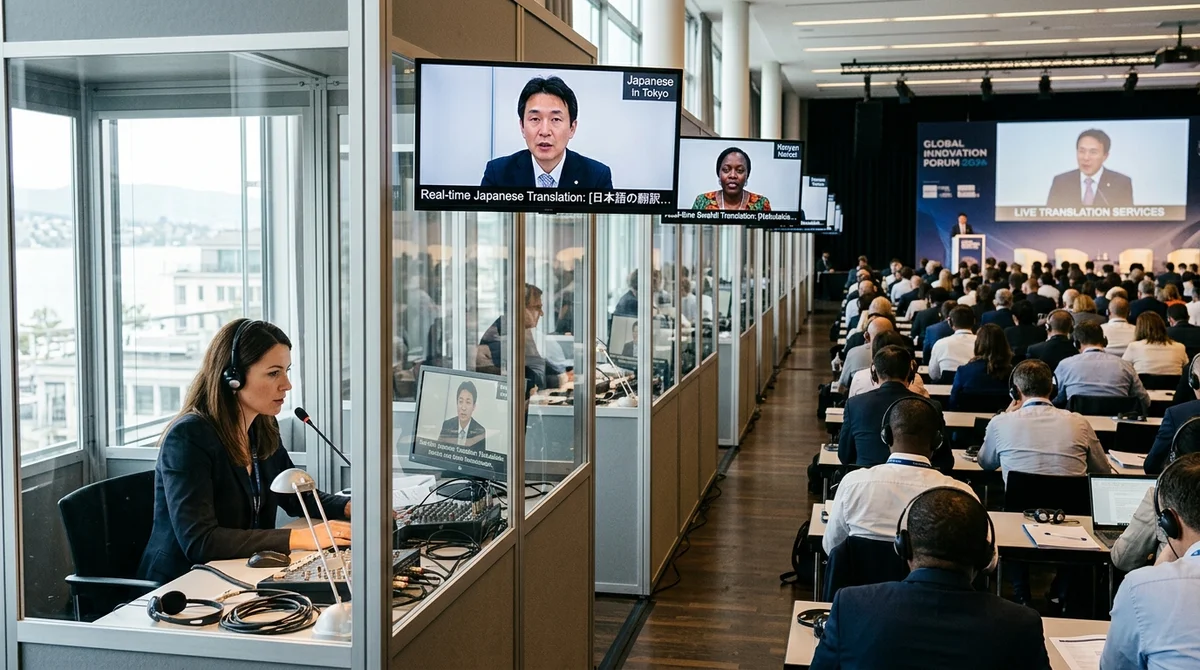
أطلقت Alibaba نموذج Qwen3.5-LiveTranslate-Flash، وهو نموذج ذكاء اصطناعي للترجمة الفورية للكلام والفيديو في الزمن الحقيقي. يدعم النموذج 60 لغة إدخال، بزمن تأخير لا يتجاوز 2.8 ثانية.
ما هو Qwen3.5-LiveTranslate ولماذا نحتاج إلى هذا النموذج؟
هو نموذج لترجمة الفيديو والصوت في آن واحد. يرى المتحدث على الشاشة، ويسمع كلامه، ثم يحوّله إلى كلام باللغة المستهدفة، مع الحفاظ على التزامن والنطق الطبيعي والعواطف.
كم لغة يدعمها نموذج Qwen لترجمة الفيديو؟
يترجم من 60 لغة إدخال، ويقدّم النتيجة بـ29 لغة، بزمن تأخير لا يتجاوز 2.8 ثانية.
ما زمن التأخير في مترجم الذكاء الاصطناعي من Alibaba؟
يبلغ زمن التأخير في نموذج Qwen3.5-LiveTranslate-Flash 2.8 ثانية فقط عند ترجمة الفيديو والكلام.
كم لغة يدعمها المترجم؟
يترجم من 60 لغة إدخال، ويقدّم النتيجة بـ29 لغة.
إلى كم لغة يترجم Alibaba Qwen3.5؟
60 لغة إدخال و29 لغة إخراج
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.