MarkTechPost
مصدر أخبار الذكاء الاصطناعي. تُختار المقالات وتُعدَّل من قِبَل تحرير Hamidun News.
أحدث المنشورات
ذكاء اصطناعي للمتصفح دون سحابة: مشروع WebBrain
WebBrain وكيل ذكاء اصطناعي مجاني بترخيص MIT لمتصفحي Chrome وFirefox، يقرأ الصفحات ويؤتمت المهام، ويعمل محليًا عبر llama.cpp أو Ollama.
xAI تطلق /goal في Grok Build: وكيل مستقل يخطط للمهام متعددة الخطوات ويتحقق من نتائجها
أضافت Grok Build وضع /goal: يتلقى الوكيل هدفًا واحدًا، ويضع بنفسه خطة التنفيذ، ويتقدم وفق قائمة مهام، ويتحقق من النتيجة في كل مرحلة حتى الاكتمال التام.
MoonMath AI تطلق نواة HIP مفتوحة المصدر لمعالج AMD MI300X تتفوق على مكتبة AITER v3 الرسمية
فتحت شركة MoonMath AI الناشئة شيفرة نواة attention لمعالج AMD MI300X، وتتفوق على مكتبة AMD الرسمية في جميع أشكال المصفوفات (tensors) وأنماط التقريب.
Cisco تطلق FAPO مفتوح المصدر: تحسين تلقائي لمسارات LLM مع تشخيص عند كل خطوة
أطلقت Cisco Foundation AI أداة FAPO مفتوحة المصدر، وهي تعمل عبر Claude Code وتحدد بنفسها الخطوة الأضعف في سلسلة الموجّهات ثم تحسّن المسار حتى بلوغ الدقة المستهدفة.
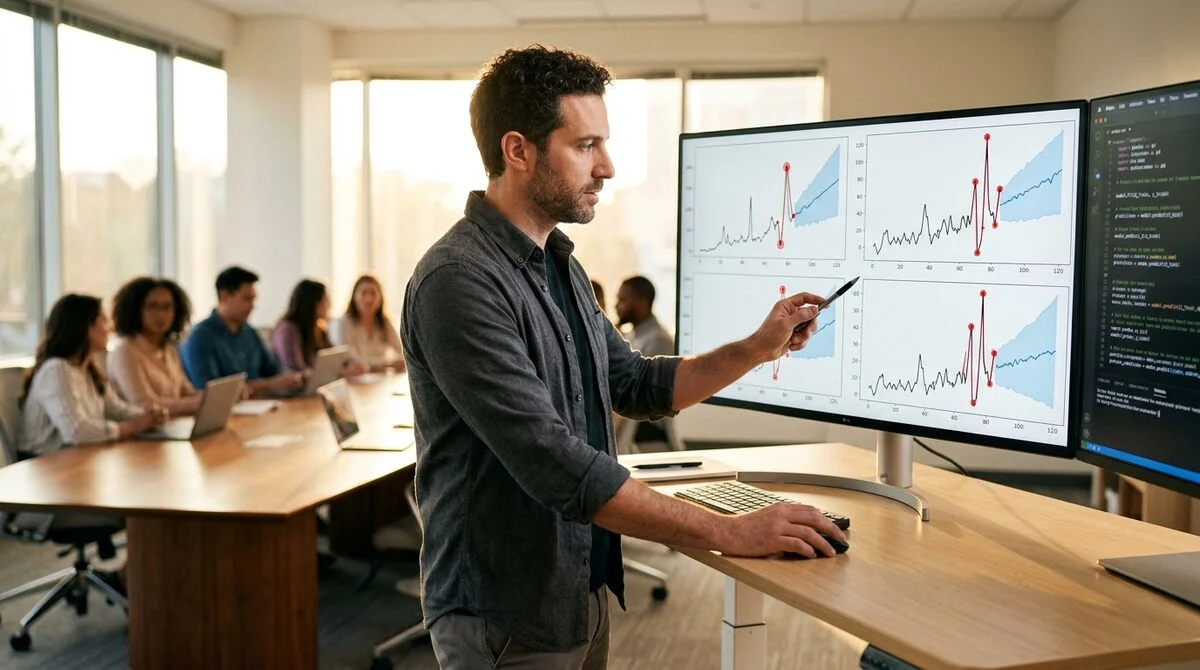
TimeCopilot: كيف تبني خط تنبؤ بالنماذج التأسيسية مع كشف الشذوذ
يتيح TimeCopilot بناء دورة تنبؤ كاملة، من النماذج الإحصائية إلى النماذج التأسيسية، مع كشف تلقائي للشذوذ ووكيل LLM يشرح التوقعات.
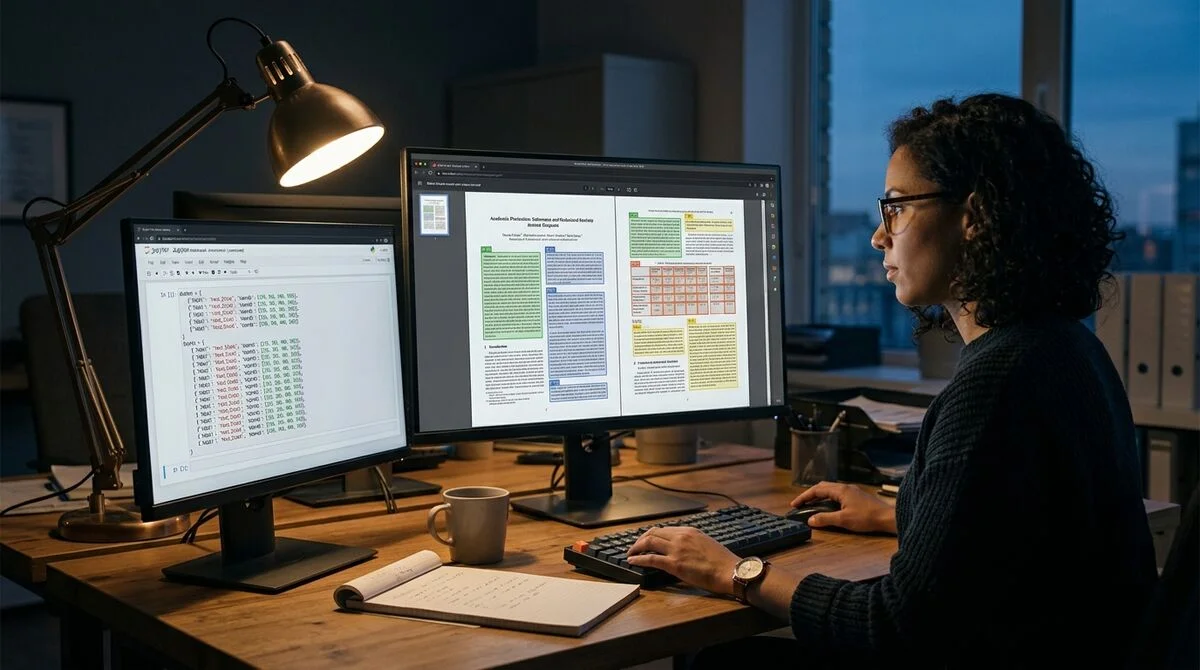
Docling Parse: مسار معالجة لتحليل ملفات PDF بدقة تصل إلى مستوى الحرف والإحداثيات
يوضح هذا الدليل كيفية استخدام Docling Parse في التحليل البنيوي لملفات PDF: إحداثيات كل كلمة، وطبقات بصرية توضيحية، وتصدير إلى JSON وCSV لأنظمة RAG.

MiniMax تطلق MSA: الانتباه المتناثر يسرّع معالجة السياق البالغ مليون رمز 28 مرة
قدّمت MiniMax آلية MSA، وهي آلية انتباه متناثر ثنائية الفروع جرى تدريبها على نموذج MoE بحجم 109 مليارات معلمة، وتعمل أسرع 28 مرة من GQA القياسي عند سياق بطول 1 مليون رمز.
North Mini Code من Cohere: نموذج MoE مفتوح بحجم 30B للبرمجة الوكيلية
أطلقت Cohere أول نموذج open-weight للمطورين، North Mini Code، بمعمارية MoE و30B معامل وسياق 256K، ويعمل على وحدة GPU واحدة من طراز H100.
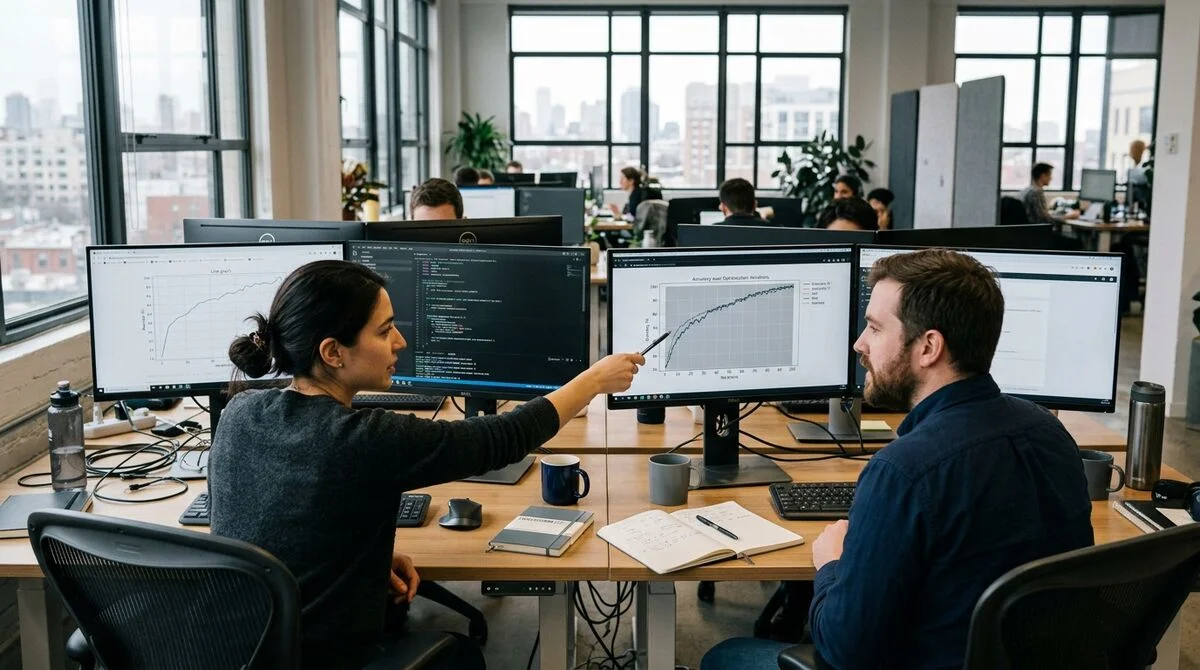
Microsoft SkillOpt: تحسين تلقائي للموجّهات النصية بدلًا من التجريب اليدوي
يحسّن Microsoft SkillOpt موجّهات الذكاء الاصطناعي عبر حلقة تلقائية من ست خطوات — التأمل والانتقاء وبوابة التحقق — ويحقق مكسبًا قابلًا للقياس في الدقة بعد التكرارات الأولى.
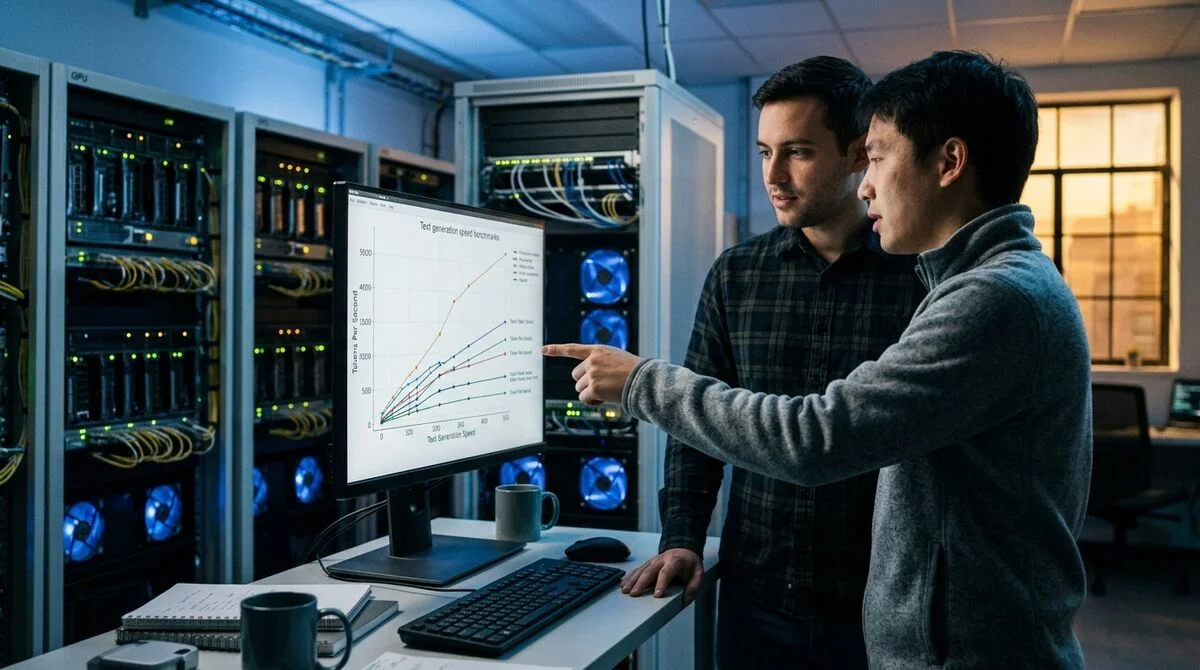
Google DeepMind تطلق DiffusionGemma: نموذج MoE بحجم 26B ينتج النص أسرع بأربع مرات
أطلقت Google DeepMind نموذج DiffusionGemma التجريبي المفتوح بحجم 26B معامل، ويعتمد على انتشار النص بدل الانحدار الذاتي، ما يسرّع التوليد حتى 4 مرات على GPU.

PyGraphistry: تحليلات الرسوم البيانية لاكتشاف التهديدات في بيانات المؤسسات
نشر باحثون مسار عمل PyGraphistry على Colab يحوّل بيانات الوصول المؤسسية إلى رسم بياني تفاعلي مع كشف الشذوذ بالتعلم الآلي وثلاثة أنماط عرض للتحقيق في الحوادث.
علي بابا تطلق Qwen3.7-Plus: وكيل متعدد الوسائط يحلّل الفيديو ويكتب الشيفرة البرمجية بشكل مستقل
أطلقت علي بابا على منصة Bailian الوكيل متعدد الوسائط Qwen3.7-Plus، وهو نموذج يرى الصور والفيديو، ويستدعي الأدوات، ويكرّر تحسين الشيفرة البرمجية بنفسه دون تدخل مشغّل.
JetBrains تطلق Mellum2: نموذج MoE مفتوح بحجم 12B للمهام السريعة في خطوط عمل الذكاء الاصطناعي
فتحت JetBrains نموذج Mellum2 بترخيص Apache 2.0، وهو نموذج MoE مدمج بـ 12 مليار معامل، دُرّب على 10.6 تريليون رمز، ومخصص للدمج في خطوط عمل الذكاء الاصطناعي متعددة النماذج.
كيف تُسرّع تدريب المحوّلات باستخدام NVIDIA Apex: FusedAdam وFusedLayerNorm وtorch.amp
دليل خطوة بخطوة لبناء NVIDIA Apex من المصدر واستخدام FusedAdam وFusedLayerNorm والدقة المختلطة، بتسريع يصل إلى 2.5× عند تدريب المحوّلات.
Anthropic تطلق Claude Fable 5 وMythos 5: نموذج واحد بمستويين من الوصول
أتاحت Anthropic نموذج Fable 5 للجميع مع مصنِّفات الأمان، بينما يقتصر Mythos 5 برفع قيود الأمن السيبراني على برنامج Project Glasswing المغلق.
كيف تبني وكيل ذكاء اصطناعي في Google Colab دون أي أطر عمل: دليل تطبيقي مع الذاكرة وMCP
دليل تطبيقي خطوة بخطوة لبناء وكيل ذكاء اصطناعي خفيف في Google Colab، مع تسجيل الأدوات وذاكرة الجلسة والمهارات وخادم MCP، دون أي أطر عمل خارجية.
OpenAI تكشف عن GPT-5.6 بثلاثة مستويات Sol وTerra وLuna ووضعين للاستدلال
أعلنت OpenAI عن عائلة GPT-5.6 التي تضم ثلاثة نماذج هي Sol وTerra وLuna، مع وضعين جديدين للاستدلال هما max وultra. الوصول إليها محصور حاليًا بمطوّرين مختارين.
Perplexity تطلق Computer for Counsel — وكيل ذكاء اصطناعي للفرق القانونية
أطلقت Perplexity وكيل ذكاء اصطناعي متخصصًا للمحامين: توجيه الطلبات عبر أكثر من 20 نموذجًا، وتكامل مع Microsoft 365 وMidpage، وإجابات مدعومة بروابط مصادر قابلة للتحقق.
NVIDIA Open-SWE-Traces: بناء بيانات لضبط وكلاء كتابة الشيفرة البرمجية
يوضح الدليل التعليمي كيفية العمل مع مجموعة بيانات NVIDIA Open-SWE-Traces: تحليل مسارات الوكلاء وفحص تصحيحات الشيفرة وبناء عينة SFT لتدريب وكلاء الذكاء الاصطناعي.
DeepSeek تطلق DSpark: إطار عمل يسرّع التوليد على DeepSeek-V4 بنسبة 57–85%
أتاحت DeepSeek الشيفرة المصدرية لـ DSpark، وهو إطار للفك التخميني (speculative decoding) لنموذج DeepSeek-V4، يسرّع التوليد بنسبة 57–85% دون فقدان في الجودة.
Meta تطلق Astryx: نظام تصميم مبني على React يدعم وكلاء الذكاء الاصطناعي وبروتوكول MCP
أطلقت Meta نظام التصميم مفتوح المصدر Astryx المبني على React وStyleX، مع خادم MCP وواجهة CLI، ليعمل المهندسون ووكلاء الذكاء الاصطناعي عبر واجهة API واحدة وبالمكونات نفسها. *Meta مصنفة منظمة متطرفة ومحظورة في روسيا.
Liquid AI تطلق LFM2.5-230M: 213 رمزًا في الثانية على Galaxy S25 ودعم لـ llama.cpp
أطلقت Liquid AI نموذج LFM2.5-230M المفتوح بحجم 230 مليون معامل، ويعمل دون اتصال بالإنترنت على الهاتف الذكي وRaspberry Pi، ويتفوق في اتباع التعليمات على منافسين أكبر منه بأربعة أضعاف.
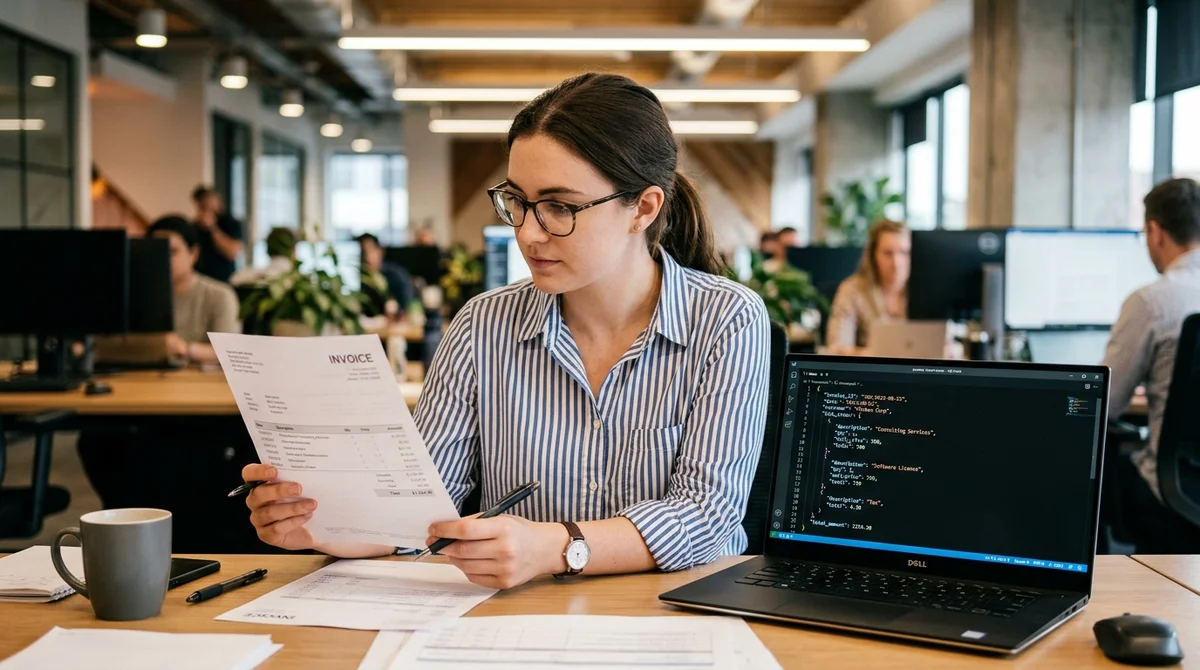
Datalab تطلق lift: نموذج بـ9 مليارات معامل مفتوح الأوزان لاستخراج JSON من ملفات PDF
أتاحت Datalab نموذج lift المرئي بـ9 مليارات معامل، وهو يحوّل ملفات PDF والصور إلى JSON منظّم وفق مخطط محدد، وحقق دقة 90,2% على مستوى الحقول في اختبار شمل 225 مستندًا.
Z.ai تطلق GLM-5.2: سياق فعلي بمليون رمز ومستويان من التفكير العميق
أطلقت Z.ai نموذج GLM-5.2 بسياق يعمل فعلياً بمليون رمز، ووضعَي High وMax، ودعم Claude Code وCline وOpenClaw عبر واجهة API متوافقة مع Anthropic.
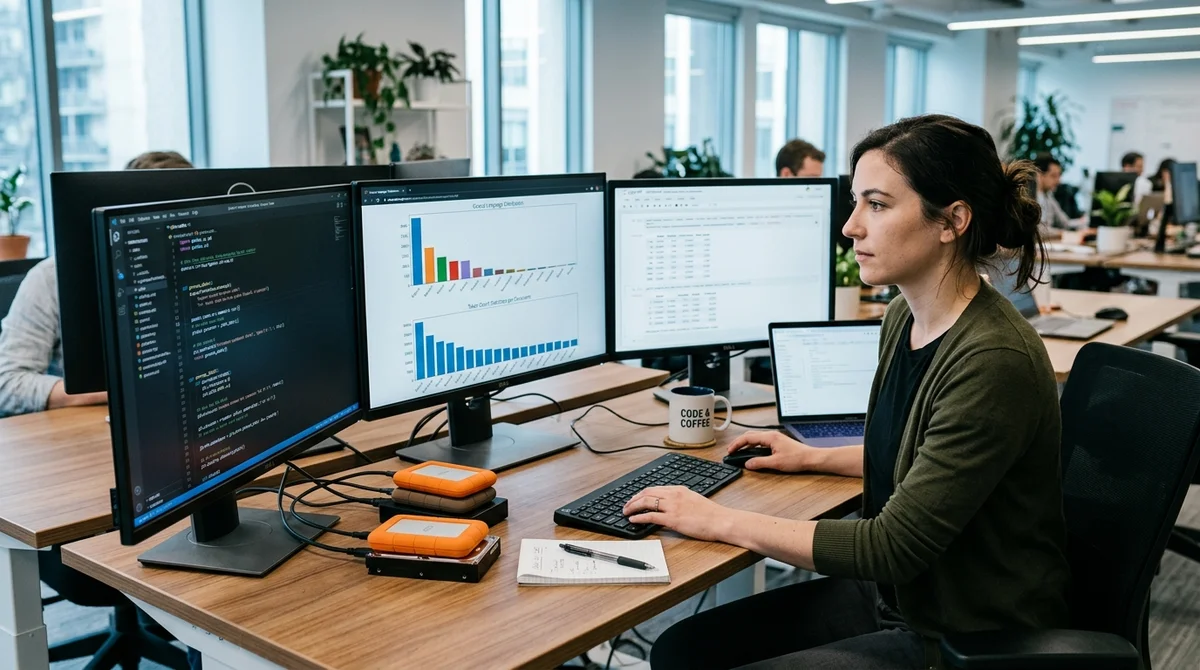
مجموعات البيانات لتدريب الشبكات العصبية: كيف تستخدم FineWeb (15 تريليون رمز)
دليل عملي لاستخدام FineWeb من Hugging Face: كيف تتعامل مع مدوّنة ويب بحجم عدة تيرابايتات لتدريب LLM عبر البث والتصفية وإزالة التكرار والترميز، دون تحميل البيانات كاملة.
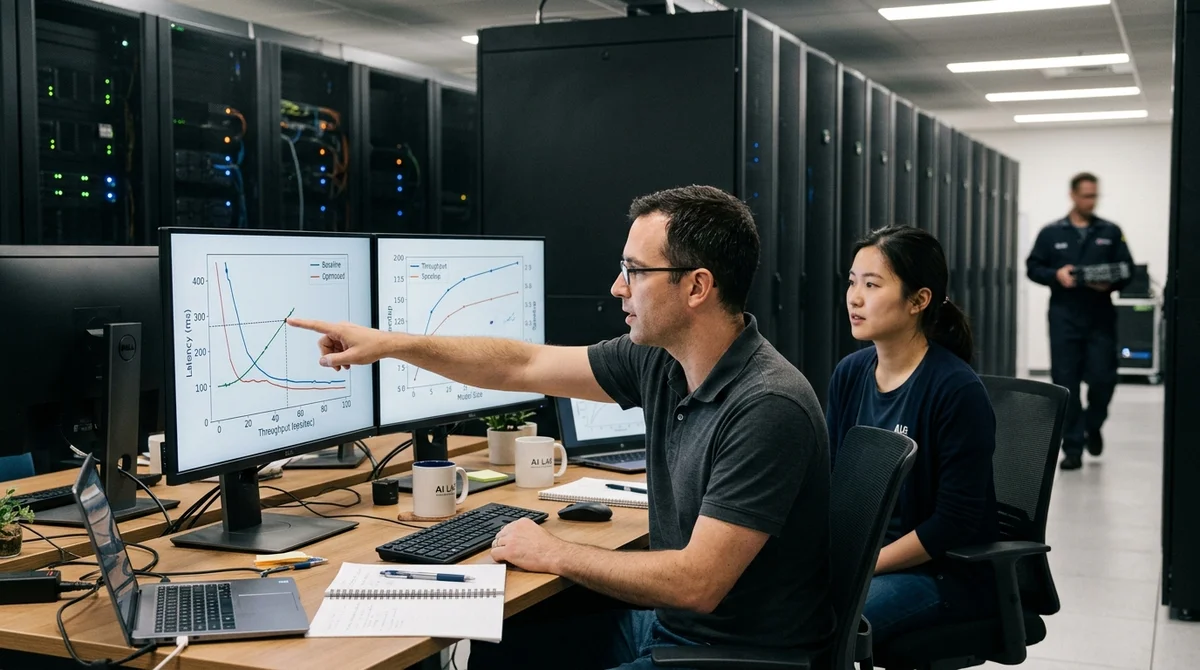
Zyphra تطلق Zamba2-VL: نماذج بصرية بزمن استجابة أسرع بعشر مرات
أطلقت Zyphra نماذج Zamba2-VL مفتوحة المصدر بحجم 1.2B و2.7B و7B معامل، بهندسة هجينة تجمع Mamba2 وTransformer وتخفض زمن الوصول إلى أول رمز بنحو 10 مرات.
Moonshot AI تطلق Kimi Work: وكيل سطح مكتب بسرب من 300 وكيل فرعي
يعمل Kimi Work من Moonshot AI محليًا على macOS وWindows، ويتحكم في المتصفح عبر WebBridge، وينسّق سربًا من 300 وكيل فرعي يعملون بالتوازي.
Claude Code: بيئة تطوير متكاملة بالذكاء الاصطناعي للمطوّر بدلًا من ChatGPT
أصدر موقع MarkTechPost دليلًا إلى Claude Code 2026 يشرح 25 ميزة، من CLAUDE.md والمهارات إلى MCP والخطافات ووضع Auto Mode، مع أمثلة برمجية وعرض تجريبي.
شبكة عصبية لـ SQL: Google تحسّن Gemini 3.1 Pro
قدّمت Google Research نموذج Gemini-SQL2 المبني على Gemini 3.1 Pro، وقد حقق دقة 80,04% على معيار BIRD المرجعي لتحويل النص إلى استعلامات SQL.
QwenPaw: ما هو وكيف تبني مساحة عمل قائمة على الوكلاء
دليل خطوة بخطوة لنشر QwenPaw، إطار عمل لبناء وكلاء الذكاء الاصطناعي يدعم عدة مزوّدين للنماذج ومهارات مخصصة وواجهة API للبث المباشر، وذلك في Google Colab.