NVIDIA Open-SWE-Traces: بناء بيانات لضبط وكلاء كتابة الشيفرة البرمجية
نشرت NVIDIA مجموعة بيانات Open-SWE-Traces التي تضم آلاف الجلسات الحقيقية لوكلاء الذكاء الاصطناعي أثناء حل مهام البرمجة. وقد استعرض الباحثون كيفية بث البيانات من Hugging Face إلى Colab، وتوحيد صيغة حوارات الوكلاء متعددة الأدوار، وتحليل التصحيحات البرمجية النهائية. كما شرحوا كيفية انتقاء الأمثلة عالية الجودة لأغراض الضبط الخاضع للإشراف (supervised fine-tuning) استناداً إلى علامات النجاح وحدود الرموز (tokens) ولغة البرمجة.
معالج بواسطة الذكاء الاصطناعي من MarkTechPost؛ بتحرير Hamidun News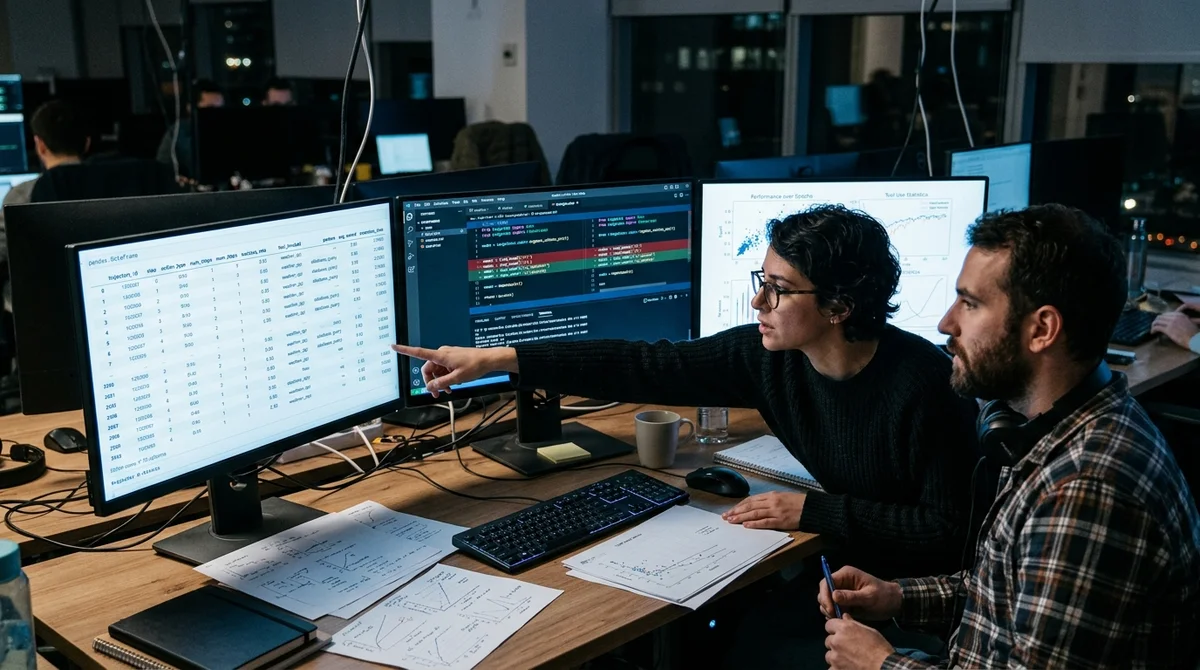
فتحت NVIDIA مجموعة بيانات Open-SWE-Traces، وهي مجموعة من الجلسات الحقيقية متعددة الأدوار لوكلاء الذكاء الاصطناعي الذين يحلّون مهام تطوير البرمجيات. ويستعرض الدليل التعليمي خط المعالجة الكامل، من بث البيانات حتى الحصول على عينة جاهزة للضبط الخاضع للإشراف (supervised fine-tuning).
ما هي Open-SWE-Traces
تضم المجموعة آلاف مسارات الوكلاء. يمثّل كل مسار تسجيلاً كاملاً لجلسة يتلقى فيها الذكاء الاصطناعي مهمة هندسية، ثم يستدعي الأدوات خطوة بعد خطوة (قراءة الملفات، وتشغيل الاختبارات، والبحث في الشيفرة)، ويكرر تحسين الحل، وينتهي بتقديم تصحيح (patch) نهائي. وهذا يختلف جوهرياً عن مجموعات بيانات الأسئلة والأجوبة المعتادة، إذ لا يُسجَّل فيها ما تحقق فحسب، بل أيضاً كيف وصل الوكيل إلى النتيجة.
ويحتوي كل سجل على بيانات وصفية منظمة:
- طول المسار، أي عدد خطوات الوكيل
- قائمة الأدوات المستخدمة وتكرار استدعائها
- حجم diff النهائي بعدد أسطر الشيفرة
- لغة البرمجة الخاصة بالمهمة
- علامة تشير إلى نجاح الحل أو فشله
وتُستضاف البيانات على Hugging Face وتدعم البث (streaming)، ما يتيح العمل معها في Google Colab دون تنزيلها كاملة، وهو أمر مهم مع حجم يبلغ عدة غيغابايت.
كيف يُبنى خط المعالجة
يقود الدليل التعليمي القارئ عبر عدة مراحل.
المرحلة الأولى هي توحيد صيغة الحوارات. تُحوَّل جلسات الوكيل متعددة الأدوار إلى صيغة موحدة، فتُرتَّب رسائل المستخدم وردود الوكيل واستدعاءات الأدوات في تسلسل واحد. وهذه الخطوة ضرورية لأن الإصدارات المختلفة من الوكلاء تسجّل الجلسات بطرق مختلفة.
المرحلة الثانية هي تحليل التصحيحات. تُستخرج من المخرجات النهائية للوكيل شيفرة التغييرات نفسها بصيغة unified diff. ويصبح هذا التصحيح «الإجابة» في المثال التدريبي.
المرحلة الثالثة هي بناء DataFrame تحليلي. تُحتسب لكل مسار مقاييس رئيسية: ميزانيات الرموز (tokens) في مراحل عمل الوكيل المختلفة، وتوزيع استخدام الأدوات، وإحصاءات النجاح بحسب اللغات وأنواع المهام.
التصفية لأغراض SFT
الخطوة الأخيرة هي انتقاء الأمثلة للتدريب. يطبّق المؤلفون سلسلة من المرشّحات.
بحسب علامات النجاح: لا تدخل العينة إلا المسارات ذات الحل الناجح. فالتدريب على الجلسات الفاشلة دون وسم خاص محفوف بالمخاطر، إذ سيتشرّب النموذج أنماطاً خاطئة.
بحسب الرموز (tokens): تُستبعد المسارات التي تتجاوز الحد المحدد. فالأمثلة الطويلة جداً لا تتسع في السياق مع إعدادات التدريب القياسية.
بحسب اللغة: إذا كان المطلوب وكيلاً متخصصاً في Python أو JavaScript، فإن التصفية تُبقي على الأمثلة ذات الصلة فقط.
بحسب وجود التصحيح: الجلسات التي تخلو من شيفرة نهائية عديمة الفائدة لمهمة SFT، لأن النموذج فيها يجب أن يتعلم إنتاج نتيجة محددة.
«جودة بيانات التدريب أهم من كميتها، وخاصة في مسارات الوكلاء، حيث قد
تُرسّخ الجلسات الفاشلة أنماطاً سيئة في النموذج».
ماذا يعني ذلك
تُعد Open-SWE-Traces من NVIDIA واحدة من أولى مجموعات البيانات العامة التي تضم مسارات حقيقية لوكلاء يعملون على مهام هندسية. ويقدّم الدليل التعليمي قالباً عملياً: من البيانات الخام على Hugging Face إلى عينة SFT جاهزة في بضعة أسطر من الشيفرة. وبالنسبة للفرق التي تبني وكلاءها البرمجيين الخاصين، فهذه نقطة انطلاق جاهزة دون الحاجة إلى جمع البيانات من الصفر.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.