MELT-1: كيف تختبر Metabolic AI قدرة الوكلاء على البقاء
نشر موقع Habr مقالاً عن MELT-1، وهو معيار اختبار لا يقيس MMLU، بل المدة التي يستطيع وكيل الذكاء الاصطناعي البقاء فيها تحت انجراف التوزيع. وسجّلت Metabolic AI نتيجة أفضل بـ1600 ضعف من Llama-7B INT8 في مهمة manipulation. المعيار مفتوح: السيناريوهات والأوراكل والأكواد متاحة للجميع.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News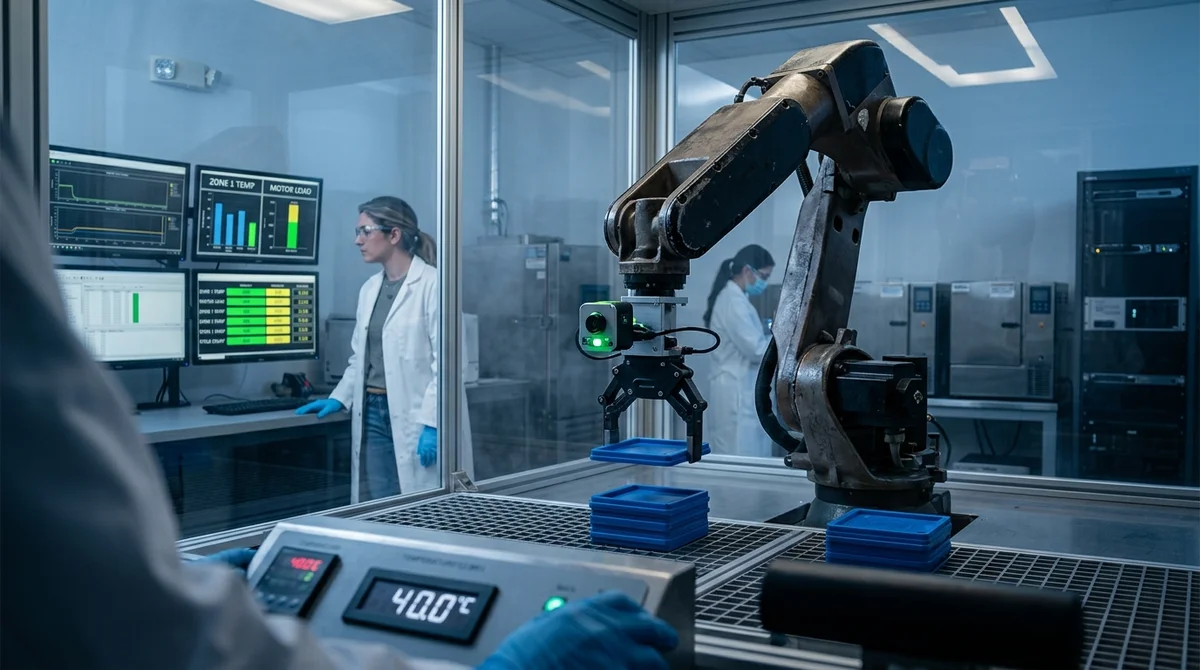
MELT-1 ليس MMLU ولا MMLU Pro. إنه معيار اختبار مفتوح جديد لتقييم وكلاء الذكاء الاصطناعي في ظروف واقعية: لا يسأل «ماذا يعرف النموذج»، بل «كم ساعة سيبقى حيًّا حين يتغير كل شيء من حوله».
ثلاثة محاور بدل رقم واحد
تفترض المعايير التقليدية (MMLU وARC وGPQA) ظروفًا مثالية: أسئلة ثابتة وتوزيعًا مستقرًا للبيانات. أما MELT-1 فيقيس ثلاثة أمور في آن واحد:
- اقتصاديات الحوسبة: كم تبلغ كلفة تشغيل الوكيل في ظروف فعلية ($/1M قرار ناجح)
- البقاء تحت الانجراف: كم ساعة يعمل الوكيل دون إعادة تدريب قبل أن يبدأ بارتكاب الأخطاء
- زمن الاستجابة تحت الضغط: زمن p99 من المستشعر إلى المشغّل عند درجة حرارة 40°C
30 يومًا من الاستدلال المتواصل، و5 بذور (seeds)، وملفان حراريان. هذا ليس اختبارًا مخبريًّا، بل سيناريو يجب أن يعمل فيه روبوت حقيقي ليلًا ونهارًا، صيفًا وشتاءً.
النتائج: فارق 1600 ضعف
في مهمة المعالجة ذات الحلقة المغلقة (closed-loop manipulation)، حيث يلتقط الروبوت الأشياء ويرتبها، تفوقت Metabolic AI، وهي بنية بلا Transformer، على نموذج من فئة Llama بحجم 7B وبدقة INT8، بـ9.4 مرة في الكلفة وبـ8.5 مرة في البقاء تحت الانجراف. وفي المقياس المركّب بلغ الفارق 1600 ضعف.
ليس السبب أن Llama نموذج سيئ، بل أن نماذج Transformer بحجم 7B صُمّمت لاسترجاع المعرفة الثابتة، لا لوكيل مجسَّد يجب إبقاؤه في حالة تشغيل دائمة على مدار الساعة طوال أيام الأسبوع.
«تنهار نماذج Transformer بعد 11 ساعة تحت الانجراف»، كما يكتب المؤلفون.
الانفتاح كمعيار
بنية Metabolic AI مغلقة (براءة الاختراع قيد الفحص)، لكن المعيار نفسه مفتوح بالكامل: بيئة الاختبار (harness) والمشاهد الاختبارية والأوراكل وسكربتات الحساسية ومشفّر VAE للانجراف لإعادة إنتاج النتائج. وتتوفر المنهجية في ملف PDF يتضمن قسمًا عن threats to validity. ويدعو الباحثون الآخرين إلى تشغيل وكلائهم ووضع نتائجهم إلى جانب النتائج المنشورة.
هذه هي الطريقة التي ينبغي أن يُمارَس بها علم التعلم العميق: ملكية فكرية مغلقة، ومعايير اختبار مفتوحة، وقابلية لإعادة الإنتاج عبر الكود.
ماذا يعني ذلك
قد يصبح MELT-1 معيارًا جديدًا في الروبوتات والذكاء الاصطناعي المجسَّد (embodied AI). يبيّن MMLU ما إذا كان النموذج «ذكيًّا»، بينما يبيّن MELT-1 ما إذا كان «قادرًا على البقاء».
- 20 نوفمبر 2026Abundant تشغّل 2 مليون صندوق رمل شهريًا وتدفع مقابل متوسط الاستهلاك لا ذروته
- 20 نوفمبر 2026GLM 5.3 المحلي يضاعف سرعة الذكاء الاصطناعي على ESP32-S3 بنسبة 100%، وQwen 3.8 27B بنسبة 30%
- 19 نوفمبر 2026MLPerf Training: عناقيد بحجم 10 240 وحدة GPU وتسريع التدريب بنسبة 49% خلال نصف عام
- 19 نوفمبر 2026SageMaker يوجّه طلبات LLM إلى وحدة GPU التي يتوفر فيها الكاش جاهزًا: أول توكن أسرع بنسبة 97%
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول ثلاثة محاور بدل رقم واحد؟
تفترض المعايير التقليدية (MMLU وARC وGPQA) ظروفًا مثالية: أسئلة ثابتة وتوزيعًا مستقرًا للبيانات. أما MELT-1 فيقيس ثلاثة أمور في آن واحد: اقتصاديات الحوسبة: كم تبلغ كلفة تشغيل الوكيل في ظروف فعلية ($/1M قرار ناجح) البقاء تحت الانجراف: كم ساعة يعمل الوكيل دون إعادة تدريب قبل أن يبدأ بارتكاب الأخطاء زمن الاستجابة تحت الضغط: زمن p99 من المستشعر إلى المشغّل عند درجة حرارة 40°C 30 يومًا من الاستدلال المتواصل، و5 بذور (seeds)، وملفان حراريان.
ما أبرز التفاصيل حول النتائج: فارق 1600 ضعف؟
في مهمة المعالجة ذات الحلقة المغلقة (closed-loop manipulation)، حيث يلتقط الروبوت الأشياء ويرتبها، تفوقت Metabolic AI، وهي بنية بلا Transformer، على نموذج من فئة Llama بحجم 7B وبدقة INT8، بـ9.4 مرة في الكلفة وبـ8.5 مرة في البقاء تحت الانجراف. وفي المقياس المركّب بلغ الفارق 1600 ضعف. ليس السبب أن Llama نموذج سيئ، بل أن نماذج Transformer بحجم 7B صُمّمت لاسترجاع المعرفة الثابتة، لا لوكيل مجسَّد يجب إبقاؤه في حالة تشغيل دائمة على مدار الساعة طوال أيام الأسبوع.
ما أبرز التفاصيل حول الانفتاح كمعيار؟
بنية Metabolic AI مغلقة (براءة الاختراع قيد الفحص)، لكن المعيار نفسه مفتوح بالكامل: بيئة الاختبار (harness) والمشاهد الاختبارية والأوراكل وسكربتات الحساسية ومشفّر VAE للانجراف لإعادة إنتاج النتائج. وتتوفر المنهجية في ملف PDF يتضمن قسمًا عن threats to validity. ويدعو الباحثون الآخرين إلى تشغيل وكلائهم ووضع نتائجهم إلى جانب النتائج المنشورة. هذه هي الطريقة التي ينبغي أن يُمارَس بها علم التعلم العميق: ملكية فكرية مغلقة، ومعايير اختبار مفتوحة، وقابلية لإعادة الإنتاج عبر الكود.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.