Hugging Face تسرّع استدلال LLM بنسبة 22% عبر المعالجة الدفعية غير المتزامنة
فتحت Hugging Face باب اللاتزامنية في استدلال LLM. فبدل أن تعمل وحدتا CPU وGPU بالتناوب، تعملان الآن بالتوازي: وبينما تحسب GPU دفعة ما، تجهّز CPU الدفعة التالية. والنتيجة تسريع بنسبة 22%. لا نوى (kernels) جديدة هنا؛ كل ما في الأمر إعادة تنظيم لتدفقات CUDA والذاكرة.
معالج بواسطة الذكاء الاصطناعي من Hugging Face Blog؛ بتحرير Hamidun News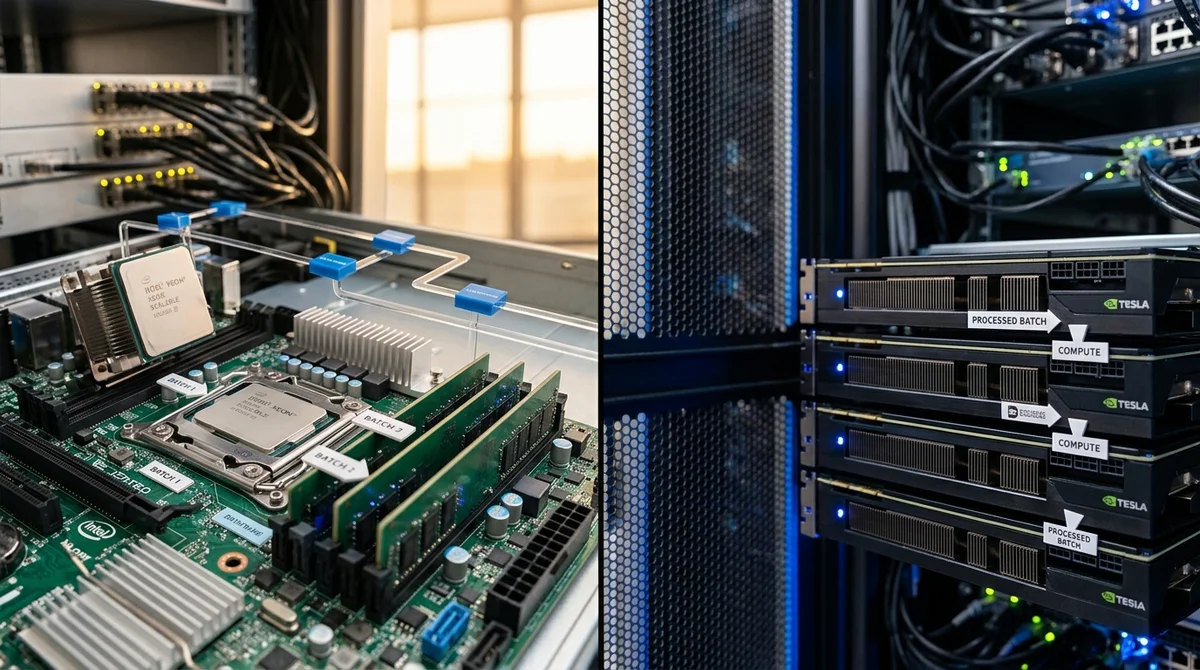
وجدت Hugging Face طريقة بسيطة لتسريع توليد الرموز في LLM بنسبة 22%: جعلت CPU وGPU تعملان في وقت واحد بدلًا من أن تنتظر إحداهما الأخرى. ولا يتطلب ذلك إعادة تدريب النماذج ولا خوارزميات جديدة.
ما المشكلة؟
في المعالجة الدفعية المتزامنة المعتادة، تجهّز CPU البيانات أولًا، ثم تحسبها GPU، ثم تنتظر CPU النتائج وتجهّز الدفعة التالية. وهكذا تبقى GPU خاملة نحو 24% من الوقت، بينما تنشغل CPU بالمعالجة المسبقة. الأمر أشبه بخط إنتاج ينظر فيه أحدهم إلى ساعته عند كل خطوة. وحتى لو عملت CPU بكامل طاقتها، فهي أبطأ من أبسط عملية حسابية على GPU، ولذلك تظل بطاقة الرسوم جالسة تنتظر بيانات جديدة.
في المعالجة الدفعية المتزامنة، ولّد نموذج بحجم 8 مليارات معامل، بدفعة من 32 طلبًا، 8 آلاف رمز خلال 300 ثانية، بينما لم يتجاوز نشاط GPU نسبة 76%.
كيف تحل اللاتزامنية المشكلة؟
الفكرة بسيطة للغاية: تشغيل CPU وGPU بالتوازي عبر تدفقات CUDA (streams). تُستخدم ثلاثة تدفقات مستقلة: الأول لنقل البيانات إلى GPU (H2D)، والثاني للحسابات نفسها (Compute)، والثالث لنقل النتائج عائدةً (D2H). ويعيد كل تدفق التحكم إلى CPU فورًا دون أن يحجبها.
وتوضع بين التدفقات أحداث CUDA (events)، وهي إشارات تضمن الترتيب الصحيح:
- يعلّم تدفق H2D اللحظة التي اكتمل فيها تحميل البيانات إلى GPU
- ينتظر تدفق Compute هذه الإشارة، ثم يحسب، ثم يضع إشارته الخاصة
- ينتظر تدفق D2H انتهاء الحسابات ثم يسحب النتائج
وبينما تحسب GPU الدفعة N، تكون CPU قد بدأت تجهيز الدفعة N+1 في مخزن ذاكرة آخر. لا انتظار هنا؛ فالوحدتان تعملان بالتوازي.
الحيلة الأساسية: carry-over
تكمن الصعوبة في أن الطلب الذي يمتد عبر عدة دفعات تتحول رموزه الناتجة من الدفعة N إلى مدخلات للدفعة N+1. وقد حلّت Hugging Face ذلك عبر عناصر نائبة (placeholders): فعند تجهيز الدفعة N+1، توضع أصفار مكان مدخلات الرموز المستقبلية، وحين تنتهي الدفعة N تُستبدل الأصفار بالقيم الفعلية.
«هذا يتيح لـ CPU تجهيز الدفعة التالية دون انتظار نتائج الدفعة الحالية»، كما توضح
Hugging Face.
ويقوم كل ذلك على رسوم CUDA البيانية (CUDA graphs) مع مجمّع ذاكرة مشترك، وهو ما يوفّر حتى في ذاكرة الفيديو.
الأرقام تتحدث عن نفسها
قبل التحسين: GPU نشطة بنسبة 76%، وتوليد 8 آلاف رمز استغرق 300.6 ثانية. بعد التحسين: GPU نشطة بنسبة 99.4%، وتوليد الرموز نفسها استغرق 234.5 ثانية. والتسريع البالغ 22% يقترب من الحد الأقصى لهذه البنية (كان الحد النظري الأقصى 24%).
ماذا يعني ذلك؟
يعني ذلك أنك لا تحتاج إلى وحدات GPU أغلى ثمنًا ولا إلى إعادة تدريب النماذج لتحقيق زيادة كبيرة في السرعة. الشيفرة موجودة بالفعل في مكتبة Transformers، في الفئة `ContinuousBatchingAsyncIOs`. وبالنسبة للشركات التي تولّد أعدادًا كبيرة من الرموز، قد يوفّر ذلك ملايين في كلفة العتاد.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.