كيف فقدت الشركات سيادتها على بياناتها في سباق الذكاء الاصطناعي
تنازلت الشركات عن سيطرتها على بياناتها مقابل قوة الذكاء الاصطناعي التوليدي. وبات ذلك مشكلة اليوم، لأن البيانات تمر عبر أنظمة لا تخضع لسيطرة الشركات. يمثّل الطريق نحو سيادة البيانات أولوية جديدة للأعمال.
معالج بواسطة الذكاء الاصطناعي من MIT Technology Review؛ بتحرير Hamidun News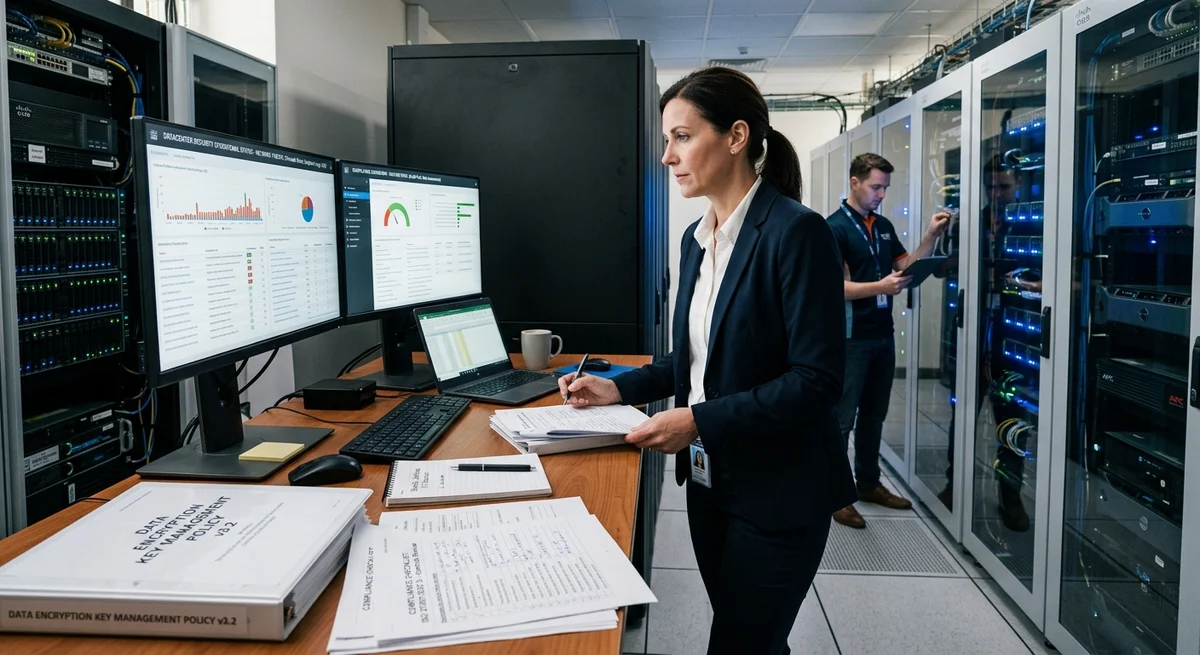
عندما خرج الذكاء الاصطناعي التوليدي من المختبرات إلى عالم الأعمال الفعلي، جرت صفقة صامتة. حصلت الشركات على إمكانية الوصول إلى نماذج قوية — ChatGPT وClaude وGemini — لكنها دفعت ثمن ذلك من سيطرتها على بياناتها.
لماذا وافقت الشركات
في عجلة من أمرها للحصول على النتائج قبل المنافسين، بدأت الشركات برفع بياناتها إلى خدمات الذكاء الاصطناعي السحابية: OpenAI وAnthropic وGoogle. وافق المحامون على ذلك (أو أغمضوا أعينهم)، بينما أبدى التقنيون إعجابهم بسرعة التبني. عملت النماذج بشكل جيد، وكانت النتائج مبهرة — وهي بالتأكيد حالة تصلح للعرض على مجلس المستثمرين.
لكن المعلومات التي كانت الشركة ترسلها كانت تمر عبر أنظمة لا تسيطر عليها. لا ضمانات لحماية الملكية الفكرية. ولا رقابة على كيفية استخدام البيانات — هل تدرّب OpenAI نماذجها عليها، أم تنقلها إلى أطراف ثالثة، أم تبيعها لشركات أخرى.
«القدرة الآن، والتحكم لاحقًا» — هذه كانت الفلسفة غير المكتوبة في تلك الأيام.
نجحت هذه المقايضة ما دام الأمر يقتصر على المشاريع التجريبية. لكن مع تغلغل الذكاء الاصطناعي في العمليات التجارية الحرجة — تحليل العملاء، وصياغة استراتيجيات التسعير، وفرز المستندات السرية — أصبحت المخاطر واضحة للعيان.
مخاطر يصعب ملاحظتها في الوقت المناسب
- تسرّب الملكية الفكرية — تنتهي المخططات السرية والشيفرات المصدرية والوثائق الاستراتيجية على خوادم يتحكم بها المزوّد، لا الشركة
- غياب الشفافية — لا تعرف الشركة ما إذا كان النموذج يتدرب على بياناتها، ولا ما إذا كان المنافسون أو المحللون يطّلعون عليها
- المخاطر القانونية — تشترط GDPR وLGPD وغيرهما من اللوائح التحكم في البيانات، لكن الأنظمة السحابية تتجاهل ذلك في كثير من الأحيان
- الاعتماد على المزوّد — إذا غيّرت OpenAI شروطها أو رفعت أسعارها، تفقد الشركة أوراق الضغط
- الميزة التنافسية — يرى المزوّد استراتيجيتك وقد يستغلها عبر تدريب نموذج يخدم مصالح منافسيك
على طريق السيادة
تبدأ الشركات بإدراك أن قوة الذكاء الاصطناعي لا تستحق خسارة السيطرة. وتظهر بدائل لم تكن موجودة من قبل.
تتحسن النماذج مفتوحة المصدر من Meta* (Llama) وMistral وغيرهما من اللاعبين كل شهر. وما كان يتطلب قبل عام عملاقًا سحابيًا، بات يمكن أن يعمل اليوم على خوادم الشركة نفسها.
المسار الثاني هو الضمانات التعاقدية. تطالب الشركات مزوّدي الذكاء الاصطناعي بالتزامات مكتوبة: عدم استخدام البيانات في التدريب، وتخزين المعلومات في منطقة جغرافية محددة، وإتاحة التدقيق. لكن ذلك لا يزيل الخطر الجوهري — فالمعلومات تبقى على خوادم الغير.
المسار الثالث هو النهج الهجين. تُعالج البيانات الحرجة محليًا على خوادم الشركة، ويمكن ائتمان السحابة على الباقي، ولكن بتحفظات. ليس الحل مثاليًا، لكنه أفضل من إرسال كل شيء بلا تمييز إلى السحابة.
ما معنى ذلك
في عام 2026 تتحول سيادة البيانات إلى ميزة تنافسية، لا مجرد مسألة تقنية. فالشركات التي حافظت على سيطرتها على معلوماتها ستتكيف بسرعة أكبر مع متطلبات الجهات التنظيمية، وستكون أقل عرضة للمخاطر.
تنتهي المقايضة الصامتة، وتبدأ حقبة يمكن فيها المطالبة بقوة الذكاء الاصطناعي والسيطرة على البيانات في آن واحد.
*Meta مصنّفة كمنظمة متطرفة ومحظورة في روسيا.
- 28 أكتوبر 2026OpenAI تطلق GPT-6.1 Terra: نصف السعر ودقة مضاعفة في البرمجة
- 28 أكتوبر 2026AWS تطلق Multi-Turn RL في SageMaker: gpt-oss-20b يرتفع من 15 إلى 69% بتكلفة $339
- 28 أكتوبر 2026ضبط Gemma 26B على MacBook بذاكرة 24 غيغابايت: مساعد يعمل دون اتصال يحقق 703 من 766
- 28 أكتوبر 202612 أداة لاختبار الاختراق ضد Juice Shop: أفضل وكيل AI اكتشف 5 ثغرات من أصل 116
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول لماذا وافقت الشركات؟
في عجلة من أمرها للحصول على النتائج قبل المنافسين، بدأت الشركات برفع بياناتها إلى خدمات الذكاء الاصطناعي السحابية: OpenAI وAnthropic وGoogle. وافق المحامون على ذلك (أو أغمضوا أعينهم)، بينما أبدى التقنيون إعجابهم بسرعة التبني. عملت النماذج بشكل جيد، وكانت النتائج مبهرة — وهي بالتأكيد حالة تصلح للعرض على مجلس المستثمرين. لكن المعلومات التي كانت الشركة ترسلها كانت تمر عبر أنظمة لا تسيطر عليها. لا ضمانات لحماية الملكية الفكرية. ولا رقابة على كيفية استخدام البيانات — هل تدرّب OpenAI نماذجها عليها، أم تنقلها إلى أطراف ثالثة، أم تبيعها لشركات أخرى. «القدرة الآن، والتحكم لاحقًا» —
ما أبرز التفاصيل حول مخاطر يصعب ملاحظتها في الوقت المناسب؟
تسرّب الملكية الفكرية — تنتهي المخططات السرية والشيفرات المصدرية والوثائق الاستراتيجية على خوادم يتحكم بها المزوّد، لا الشركة غياب الشفافية — لا تعرف الشركة ما إذا كان النموذج يتدرب على بياناتها، ولا ما إذا كان المنافسون أو المحللون يطّلعون عليها المخاطر القانونية — تشترط GDPR وLGPD وغيرهما من اللوائح التحكم في البيانات، لكن الأنظمة السحابية تتجاهل ذلك في كثير من الأحيان الاعتماد على المزوّد — إذا غيّرت OpenAI شروطها أو رفعت أسعارها، تفقد الشركة أوراق الضغط الميزة التنافسية — يرى المزوّد استراتيجيتك وقد يستغلها عبر تدريب نموذج يخدم مصالح منافسيك
ما أبرز التفاصيل حول على طريق السيادة؟
تبدأ الشركات بإدراك أن قوة الذكاء الاصطناعي لا تستحق خسارة السيطرة. وتظهر بدائل لم تكن موجودة من قبل. تتحسن النماذج مفتوحة المصدر من Meta (Llama) وMistral وغيرهما من اللاعبين كل شهر. وما كان يتطلب قبل عام عملاقًا سحابيًا، بات يمكن أن يعمل اليوم على خوادم الشركة نفسها. المسار الثاني هو الضمانات التعاقدية. تطالب الشركات مزوّدي الذكاء الاصطناعي بالتزامات مكتوبة: عدم استخدام البيانات في التدريب، وتخزين المعلومات في منطقة جغرافية محددة، وإتاحة التدقيق. لكن ذلك لا يزيل الخطر الجوهري — فالمعلومات تبقى على خوادم الغير. المسار الثالث هو النهج الهجين. تُعالج البيانات الحرجة محليًا عل
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.