الحكومة الروسية تقترح السماح بتدريب الذكاء الاصطناعي على المواد المحمية بحقوق المؤلف دون موافقة أصحابها
أدرجت الحكومة الروسية في مشروع قانون الذكاء الاصطناعي بندًا مثيرًا للجدل: قد يُسمح للمطورين بتدريب النماذج على الكتب والمقالات والأفلام والصور دون موافقة أصحاب الحقوق. ويقتصر القيد على شرط واحد، هو ألا يرى المستخدم المحتوى الأصلي المحمي. وتعتزم الحكومة في الوقت نفسه إسناد الحقوق في النتيجة النهائية إلى الإنسان، إذا أسهم بجهد إبداعي في صياغة الموجِّه (prompt) وفي تنقيح الإجابة.
معالج بواسطة الذكاء الاصطناعي من CNews AI؛ بتحرير Hamidun News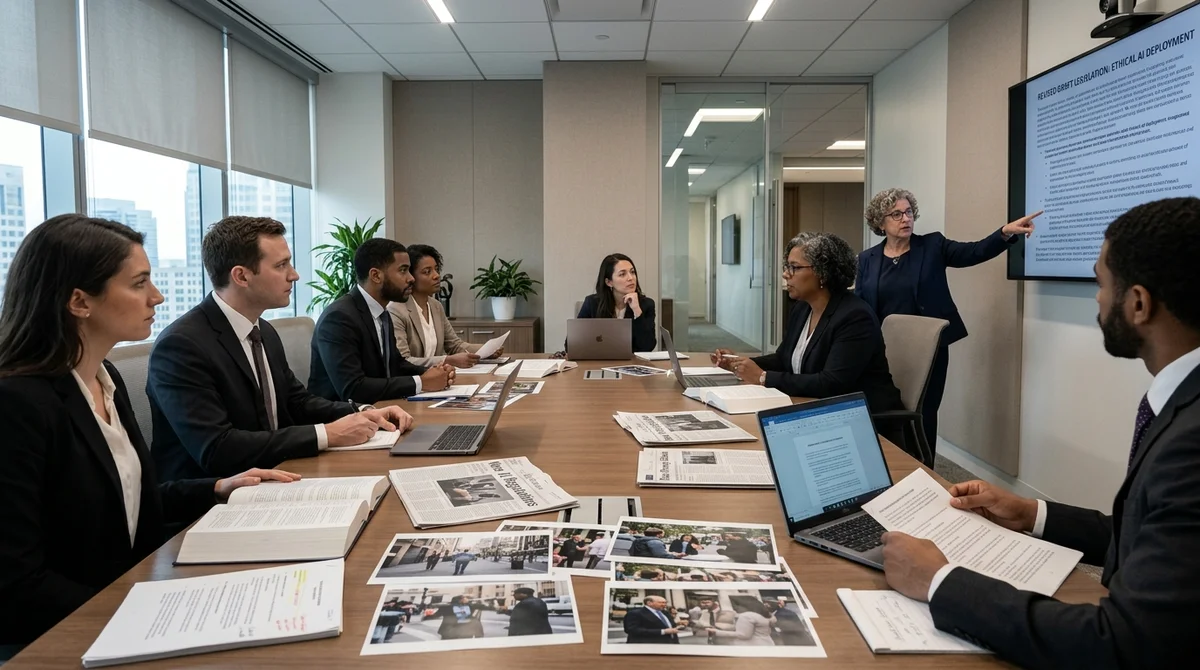
أدرجت الحكومة الروسية في مشروع قانون الذكاء الاصطناعي بندًا قد يغيّر قواعد اللعبة بشكل حاد أمام المطورين الروس للنماذج. ويقترح مجلس الوزراء السماح بتدريب الشبكات العصبية على مواد محمية بحقوق المؤلف دون موافقة أصحاب الحقوق، لكن ذلك يتم فقط في إطار مشروع قانون لم يُقرّ بعد.
ما الذي تقترحه السلطات
تقوم المبادرة على أن تتمكن الشركات من استخدام المقالات والكتب والأفلام والصور وغيرها من موضوعات حقوق المؤلف في تدريب الذكاء الاصطناعي دون إذن منفصل من المؤلف. وهناك تحفظ مهم: يجب ألا يرى مستخدم الخدمة النهائية المحتوى الأصلي لهذه المواد. أي أن الدولة تحاول إضفاء الشرعية على عملية تدريب النموذج نفسها، دون أن تفتح أمامه الطريق لتوزيع محتوى الآخرين مباشرة في واجهة المنتج. وتُعدّ هذه من أكثر التعديلات التنظيمية حساسية بالنسبة للسوق في الآونة الأخيرة.
ويتضمن مشروع القانون بندًا جوهريًا ثانيًا: تريد السلطات إسناد الحقوق في ناتج عمل الذكاء الاصطناعي إلى المستخدم، إذا لم يكتفِ بإدخال طلب، بل قدّم إسهامًا إبداعيًا فعليًا، فصاغ الموجِّه (prompt) وعالج الإجابة ونقّح النتيجة النهائية. وهذه محاولة لتحديد مسبقًا لمن تعود القيمة الناتجة، في وقت يتجادل فيه السوق حول الحد الذي ينتهي عنده التوليد الآلي ويبدأ عنده العمل الإبداعي للإنسان. وبعبارة أخرى، يحاول المشرّعون تثبيت دور الإنسان في النتيجة النهائية.
أين تقع الحدود
وفقًا لما نُشر، يتعلق الأمر في المقام الأول بمجموعات البيانات التي تكتسب أهمية خاصة لتدريب النماذج القوية، لكن وصول الفرق الروسية إليها محدود: النصوص العلمية والمواد التعليمية والوثائق الأرشيفية. ومنطق السلطات بسيط: سوق البيانات المحلية أصغر مما هو لدى اللاعبين العالميين، ودون توسيع الوصول إلى المحتوى ستتخلف الخدمات الروسية في الجودة وسرعة التطور. وينطبق ذلك بوجه خاص على الفرق التي تبني نماذج لغوية كبيرة ونماذج متعددة الوسائط.
- يُراد السماح باستخدام المقالات والكتب والأفلام والصور في التدريب دون موافقة منفصلة من المؤلف
- لا يجوز أن يرى المستخدم المحتوى الأصلي المحمي
- تعتزم السلطات منح الحقوق في النتيجة النهائية للإنسان، لا للنموذج
- لا تشمل التسهيلات البيانات الشخصية والمراسلات الخاصة والمعلومات الضريبية
- لم تُنشر النسخة النهائية من القانون بعد
ومع ذلك، لا يبدو هذا التخفيف مطلقًا. فقد شدد ممثلو الحكومة سابقًا على أن النسخة النهائية من الوثيقة لم تُعدّ بعد، وأن أي تقنية يجب أن تُطبّق مع مراعاة حقوق المواطنين ومصالحهم. وهذا يعني أن آلية الوصول إلى البيانات والاستثناءات والمسؤولية المستقبلية ستظل موضع مساومة بين المطورين وأصحاب الحقوق والجمعيات القطاعية والدولة. ومن شبه المؤكد أن أشد الخلافات ستبدأ عند مرحلة الصياغات والاستثناءات المحددة.
لماذا الأمر مثير للجدل
من الناحية القانونية، لا يزال الصراع الرئيسي قائمًا. يذكّر الحقوقيون بأن تدريب النموذج نفسه قد يُفسَّر على أنه تحليل لا إعادة إنتاج للمصنَّف، لكن تخزين المواد من أجل التدريب اللاحق يتطلب موافقة المؤلف، ما لم يُدخل القانون استثناءً مستقلًا. ولهذا السبب تحديدًا تكتسب المبادرة الحالية أهميتها، لا بوصفها تفصيلًا تقنيًا، بل بوصفها محاولة لإعادة كتابة مفترق الطرق الأساسي بين مصالح شركات الذكاء الاصطناعي ومصالح مالكي المحتوى. وعند هذا الحد عادةً تنشأ أغلى النزاعات القضائية.
وعلى مستوى السوق العالمية، وصل هذا الجدل بالفعل إلى دعاوى بارزة ضد Anthropic وOpenAI، وتزداد هجمات اتحادات المؤلفين في أوروبا والولايات المتحدة على مطوري النماذج التوليدية حدّة. أما في روسيا فتبحث السلطات في الغالب عن حل وسط لصالح نمو القطاع، إذ ترى أن القيود الصارمة أكثر من اللازم ستترك الفرق المحلية بلا بيانات وبلا فرص للمنافسة مع المنصات الأمريكية والصينية. وقد سبق للسلطات أن عرضت هذا المنطق عندما تحدثت عن تنظيم الذكاء الاصطناعي بصورة عامة.
«المهم ألا «نخنق» التقنية بالقواعد».
لكن هذه الصيغة تبدو مقلقة لأصحاب الحقوق: فإذا تدرّب النموذج على مصنَّفات دون موافقة المؤلف، ثم حصل المستخدم بعد ذلك على الحقوق في النتيجة، فإن خطر تآكل حدود التأليف لا يزداد إلا. وثمة سؤال منفصل: كيف يمكن إثبات المخالفة إذا كان المستخدم نفسه لا يعرف على أي بيانات تدرّب النموذج ومن أين جاءت مقاطع بعينها من الإجابة؟ ومن المرجّح أن تظهر هنا أشد الخلافات بعد نشر النسخة النهائية من الوثيقة. وهنا أيضًا سيتحدد مدى كون البند الجديد قابلًا للتطبيق عمليًا.
ماذا يعني ذلك
إذا وصل هذا البند إلى القانون النهائي، فسيحصل سوق الذكاء الاصطناعي الروسي على وصول أوسع إلى البيانات، ومن المرجّح أن يتسارع تدريب النماذج المحلية. لكن في الوقت نفسه سيزداد التوتر حول حقوق المؤلف: فكلما سهل تدريب الشبكات العصبية على محتوى الآخرين، ازداد حدّة السؤال عن الحد الذي ينتهي عنده التحليل ويبدأ عنده استخدام مصنَّف الغير. وبالنسبة للشركات الناشئة تمثل هذه فرصة للتسارع، أما بالنسبة للمؤلفين والناشرين فهي سبب للاستعداد لسلسلة جديدة من النزاعات حول حدود المسموح.
Build & Ship Production AI Apps with Vibe Coding
Join Zhemal Khamidun's hands-on Vibe Coding Intensive at hamidun.com/vibecoding — master Claude Code, Cursor, and autonomous agentic workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.