AvatarBox على HeyGen يحوّل الصور إلى فيديوهات ناطقة داخل Telegram في دقيقتين
ظهر في Telegram بوت AvatarBox المبني على HeyGen API، وهو ينتج فيديو talking-head من صورة واحدة ونص خلال 1–3 دقائق. يرفع المستخدم صورة شخصية، ويختار الصوت وصيغة الكادر، ثم يتلقى مقطعًا مع ترجمة نصية تلقائية. تصلح الأداة للبطاقات التعريفية المصوّرة والعروض التقديمية والمحتوى الذي لا يتطلب تصويرًا. لكن المقاطع الطويلة والأغاني والتعابير الوجهية المعقدة ما زالت نقطة ضعف.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News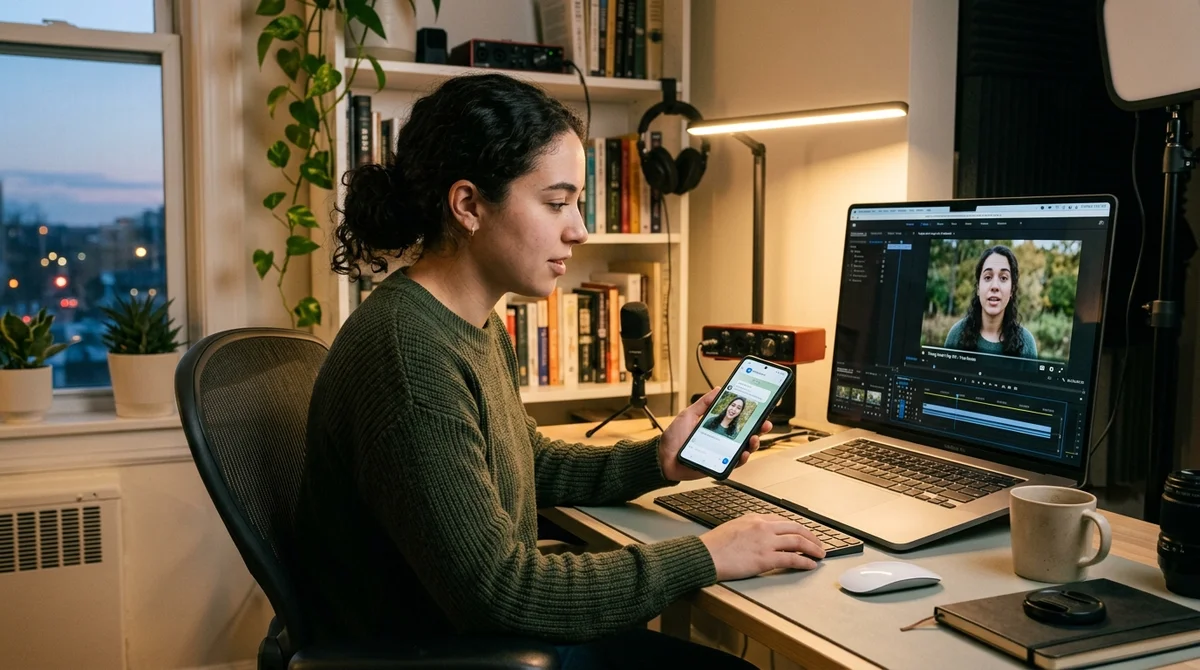
ظهر في Telegram بوت AvatarBox المبني على HeyGen API، وهو يحوّل صورة واحدة ونصًا قصيرًا إلى فيديو بأفاتار ناطق. يرفع المستخدم صورة شخصية، ويختار الصوت وصيغة الكادر، ثم يصله المقطع الجاهز مباشرة في المحادثة بعد نحو 1–3 دقائق.
كيف يعمل AvatarBox
تعمل الخدمة كواجهة بسيطة فوق HeyGen API: لا يحتاج المستخدم إلى الدخول إلى لوحة تحكم منفصلة، ولا إلى بناء المشهد في محرر فيديو، ولا إلى ضبط المونتاج يدويًا. وقد اختُزل كل شيء في السيناريو المألوف لبوتات Telegram. يرسل المستخدم أولًا صورة شخصية مقرّبة، ثم يُدخل النص الذي يجب أن ينطق به الأفاتار، ثم يختار الصوت. وفي النهاية يرسل البوت فيديو talking-head جاهزًا، تتزامن فيه حركة الوجه مع الكلام، وتبدو تعابيره طبيعية بما يكفي للصيغ القصيرة.
تتوفر في الخدمة عدة خيارات عملية تجعلها أداة عمل لإنتاج مقاطع سريعة، لا مجرد عرض تجريبي:
- أكثر من 2000 صوت بالروسية والإنجليزية ومئات اللغات الأخرى
- ثلاث صيغ للكادر: 9:16 و1:1 و16:9
- ضبط المشاعر وحيوية الكلام
- ترجمة نصية تلقائية داخل المقطع الجاهز
- الفيديو الأول مجاني ودون ربط بطاقة مصرفية
المرحلة الأهم هنا هي تحضير المواد المصدرية. تعطي أفضل النتائج الصور الأمامية ذات النظرة المباشرة إلى الكاميرا، والخلفية المحايدة، والإضاءة الجيدة. أما الصور الجماعية، والوجه الجانبي، واللقطات المعتمة، والنظارات الشمسية، والوجوه الضبابية فتعطي نتيجة ضعيفة. وبالنسبة إلى النص، ينصح المؤلف بالتزام نطاق يقارب 80–150 كلمة، وهو ما يكفي لكلام مدته 30–60 ثانية. بعد ذلك يبقى اختيار الصوت المناسب، والاستماع إلى المعاينة، والضغط على زر التوليد. يعالج البوت الطلب ويعيد الفيديو دون تسجيل في منصات خارجية.
سيناريوهات الاستخدام العملية
صُمّم AvatarBox في الأصل أداةً للمدونين، لكن السيناريوهات في الواقع أكثر من ذلك. تناسب هذه الصيغة البطاقات التعريفية المصوّرة، حين يحتاج المرء إلى تقديم نفسه بسرعة لمسؤول توظيف أو لعميل دون التصوير أمام الكاميرا. والأمر نفسه ينطبق على العروض التقديمية القصيرة وعروض الاستثمار (pitch) وبرامج الاستقبال الوظيفي (onboarding): فبدل مجموعة شرائح مع تعليق صوتي، يمكن إعداد مقطع يعرض فيه الأفاتار النقاط الرئيسية، ويشدّ الانتباه أكثر من النص العادي على الشاشة.
«كنت أظن أن الجمهور الرئيسي هم المدونون. تبيّن أن الأمر ليس كذلك».
وهناك فئة مستقلة من المهام هي المحتوى دون حضور شخصي في الكادر. يفيد هذا من لا يريد إظهار وجهه لكنه يريد إصدار مقاطع بانتظام لقنوات Telegram أو Shorts أو القنوات الداخلية للشركات. وثمة سيناريو آخر هو الفيديوهات التعليمية، حين يلزم إنتاج شروحات متشابهة بسرعة دون استوديو أو ميكروفون.
وهناك أيضًا استخدامات أخف: التهاني والميمات والمقاطع الشخصية المصنوعة من صور الأصدقاء. وغالبًا ما تصبح هذه الصيغ الأكثر انتشارًا، لأن التخصيص هنا أهم من جودة الإنتاج.
أين تكمن القيود
المشكلة الرئيسية في هذا النوع من الخدمات أنها تعمل جيدًا في نطاق ضيق من المهام فقط. فالمقاطع الطويلة تكشف أصلها الاصطناعي بسرعة: بعد دقيقة من الكلام يبدأ الصوت والتعابير الوجهية بالظهور رتيبين. أما المشاعر المعقدة، كالدهشة الشديدة أو البكاء أو الغضب، فما زالت غير مقنعة. كما أن اليدين والإيماءات لا تتحرك، لأن التحريك مبني حول الوجه لا حول الجسم كله. وإذا ظهرت في الصورة الأصلية الكفّان أو وضعية نشطة، فإن ذلك يضرّ بالنتيجة أكثر مما يحسّنها.
وهناك قيود تقنية تتعلق باستقرار الشخصية. فكل عملية توليد قد تختلف قليلًا عن سابقتها، لذلك يُفضَّل في سلسلة المقاطع استخدام الصورة نفسها وعدم توقّع اتساق مثالي. كما أن الغناء والعبارات الموسيقية لا يناسبان الخدمة: فمزامنة الشفاه (lip sync) مضبوطة على الكلام العادي لا على الغناء.
وإذا كنت تحتاج إلى مقدّم افتراضي خاص بك، فالطريق المنطقي أن تولّد أولًا صورة شخصية واقعية في أي مولّد صور، ثم تستخدم هذا الكادر أساسًا ثابتًا للمقاطع.
ماذا يعني ذلك
يواصل الحاجز أمام الدخول إلى فيديو talking-head الانخفاض. فقد كانت هذه الصيغة تتطلب سابقًا كاميرا وإضاءة وميكروفونًا ووقتًا للتسجيل، أما الآن فيكفي صورة ونص وبضع دقائق انتظار في Telegram. وهو بالنسبة إلى صنّاع المحتوى والتوظيف والتدريب الداخلي والعروض السريعة أداة عمل فعلية. لكنه لا يحلّ حتى الآن محل الفيديو الحي: فما إن يحتاج السيناريو إلى كلام طويل أو تعابير وجه معقدة أو حركة جسدية، حتى تصبح القيود واضحة أكثر من اللازم.
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول كيف يعمل AvatarBox؟
تعمل الخدمة كواجهة بسيطة فوق HeyGen API: لا يحتاج المستخدم إلى الدخول إلى لوحة تحكم منفصلة، ولا إلى بناء المشهد في محرر فيديو، ولا إلى ضبط المونتاج يدويًا. وقد اختُزل كل شيء في السيناريو المألوف لبوتات Telegram. يرسل المستخدم أولًا صورة شخصية مقرّبة، ثم يُدخل النص الذي يجب أن ينطق به الأفاتار، ثم يختار الصوت. وفي النهاية يرسل البوت فيديو talking-head جاهزًا، تتزامن فيه حركة الوجه مع الكلام، وتبدو تعابيره طبيعية بما يكفي للصيغ القصيرة.
ما أبرز التفاصيل حول سيناريوهات الاستخدام العملية؟
صُمّم AvatarBox في الأصل أداةً للمدونين، لكن السيناريوهات في الواقع أكثر من ذلك. تناسب هذه الصيغة البطاقات التعريفية المصوّرة، حين يحتاج المرء إلى تقديم نفسه بسرعة لمسؤول توظيف أو لعميل دون التصوير أمام الكاميرا. والأمر نفسه ينطبق على العروض التقديمية القصيرة وعروض الاستثمار (pitch) وبرامج الاستقبال الوظيفي (onboarding): فبدل مجموعة شرائح مع تعليق صوتي، يمكن إعداد مقطع يعرض فيه الأفاتار النقاط الرئيسية، ويشدّ الانتباه أكثر من النص العادي على الشاشة. «كنت أظن أن الجمهور الرئيسي هم المدونون.
ما أبرز التفاصيل حول أين تكمن القيود؟
المشكلة الرئيسية في هذا النوع من الخدمات أنها تعمل جيدًا في نطاق ضيق من المهام فقط. فالمقاطع الطويلة تكشف أصلها الاصطناعي بسرعة: بعد دقيقة من الكلام يبدأ الصوت والتعابير الوجهية بالظهور رتيبين. أما المشاعر المعقدة، كالدهشة الشديدة أو البكاء أو الغضب، فما زالت غير مقنعة. كما أن اليدين والإيماءات لا تتحرك، لأن التحريك مبني حول الوجه لا حول الجسم كله. وإذا ظهرت في الصورة الأصلية الكفّان أو وضعية نشطة، فإن ذلك يضرّ بالنتيجة أكثر مما يحسّنها. وهناك قيود تقنية تتعلق باستقرار الشخصية.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.