Habr AI يعرض كيفية إعداد مدخلات منظَّمة لوكيل ذكاء اصطناعي بدلًا من المواصفات الخام
نشر Habr AI تحليلًا مفيدًا لمدخلات وكيل الذكاء الاصطناعي الذي يتحقق من المواصفات الفنية (ТЗ). بدلًا من تمرير الوثيقة كاملة، تقترح الكاتبة تقسيم المتطلبات إلى أجزاء ذرّية، وبناء «جواز» بصيغة JSON لكل متطلب يتضمن سماته، ثم تمريرها عبر مصنِّف ووكيل ناقد. يمنح هذا النهج شفافية أكبر، ويكشف الأخطاء بصورة أفضل، ويسرّع معالجة المواصفات الضخمة.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News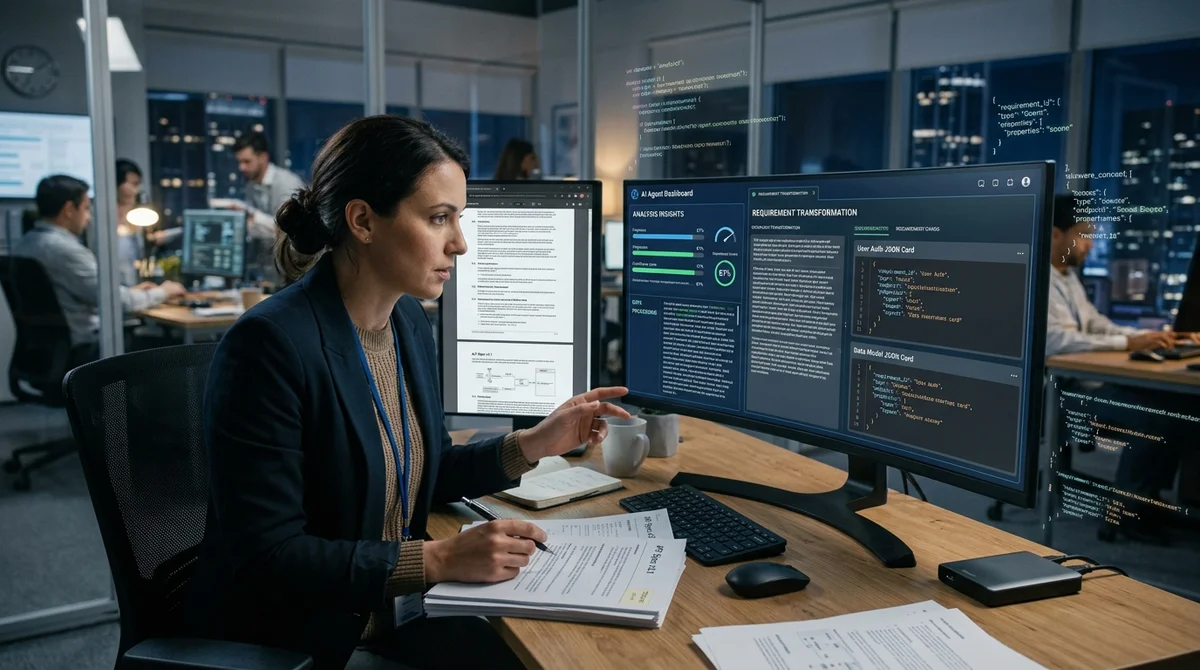
نشر Habr AI تحليلًا مفصّلًا لما ينبغي تقديمه بالضبط إلى وكيل الذكاء الاصطناعي كمدخلات، إذا كانت مهمته التحقق من المتطلبات الفنية لا مجرد إعادة سردها. الفكرة الرئيسية: بدلًا من الحصول على المواصفات الفنية (ТЗ) كاملة، يتلقى الوكيل مجموعة من المتطلبات الذرّية على شكل «جوازات» بصيغة JSON.
لماذا لا تكفي المواصفات الفنية وحدها
تبدأ كاتبة المقال بمشكلة يعرفها تقريبًا كل من حاول تمرير وثيقة كبيرة كاملة إلى شبكة عصبية. فحين يتلقى النموذج مواصفات فنية من عدة صفحات دون إعداد مسبق، يفقد تركيزه، ويخلط بين متطلبات من أقسام مختلفة، ويقدّم ملاحظات عامة أكثر من اللازم. والنتيجة أن النظام قد يلتقط بعض الأخطاء المتفرقة، لكنه يعجز عن توضيح أي بند بالتحديد سيّئ، ولماذا هو سيّئ، وما الذي يجب إصلاحه فيه.
لذلك تُقسَّم الوثيقة أولًا إلى متطلبات منفصلة: إجراء واحد أو قاعدة واحدة أو قيد واحد في كل جزء. ولكي لا يضيع السياق عند هذا التقسيم، تُضاف إلى كل عنصر حقول مثل `parent_section` و`parent_object`، وتُوسَم البنود المترابطة منطقيًا بـ`linked`. وهذا مهم حين يجب فحص عدة متطلبات معًا، كأن يكون على النظام إرسال الإشعار إلى البريد الإلكتروني وإلى Telegram معًا، لا إلى قناة واحدة من الاثنتين فحسب.
«جواز» المتطلب
الخطوة التالية هي تحويل الصياغة البشرية إلى مجموعة سمات يستطيع المصنِّف العمل بها. في هذا المخطط لا يؤدي نموذج اللغة الكبير (LLM) دور الحَكَم النهائي، ولا يحاول «فهم كل شيء». فدوره أضيق بكثير: يستخرج من النص إشارات منظَّمة ويضعها في JSON. يمنح هذا النهج قدرة على التحكم، إذ يمكن التحقق من السمات ومقارنتها وتصحيحها عند الحاجة بالمعالجة اللاحقة. وكما تصوغ الكاتبة:
«الوكيل لا يعمل مع النص، بل مع هذه البنى».
يصف المقال ست سمات أساسية يقوم عليها هذا الجواز. فبدلًا من تقييم مجرّد للجودة، يبحث النموذج عن إشارات محددة: الأرقام، والكلمات الغامضة، والاستثناءات، والحدود، والمشاركين الصريحين في السيناريو. وعمليًا يحوّل هذا الجواز عبارة مثل «يجب أن يتمكن المستخدم من ضبط التقرير بمرونة» إلى مجموعة أعلام واضحة، يتبيّن منها فورًا ما ينقص المتطلب. وهذه القابلية للتفسير هي ما يميّز المخطط عن مجرد طلب تقييم النص كاملًا من النموذج.
- `has_numbers` — هل يحتوي المتطلب على أرقام وحدود وتواريخ ومعاملات محددة أخرى
- `stopword_score` — مدى غموض الصياغة بسبب كلمات مثل «بمرونة» أو «بسهولة» أو «بسرعة»
- `has_negative_keywords` — هل وُصفت الاستثناءات والأخطاء
- `boundary_conditions_mentioned` — هل ذُكرت القيم الفارغة أو القيم القصوى أو الدنيا أو حدود أخرى
- `actor_count` — كم عدد المشاركين الذين يرد ذكرهم صراحة في المتطلب
تُستخرج السمات نفسها عبر وضع JSON (JSON mode) وأمثلة few-shot، حتى لا يخرج النموذج عن الصيغة المطلوبة. وإذا فات النموذج شيء بديهي، كالأرقام الواردة في النص، يُستدرك ذلك بالمعالجة اللاحقة عبر التعابير النمطية. بعد ذلك تأتي شجرة القرار: تتلقى السمات الرقمية وتمنح المتطلب وسمًا مثل `ok` أو `unverifiable` أو `no_negative` أو `no_boundary` أو `ambiguity`. وللتدريب، وسمت الكاتبة يدويًا 90 وثيقة مواصفات فنية، وقسّمتها إلى 270 متطلبًا، وحصلت على دقة (accuracy) تبلغ نحو 82% على عيّنة الاختبار.
الناقد والتوسّع
لا ينتهي خط المعالجة عند هذا الحد. فحتى المصنِّف الجيد لا يرى سوى متطلب واحد في كل مرة، ولذلك يفوته بسهولة ما بين الأقسام من تناقضات. لهذه الحالات يُستخدم وكيل ناقد منفصل، يتلقى النص الكامل للمواصفات، وقائمة جوازات JSON، والوسوم المتوقَّعة. ومهمته ليست إعادة تقييم كل عبارة من جديد، بل النظر إلى الوثيقة من أعلى والبحث عن التعارضات، والثغرات في صلاحيات الوصول، وأخطاء ربط التكاملات (mapping). ويمكن لهذا الناقد مثلًا أن يلاحظ أن حقل «المستودع» إلزامي في موضع، بينما يُسمح في موضع آخر بقيمة فارغة.
ولكي يعمل المخطط على أكثر من أمثلة قصيرة، تُعالَج المتطلبات بالتوازي عبر `ThreadPoolExecutor`، وتُشغَّل النماذج المحلية في Ollama. وتذكر الكاتبة أن النظام يتحمّل على حاسوب ألعاب عادي من 4 إلى 6 طلبات متوازية دون تراجع ملحوظ في الأداء، وأن هذا يمنح تسريعًا بنحو 3–4 أضعاف على دفعة من مئة متطلب. وتبقى المتطلبات المترابطة في مسار معالجة واحد، حتى لا يختلّ الترتيب ولا يضيع السياق العام للفحص.
ماذا يعني هذا
يُظهر تحليل Habr AI بوضوح الاتجاه الذي يسلكه التطوير العملي لوكلاء الذكاء الاصطناعي: من محاولات «إطعام النموذج كل شيء دفعة واحدة» إلى خطوط معالجة ضيقة ومنضبطة، بسمات صريحة ونماذج محلية ومستوى مستقل للتحكيم. وإذا أرادت أي فرقة بناء وكيل تطبيقي للتحليل أو لضمان الجودة (QA) أو للعمل مع التوثيق، فعليها أن تفكّر لا في اختيار النموذج فحسب، بل أيضًا في كيفية بناء بيانات الإدخال، وطريقة وسمها، والتحقق النهائي من النتيجة.
Delegate Deep Research, Coding & Workflows to an AI Agent
Deploy autonomous multi-step execution with NomadNet Agent (agent.nomadnet.ai) — automated web research, data synthesis, code generation, and complex task orchestration.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.