Nvidia تطلق أول مجموعة بيانات مفتوحة ونماذج ذكاء اصطناعي أساسية للروبوتات الطبية
نشرت Nvidia وشركاؤها Open-H-Embodiment، وهي أول مجموعة بيانات مفتوحة كبيرة في مجال الروبوتات الطبية. تضم المجموعة 778 ساعة من البيانات في الجراحة والتصوير بالموجات فوق الصوتية وتنظير القولون، ومعها صدر لأول مرة نموذجان: GR00T-H للتحكم بالروبوتات، وCosmos-H-Surgical-Simulator للمحاكاة السريعة للعمليات الجراحية. تمثل هذه الخطوة محاولة لبناء حزمة أساسية من تقنيات Physical AI للقطاع الطبي.
معالج بواسطة الذكاء الاصطناعي من Hugging Face Blog؛ بتحرير Hamidun News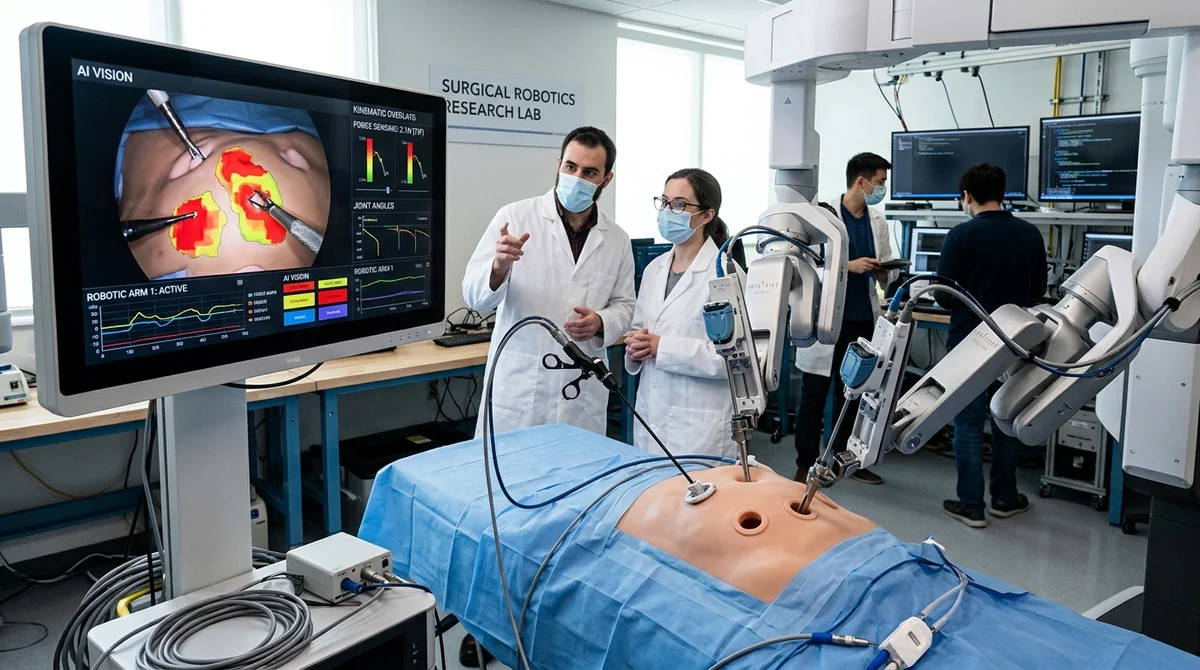
قدّمت Nvidia، بالتعاون مع المجتمع البحثي، مجموعة Open-H-Embodiment، وهي أول مجموعة بيانات مفتوحة كبيرة للروبوتات الطبية، إلى جانب نموذجين أساسيين للسيناريوهات الجراحية. نُشرت الحزمة على Hugging Face، ومن المفترض أن تنقل الذكاء الاصطناعي الطبي من تحليل الصور إلى أنظمة قادرة على التصرف في العالم المادي.
ما الذي جرى فتحه
فكرة الإصدار الرئيسية بسيطة: لم تعد النماذج التي تكتفي بالتعرف على الصور الطبية أو تقسيم الأنسجة أو تصنيف الحالات المرضية كافية للطب. ففي غرفة العمليات، أو أثناء الفحص بالموجات فوق الصوتية أو تنظير القولون، على الآلة أن تتعامل مع الأداة، وتفهم تماسّها مع الأنسجة، وتأخذ في الحسبان حركيات الروبوت، وتغلق حلقة التحكم عبر التغذية الراجعة. ولهذا الغرض تحديدًا جُمعت Open-H-Embodiment، لتكون أساسًا مشتركًا لتدريب وتقييم Physical AI في الروبوتات الطبية.
- 778 ساعة من بيانات التدريب بترخيص CC-BY-4.0
- 35 جهة مشاركة من جامعات ومستشفيات وشركات
- سيناريوهات من الجراحة والتصوير بالموجات فوق الصوتية وتنظير القولون الذاتي
- بيانات من المحاكاة والتمارين التدريبية والإجراءات الحقيقية
- دعم المنصات الروبوتية التجارية والبحثية
ولا يقتصر ما يهم السوق على الحجم، بل يشمل الصيغة أيضًا. فمجموعة البيانات تجمع الرؤية والقوى والحركيات وأنواعًا مختلفة من الأجسام الروبوتية في مجموعة مفتوحة واحدة، ليتمكن الفرق من مقارنة المقاربات على قاعدة مشتركة بدلًا من مجموعات محلية مغلقة. ويشارك في المشروع كل من Nvidia وJohns Hopkins وTechnical University of Munich وStanford وعشرات الفرق الأخرى، لذلك لا يتعلق الأمر بنشر لمرة واحدة، بل بمحاولة لوضع معيار للقطاع.
كيف تعمل النماذج
إلى جانب مجموعة البيانات، نشرت Nvidia نموذج GR00T-H، وهو نموذج Vision-Language-Action للروبوتات الجراحية، دُرّب على نحو 600 ساعة من بيانات Open-H-Embodiment. وهو في جوهره نموذج سياسات (policy) يتلقى سياقًا بصريًا ونصيًا ويحوّله إلى أفعال للروبوت. ويؤكد المؤلفون بوجه خاص أنهم أدخلوا فضاء أفعال موحّدًا مُطبَّعًا لمختلف الروبوتات، وإسقاطات خاصة تلائم حركيات كل روبوت، وتدريبًا على الحركات النسبية للأداة. وقد أظهر النموذج الأولي تنفيذًا كاملًا للخياطة الجراحية في اختبار SutureBot، أي أن الأمر لا يتعلق بإيماءة قصيرة، بل بتسلسل طويل من الأفعال الدقيقة.
أما الجزء الثاني من الحزمة فهو Cosmos-H-Surgical-Simulator، وهو world foundation model لمحاكاة الجراحة المشروطة بالأفعال (action-conditioned). جرى تدريبه إضافيًا على Open-H-Embodiment ليولّد فيديو معقولًا للعملية مباشرة من الأفعال الحركية للروبوت، بما يشمل تأثيرات معقدة مثل تشوّه الأنسجة الرخوة والانعكاسات الضوئية والدم والدخان. والمكسب العملي واضح: 600 تجربة في هذا المحاكي تستغرق نحو 40 دقيقة، مقابل يومين تقريبًا في الاختبارات الفعلية على المنصات. واستُخدمت في التدريب الإضافي 64 وحدة GPU من طراز A100 ونحو 10 آلاف ساعة GPU، أي أن هذه بنية تحتية جدية، لا مجرد عرض تجريبي مخبري.
ما التالي
أهم ما في هذه القصة هو محاولة نقل الروبوتات الطبية من نمط «النموذج يرى» إلى نمط «النموذج يتصرف ويعمّم». فمجموعة البيانات المفتوحة مع نموذجين أساسيين تمنح الباحثين حزمة مشتركة لتجارب sim-to-real، وتوليد البيانات الاصطناعية، ونقل المهارات بين روبوتات مختلفة. ويكتسب ذلك أهمية خاصة في الجراحة، حيث جمع مجموعات بيانات كبيرة وعالية الجودة مكلف، وحيث يكلّف الخطأ في التحكم أكثر بكثير مما يكلّفه في الرؤية الحاسوبية التقليدية.
«الروبوتات الجراحية بحاجة إلى لحظتها الخاصة على غرار
ChatGPT».
بهذه العبارة يصف المؤلفون هدف الإصدار الثاني من Open-H-Embodiment. والمرحلة التالية ليست مجرد تحكم أفضل بالأداة، بل استقلالية تتضمن عناصر من الاستدلال: إذ ينبغي أن تكون الأنظمة قادرة على شرح الخطوات، وتخطيط الإجراءات الطويلة، والتكيّف مع الأعطال، والتعلم من مسارات موسومة مع بيان النوايا والنتائج وأنواع الأخطاء. وإذا نجح المجتمع فعلًا في جمع بيانات جاهزة للاستدلال (reasoning-ready) بهذا الشكل، فقد يحصل الطب على منصة لمساعدين روبوتيين أكثر شمولًا، لا على خوارزمية ضيقة أخرى.
ماذا يعني ذلك
بالنسبة إلى سوق الذكاء الاصطناعي، هذا تحول مهم: ففي الطب بدأ يُجمع علنًا ليس نماذج التعرف فحسب، بل الطبقة الأساسية لـ Physical AI، حيث تصدر البيانات ونماذج السياسات والمحاكيات في حزمة واحدة. وإذا نجحت هذه المقاربة، فسيحصل أصحاب الشركات الناشئة والمختبرات ومصنّعو الروبوتات على مجموعة انطلاق مشتركة لتسريع الأبحاث، وخفض تكلفة الاختبارات، والانتقال بوتيرة أسرع من النماذج الأولية إلى أنظمة مفيدة سريريًا.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.