Nvidia تكشف عن Vera Rubin: سبع رقائق ومنصة متكاملة لمصانع الذكاء الاصطناعي
أعلنت Nvidia عن Vera Rubin لا بوصفها وحدة GPU جديدة أخرى، بل كحزمة متكاملة لمصانع الذكاء الاصطناعي، تضم: Rubin GPU وVera CPU وNVLink 6 وConnectX-9 وBlueField-4 وSpectrum-6 وGroq 3 LPX. وتعد الشركة بما يصل إلى 10 أضعاف في معدل الإنتاجية لكل واط في الاستدلال، وبتكلفة للرمز أقل بعشر مرات، وبتدريب النماذج الكبيرة باستخدام عدد من وحدات GPU أقل بأربع مرات مقارنة بمنصة Blackwell.
معالج بواسطة الذكاء الاصطناعي من 3DNews AI؛ بتحرير Hamidun News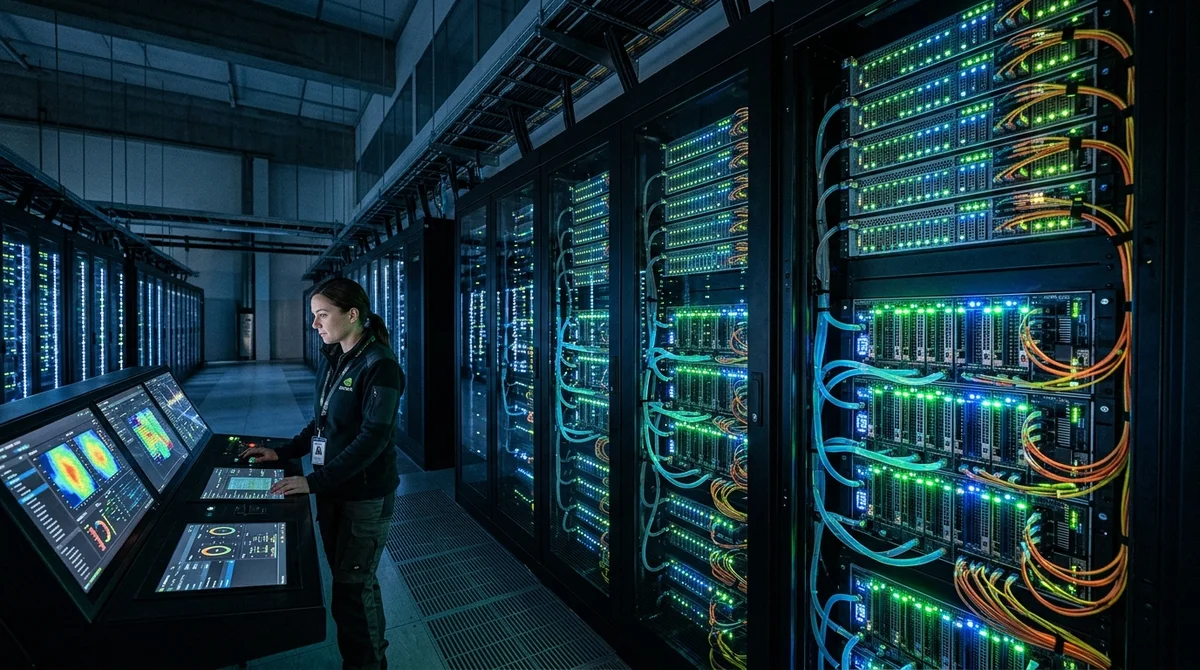
لم تعرض Nvidia مسرّعاً واحداً باسم Vera Rubin، بل منصة كاملة لمصانع الذكاء الاصطناعي، تبدأ من وحدات GPU وCPU وتمر بواجهات الشبكة ووحدات DPU وأنظمة التخزين، وتنتهي بمحولات Ethernet. وتقدم الشركة هذه المنصة بوصفها المرحلة التالية بعد Blackwell: بنية تحتية تُصمَّم فيها الرفوف والعناقيد كحاسوب عملاق واحد موجّه للذكاء الاصطناعي الوكيلي.
المنصة بكاملها
بدلاً من الإعلان عن «أسرع GPU» جديد، عرضت Nvidia حزمة كاملة من سبع رقائق وعدة أنواع من الرفوف، تغطي مراحل مختلفة من العمل مع الذكاء الاصطناعي: التدريب المسبق، والتدريب اللاحق، وtest-time scaling، واستدلال الأنظمة الوكيلية.
يتوسط المنصة معالج Rubin GPU ومعالج Vera CPU، وتحيط بهما NVLink 6 وConnectX-9 SuperNIC وBlueField-4 وSpectrum-6 ومسرّعات الاستدلال Groq 3 LPX. وبحسب تصور الشركة، يفترض أن يعمل كل ذلك لا كمجموعة خوادم منفصلة، بل كمنظومة حوسبة واحدة مترابطة.
وتشدد Nvidia بشكل خاص على الانتقال من الخوادم المفردة إلى أنظمة POD وأنظمة على مستوى الرف (rack-scale). والمنطق هنا بسيط: فالنماذج الحديثة ووكلاء الذكاء الاصطناعي لا تصطدم بحدود المسرّعات وحدها، بل أيضاً بالشبكة والذاكرة وتخزين KV-cache والتبريد واستهلاك الطاقة. لذلك لا تُباع Vera Rubin كرقاقة واحدة، بل كبنية لمصنع ذكاء اصطناعي كامل، يمكن تجميعه من وحدات جاهزة بحسب نوع الحمل والميزانية.
«Vera
Rubin قفزة جيلية: سبع رقائق ثورية، وخمسة رفوف، وحاسوب عملاق ضخم واحد».
ما الذي تضمه الحزمة
تجمع التهيئة الأساسية Vera Rubin NVL72 بين 72 وحدة Rubin GPU و36 معالج Vera CPU في رف واحد. وترتبط المكونات عبر NVLink 6، بينما تتولى ConnectX-9 وBlueField-4 الاتصال الشبكي وتفريغ مهام البنية التحتية عن المعالجات. وتؤكد Nvidia أن هذا النظام يدرّب نماذج mixture-of-experts الكبيرة بعدد وحدات GPU أقل بأربع مرات مما تتطلبه منصة Blackwell، ويوفر في الاستدلال ما يصل إلى 10 أضعاف الإنتاجية لكل واط، مع تكلفة للرمز أقل بعشر مرات.
وإلى جانب هذا الرف، جمعت الشركة عدة وحدات متخصصة أخرى:
- Vera CPU Rack — ما يصل إلى 256 معالج Vera لمهام reinforcement learning والأحمال الوكيلية
- Groq 3 LPX Rack — 256 رقاقة LPU للاستدلال منخفض الكمون والسياقات الطويلة
- BlueField-4 STX — طبقة لتخزين ومعالجة KV-cache للنماذج والوكلاء
- Spectrum-6 SPX — رف Ethernet للتبادل السريع للبيانات بين العقد
- Quantum-X800 / Spectrum-X — توسيع العناقيد بين الرفوف
وتركز Nvidia بصورة خاصة على رف Vera CPU: فهو مصمم للسيناريوهات التي لا يكتفي فيها الوكلاء بتوليد إجابة، بل يحتاجون إلى اختبار خيارات التصرف مرات عديدة في بيئات خارجية. وبحسب بيانات Nvidia، يحقق Vera نتائج أسرع بنسبة 50% من المعالجات التقليدية، وهو أكثر كفاءة في استهلاك الطاقة بمرتين.
ولاستدلال النماذج ذات السياق الطويل، أضافت الشركة Groq 3 LPX: 256 وحدة LPU في الرف، وذاكرة SRAM بسعة 128 غيغابايت على الرقاقة، وعرض نطاق داخلي يصل إلى 640 تيرابايت/ث.
الاقتصاد والنطاق
أهم ما في الإعلان ليس قائمة المكونات، بل اقتصاديات التشغيل. فـNvidia تعد بما يصل إلى 35 ضعفاً في إنتاجية الاستدلال لكل ميغاواط عند دمج Vera Rubin مع Groq 3 LPX، ويفترض أن يسرّع BlueField-4 STX عمليات KV-cache حتى خمس مرات مقارنة ببنية التخزين التقليدية. أما بالنسبة لشبكة Ethernet من نوع Spectrum-6، فتعلن الشركة عن تحسن يصل إلى خمسة أضعاف في كفاءة الطاقة البصرية وعشرة أضعاف في الموثوقية عند استخدام co-packaged optics.
وإلى جانب العتاد، قدمت Nvidia منصة DSX لمراكز بيانات Vera Rubin. ووفق الشركة، تتيح نسخة DSX Max-Q استيعاب ما يصل إلى 30% من البنية التحتية للذكاء الاصطناعي في مركز البيانات نفسه ضمن حد الطاقة ذاته، بينما تتيح DSX Flex استخدام منظومة الطاقة في مركز البيانات كأصل أكثر مرونة.
ومن المقرر أن تبدأ شحنات المنتجات المبنية على Vera Rubin عبر الشركاء في النصف الثاني من 2026. ومن بين الشركاء الأوائل المعلنين: AWS وGoogle Cloud وMicrosoft Azure وOracle Cloud وCoreWeave وLambda وTogether AI، إضافة إلى Dell وHPE وLenovo وSupermicro.
ماذا يعني ذلك
تبتعد Nvidia أكثر فأكثر عن بيع المسرّعات المنفردة، وتقترب من دور مزوّد البنية المتكاملة لمصانع الذكاء الاصطناعي. وبالنسبة للسوق، هذه إشارة إلى أن المنافسة لن تدور حول قدرة GPU وحدها، بل أيضاً حول تكلفة الرمز وكفاءة الشبكة والتعامل مع الذاكرة، وحول مدى سرعة نشر عنقود كامل للذكاء الاصطناعي الوكيلي.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.