AtScale: وكلاء الذكاء الاصطناعي في تحليلات الشركات يحتاجون إلى guardrails لا إلى نماذج أكبر
تحذّر AtScale من أن زيادة حجم النموذج لا تعالج المشكلة الرئيسية في التحليلات المؤسسية، وهي الفوضى في البيانات وفي تعريفات الأعمال. فحين يعمل وكلاء الذكاء الاصطناعي مع تفسيرات متباينة لمؤشرات مثل revenue وmargin وchurn، ومن دون lineage وsource of record، فإنهم يقدمون إجابات واثقة لكنها خاطئة بسرعة أكبر. والحل في طبقة دلالية، وقواعد حساب مشتركة، وضبط للوصول، وguardrails صارمة.
معالج بواسطة الذكاء الاصطناعي من TNW؛ بتحرير Hamidun News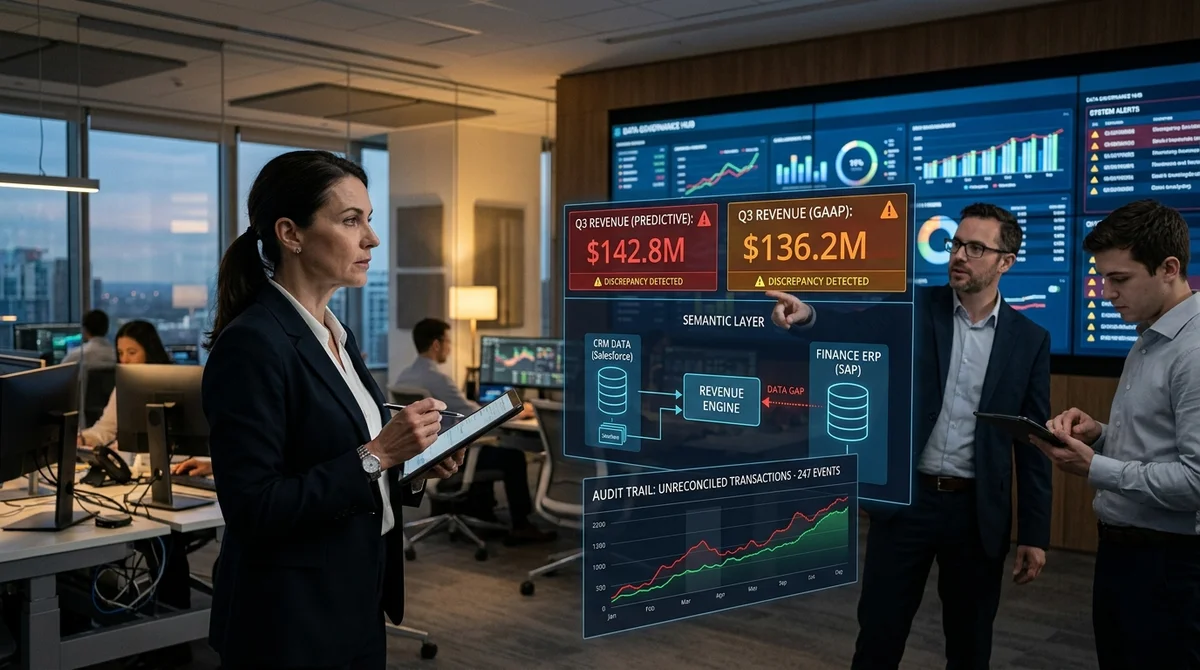
تؤكد AtScale أن الخطر الرئيسي على وكلاء الذكاء الاصطناعي المؤسسيين في التحليلات لا يرتبط بحجم النموذج، بل بجودة السياق الذي يعمل فيه. فإذا تعامل الوكيل مع بيانات متفرقة من دون قواعد عمل موحدة، فقد يقدم بسرعة إجابة تبدو مقنعة لكنها غير صحيحة.
لماذا لا يُنقذ الحجمُ الموقف
تأمل الشركات الكبرى في كثير من الأحيان أن يصحح النموذج التالي، الأكبر حجمًا، أخطاء سابقه من تلقاء نفسه: أن يستدل بشكل أفضل، ويفسّر الطلب بدقة أكبر، ويجمع الأرقام بعناية أكثر. لكن النموذج لا يملك وسيلة سحرية ليعرف أي تعريف لـ gross margin أو revenue معتمد داخل شركة بعينها. فهو لا يزيل التناقضات القديمة بين لوحات المعلومات، ولا يستعيد تاريخ نشأة المؤشرات، ولا ينشئ audit trail لمجرد أن عدد معاملاته ازداد.
وتستشهد AtScale أيضًا بدراسة أجرتها TDWI، قال فيها ما يقارب نصف المشاركين إن مبادراتهم في حوكمة الذكاء الاصطناعي غير ناضجة أو غير ناضجة إطلاقًا. والمنطق هنا بسيط: إذا كانت البيانات المصدرية والتعريفات فوضوية، فإن زيادة القدرة الحاسوبية لا تقلّص الخطأ، بل تجعله قابلًا للتوسع. يبدأ الوكيل بالإجابة بسرعة أكبر وبثقة أكبر وعلى عدد أكبر من المهام، بينما تبقى المشكلات البنيوية على حالها. والنتيجة أن الشركة لا تحصل على تحليلات موثوقة، بل على صورة أكثر إقناعًا للفوضى القديمة نفسها.
أين تنهار التحليلات
يبلغ الخطر ذروته حيث تعمل عدة أنظمة وفرق على المؤشرات نفسها لكنها تفهمها بصورة مختلفة. فقد يأخذ أحد الوكلاء بياناته من مستودع البيانات المالي، وآخر من نظام CRM أو أداة BI، ويبدو أن كليهما يجيب عن السؤال نفسه. وإذا لم يكن بينهما سياق مشترك، فإن التباين لا يبقى خطأً نادرًا بل يصبح نمط العمل المعتاد.
ولهذا ترد في المقال صيغة قصيرة تصف المشكلة جيدًا:
«بثقة. بوضوح. وبشكل خاطئ.»
وبحسب AtScale، فإن الأعطال المعتادة هنا متوقعة تمامًا. فقد يعتمد الوكيل على مصدر يُفسَّر فيه المؤشر نفسه بطريقة تختلف عمّا يعتمده الفريق المجاور. وقد يقدم نتيجة من دون شرح واضح لكيفية وصوله إليها. وقد يبني استنتاجه على بيانات لم يكن يجوز له الوصول إليها أصلًا. وعندما يتعذر ربط الإجابة بـ source of record خاضع للرقابة، تفقد الشركة القدرة على التحقق السريع من الخطأ وتحديد المسؤولية والتراجع عن قرار خاطئ من دون مطابقة يدوية.
ما الـ guardrails المطلوبة
تقترح AtScale النظر إلى guardrails لا بوصفها كابحًا للذكاء الاصطناعي، بل بوصفها البنية التحتية التي تجعل الاستقلالية ممكنة أصلًا. ففي التحليلات، بحسب رؤيتها، ينبغي ألا يعمل النموذج مباشرة مع الجداول «الخام» ومع القواعد المحلية المتباينة للفرق، بل عبر طبقة دلالية مشتركة. وهذه الطبقة لا تنسخ البيانات ولا تغيّرها فعليًا، بل تحدد معنى موحدًا لمصطلحات الأعمال، وقواعد الحساب، وحدود الوصول لجميع التطبيقات والوكلاء.
- تعريفات موحدة لمؤشرات revenue وchurn وmargin وغيرها من المؤشرات الرئيسية
- قيود على منطق الأعمال في الحسابات بصرف النظر عن الأداة المستخدمة
- وضوح الرؤية في lineage: من أين جاءت الإجابة وما البيانات التي دخلت فيها
- ضبط الوصول: أي مجموعات بيانات يحق للوكيل أصلًا أن يستعلم عنها
- توحيد المؤشرات بين الأقسام والمنصات
وجوهر هذا النهج أن أداء النموذج ومسؤولية النظام مهمتان مختلفتان. فالنموذج مسؤول عن الاستدلال، أما طبقة الحوكمة فتحدد ما الذي يستدل عليه بالضبط وكيف يمكن التحقق من النتيجة. وإذا بُنيت هذه الطبقة بشكل سليم، بدأ عدة وكلاء في أنظمة مختلفة يتحدثون لغة أعمال واحدة. وإن لم تُبنَ، فإن كل عملية تكامل جديدة وكل إجراء وكل أداة ذكاء اصطناعي إضافية لا تفعل سوى رفع كلفة الأخطاء والتحققات اليدوية وإعادة التحليل.
ما معنى ذلك
يتراجع اعتماد الذكاء الاصطناعي المؤسسي على سباق المعاملات، ويزداد اعتماده على معمارية البيانات. وهذا خبر سيئ للشركات التي كانت تعوّل على «شراء نموذج أذكى» لحل المشكلة، وخبر جيد لتلك المستعدة للاستثمار في الطبقة الدلالية والحوكمة وقابلية التتبع. فهذه العناصر، لا حجم النموذج بحد ذاته، هي التي ستحدد ما إذا كان يمكن الوثوق بتحليلات الذكاء الاصطناعي في عمليات الأعمال الفعلية.
- 28 أبريل 2026Google Gemma 4 وNVIDIA وOpenClaw: وكلاء ذكاء اصطناعي محليون دون دفع مقابل كل رمز
- 22 يوليو 2026Cloud.ru تفتح المصدر البرمجي لأداة Guardrails Filter لحماية البيانات في الطلبات الموجّهة إلى نماذج LLM
- 30 يونيو 2026Amazon Bedrock Guardrails تحصل على واجهة API جديدة لحماية مرنة لتطبيقات الذكاء الاصطناعي القائمة على الوكلاء
- 17 يوليو 2026AWS Bedrock AgentCore تضيف ضمانات مدمجة لأنظمة الدفع
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول لماذا لا يُنقذ الحجمُ الموقف؟
تأمل الشركات الكبرى في كثير من الأحيان أن يصحح النموذج التالي، الأكبر حجمًا، أخطاء سابقه من تلقاء نفسه: أن يستدل بشكل أفضل، ويفسّر الطلب بدقة أكبر، ويجمع الأرقام بعناية أكثر. لكن النموذج لا يملك وسيلة سحرية ليعرف أي تعريف لـ gross margin أو revenue معتمد داخل شركة بعينها. فهو لا يزيل التناقضات القديمة بين لوحات المعلومات، ولا يستعيد تاريخ نشأة المؤشرات، ولا ينشئ audit trail لمجرد أن عدد معاملاته ازداد.
ما أبرز التفاصيل حول أين تنهار التحليلات؟
يبلغ الخطر ذروته حيث تعمل عدة أنظمة وفرق على المؤشرات نفسها لكنها تفهمها بصورة مختلفة. فقد يأخذ أحد الوكلاء بياناته من مستودع البيانات المالي، وآخر من نظام CRM أو أداة BI، ويبدو أن كليهما يجيب عن السؤال نفسه. وإذا لم يكن بينهما سياق مشترك، فإن التباين لا يبقى خطأً نادرًا بل يصبح نمط العمل المعتاد. ولهذا ترد في المقال صيغة قصيرة تصف المشكلة جيدًا: «بثقة. بوضوح. وبشكل خاطئ.» وبحسب AtScale، فإن الأعطال المعتادة هنا متوقعة تمامًا.
ما أبرز التفاصيل حول ما الـ guardrails المطلوبة؟
تقترح AtScale النظر إلى guardrails لا بوصفها كابحًا للذكاء الاصطناعي، بل بوصفها البنية التحتية التي تجعل الاستقلالية ممكنة أصلًا. ففي التحليلات، بحسب رؤيتها، ينبغي ألا يعمل النموذج مباشرة مع الجداول «الخام» ومع القواعد المحلية المتباينة للفرق، بل عبر طبقة دلالية مشتركة. وهذه الطبقة لا تنسخ البيانات ولا تغيّرها فعليًا، بل تحدد معنى موحدًا لمصطلحات الأعمال، وقواعد الحساب، وحدود الوصول لجميع التطبيقات والوكلاء.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.