Habr AI يعرض كيف تقضي بنية «الأفعال المنعكسة» لوكلاء LLM على التأخير وتصل إلى 60 إطارًا في الثانية
عرض Habr AI حلًّا للمشكلة الرئيسية التي تواجه وكلاء الذكاء الاصطناعي في الألعاب والمساعدات الذكية والروبوتات، وهي التأخير الذي يتراوح بين 1 و3 ثوانٍ. قسّم الفريق النظام إلى مسار سريع للأفعال المنعكسة ومسار بطيء يعتمد على LLM للاستدلال (reasoning). والنتيجة أن الوكيل يستطيع الاستجابة خلال أجزاء من الثانية، وتغيير سلوكه أثناء التشغيل، والتعلّم خلال الجلسة نفسها، دون أن يفسد إحساس التفاعل الحي حتى في المشاهد الديناميكية. يتولى المسار السريع رصد الأحداث وتشغيل ردود الفعل الفورية دون انتظار استدلال النموذج الكامل. أما المسار البطيء فيبقى مع LLM لمهام أكثر كلفة، مثل تفسير السياق المعقد والتخطيط واختيار العبارات وإعادة تشكيل السلوك. يقدّم هذا النهج، بحسب المؤلفين، ميزتين يصعب تحقيقهما في خط المعالجة الأحادي: يمكن تغيير الشخصية أثناء العمل، ويمكن التقاط أنماط سلوك جديدة في أثناء التشغيل نفسه.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News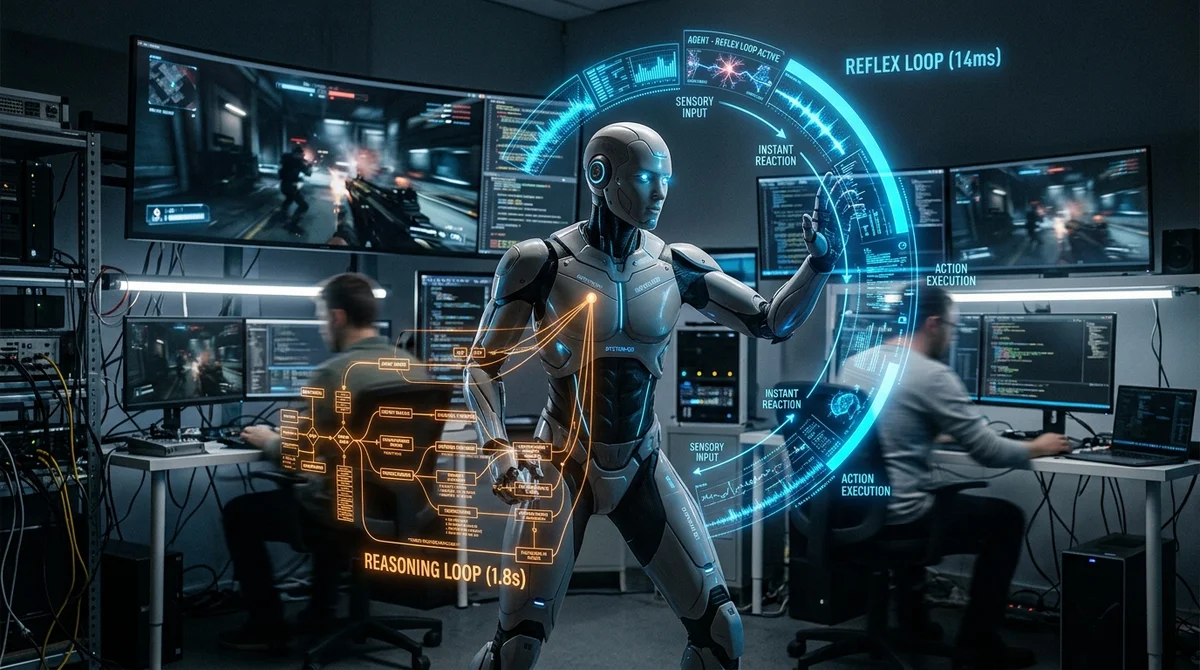
نشر Habr AI تحليلًا لبنية تضيف إلى وكلاء LLM «نخاعًا شوكيًا»، أي طبقة سريعة للأفعال المنعكسة فوق الاستدلال البطيء. الفكرة هي التخلص من التوقف المعتاد الذي يستغرق 1–3 ثوانٍ، وجعل شخصيات الألعاب غير اللاعبة (NPC) والمساعدات الصوتية والروبوتات تستجيب بشكل شبه فوري.
أين تتعثر السرعة
تعرف هذه المشكلة كل من حاول دمج نموذج لغوي كبير في بيئة تفاعلية. فقبل أن يتحول الصوت المُستقبَل إلى حركة أو أداء، يمر الوكيل بمراحل كثيرة: يستقبل الصوت، ويجمع السياق، ويرسل الطلب، وينتظر رد النموذج، ثم يحوّله إلى رسوم متحركة أو إجراء. وهذا يستغرق وقتًا طويلًا. التأخير مقبول في الدردشة، لكنه في اللعبة أو الروبوت أو الواجهة الحية فشل في تجربة المستخدم (UX)، إذ لا يرى المستخدم ذكاءً بل تجمّدًا. ولهذا يبدو النموذج القوي غالبًا «ذكيًا لكنه بطيء».
يشبّه المؤلفون هذا الدمج بمحاولة تركيب محرك مكوك فضائي على عربة: القدرة الحسابية موجودة، لكن نقلها إلى سلوك فعلي غير ممكن. وفي نموذجهم الأولي، انصرف انتباه الجمهور إلى الغلاف المرئي لا إلى المحرك نفسه. فبدلًا من مناقشة الاستدلال (inference)، سمع الفريق انتقادات لمخرجات التصحيح الخام وجودة الإطارات. أي أن النقاش دار حول الصورة، مع أن الخبر الحقيقي هو أن النظام كان يحاول بالفعل مواكبة إيقاع الوقت الفعلي.
«من المبكر عرض «60 إطارًا في الثانية بصدق». عندكم هنا مجرد مجموعة
فوضوية من الإطارات، وضبابية، وأصابع مشوّهة».
النظام 1 والنظام 2
كان الحل هو بنية المعالجة المزدوجة (Dual-Process Architecture)، أي تقسيم الوكيل إلى مسارين: سريع وبطيء. تعمل الطبقة الأولى كمنظومة أفعال منعكسة: ترصد الأحداث وتطلق ردود فعل لحظية دون انتظار الاستدلال الكامل للنموذج. وتبقى الطبقة الثانية مع LLM، وتتولى المهام الأكثر كلفة: تفسير السياق المعقد، والتخطيط، واختيار العبارات، وإعادة بناء السلوك. وبهذا يستطيع الوكيل أن يتفاعل أولًا ثم «يفكر» بعد ذلك، كما يفعل الإنسان في العالم الواقعي.
في هذا النهج، من الضروري ألا يكون LLM مركز التنفيذ الوحيد. فالاستدلال البطيء ممتاز حيث يلزم العمق، لكنه غير مناسب للحركات والإيماءات الدقيقة والدوران السريع للكاميرا والاستجابة للتصادمات والردود الصوتية القصيرة. وتحل البنية ذات السرعتين هذا التعارض: فالواجهة وجسد الوكيل يعملان بالمللي ثانية، أما المعنى والاستراتيجية فيعملان في دورة أطول. هذا الفصل تحديدًا يمنع هبوط معدل الإطارات ويجنّب المستخدم انتظار كل إيماءة أو عبارة تالية.
وبحسب وصف المؤلفين، يمنح هذا المخطط ميزتين يصعب الحصول عليهما في خط المعالجة الأحادي: يمكن تغيير الشخصية أثناء العمل، ويمكن التقاط أنماط سلوك جديدة في أثناء التشغيل نفسه. وهذا مهم خصوصًا لشخصيات NPC والمساعدات والروبوتات، حيث لا يكفي أن يجيب الوكيل، بل عليه أن يتكيّف باستمرار مع البيئة. أما في المخطط التقليدي، فتتطلب هذه التغييرات طلبًا جديدًا إلى النموذج، وتصطدم مجددًا بالتأخير.
الأثر العملي للنهج
عندما تُنقل الأفعال المنعكسة خارج مسار LLM الثقيل، لا يتغير زمن التأخير فحسب، بل يتغير أيضًا الإحساس بأن النظام «حي». يتوقف المستخدم عن انتظار أن يكمل الذكاء المسار كله، ويبدأ برؤية سلوك متواصل. وهذا تحول مهم لفرق المنتجات: فجودة الوكيل لم تعد تُقاس بجمال لقطة العرض التجريبي، بل بمدى طبيعية حفاظه على إيقاع التفاعل. وفي المنتج التفاعلي يكون هذا غالبًا أهم من النص المثالي، لأن الإحساس بالحضور ينهار قبل أن يتمكن المستخدم من تقدير عمق الإجابة.
- استجابات فورية للأحداث والصوت والعقبات والأوامر
- ربط سلس بين التوليد والرسوم المتحركة والتحكم
- تبديل سريع للدور أو الطابع أو أسلوب الرد
- تعلّم السلوك وتعديله دون إعادة تشغيل الوكيل بالكامل
باختصار، يقترح الفريق النظر إلى LLM لا بوصفه الدماغ الوحيد للنظام، بل بوصفه إحدى طبقاته. وهذا يغيّر زاوية النظر الهندسية: فبدلًا من صراع لا ينتهي مع زمن الشبكة والاستدلال الثقيل (inference)، يصبح بالإمكان تصميم محرك مستقل للوقت الفعلي. نعم، قد تكون الصورة المرئية للنموذج الأولي خامًا. لكن إذا كانت طبقة الأفعال المنعكسة تحافظ على الإيقاع فعلًا، فيمكن ترك صقل الرسوميات واليدين والإطارات للنسخة التالية.
ماذا يعني ذلك
تُظهر هذه القصة بوضوح الاتجاه الذي تسير نحوه وكلاء الذكاء الاصطناعي: أنظمة هجينة تُفصل فيها الأفعال المنعكسة السريعة عن الاستدلال البطيء. وبالنسبة لمن يطوّرون الألعاب والمساعدات الصوتية والذكاء الاصطناعي المجسَّد (embodied AI)، فهذه خطوة شبه إلزامية، فبدونها سيبدو حتى أفضل LLM بطيئًا وأخرق.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.