«Передовые Платежные Решения» تطلق مساعد ذكاء اصطناعي صوتيًا للمكالمات في مرحلة تجريبية دون فريق ML
قدّمت «Передовые Платежные Решения» حالة نادرة في السوق: لم يبنِ المساعد الصوتي بالذكاء الاصطناعي للمكالمات مهندسو ML، بل 12 مطوّر backend. وخلال ستة أشهر أوصل الفريق المنتج إلى مرحلة التجربة، وتخلّى عن fine-tuning وعن قاعدة البيانات المتجهية الثقيلة، ونقل التوليد إلى نموذج Qwen 8B المحلي، فحصل على زمن استجابة عملي يقارب ثانيتين، وهو كافٍ لتقديم التلميحات للمدير أثناء المحادثة نفسها. وتبلغ هذه الشركة بأنها لم تحتج إلى فريق ML جاهز من الصفر. فقد سمح التبسيط الصارم للبنية المعمارية والاستغناء عن المكونات «الذكية» غير الضرورية ببناء الحد الأدنى من المنتج القابل للتشغيل (MVP) بسرعة أكبر. وما زال الأثر الإحصائي على التحويل ومؤشرات الأداء (KPI) غير مثبت: فالمنتج يحتاج أولًا إلى التوسّع والتكامل السلس داخل نظام CRM.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News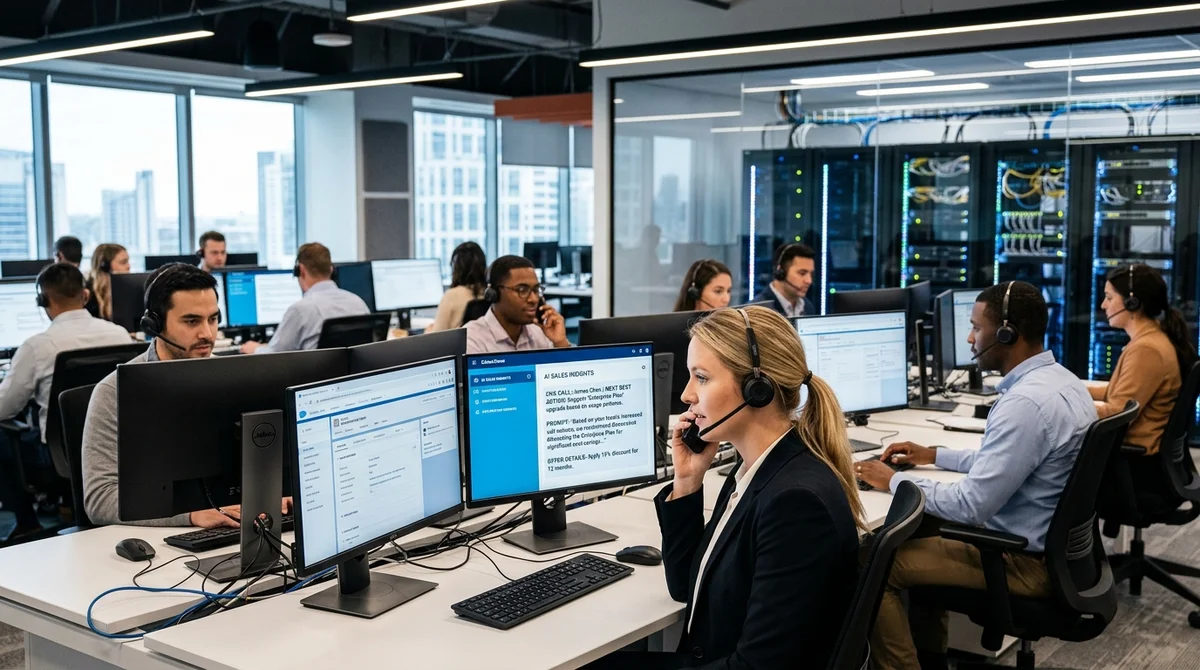
روت شركة «Передовые Платежные Решения» كيف أطلقت مساعدًا صوتيًا بالذكاء الاصطناعي للمكالمات في مرحلة تجريبية دون فريق ML خاص بها. وخلال ستة أشهر بنى 12 مطوّر backend نظامًا يقترح على المدير في الوقت الفعلي كيف يردّ على العميل، ويلتزم بزمن استجابة يقارب ثانيتين.
كيف بُني الحد الأدنى من المنتج القابل للتشغيل (MVP)
أطلقت الشركة على المشروع داخليًا اسم «Суфлёр» (الملقّن). مهمته أن يستمع إلى محادثة جرى تفريغها نصيًا بالفعل، ويحدد المنتج الذي يدور حوله الحديث، ويلتقط اعتراض العميل، ثم يعرض للمدير فورًا تلميحًا نصيًا. بُنيت الحزمة التقنية النهائية على Python وFastAPI وPostgreSQL، وتولّت مصنّفات BERT ونموذج Qwen 8B المحلي مهمتي التصنيف والتوليد.
وبالنسبة إلى الأعمال، هذا أسلوب لتخفيف العبء عن المرشدين وتسريع وصول الموظفين الجدد إلى مستوى KPI المطلوب، خصوصًا مع وجود أكثر من 35 منتجًا في المنظومة، ما يضطر المدير إلى الإحاطة بعدد كبير جدًا من السيناريوهات. وكان القيد الأساسي صارمًا: أمام النظام 1,5–2 ثانية فقط للرد، وإلا فقد التلميح معناه في خضم حوار حي.
ووصل الفريق إلى نموذج أولي عملي بسرعة. ففي الأسابيع الثلاثة الأولى أخذ المطوّرون نصوص تفريغ المكالمات، ودرّبوا مصنّفَي BERT على نحو 1,5 ألف حوار، وبنوا قواعد معرفة بسيطة تضم النصوص الإرشادية (السكربتات)، وربطوا كل ذلك عبر prompts بنموذج GPT سحابي. وأُنجزت الواجهة في يوم واحد باستخدام Django. كان إثبات المفهوم (proof-of-concept) هذا بطيئًا بزمن استجابة 10–15 ثانية، لكنه كفى لإقناع الإدارة بالفكرة والحصول على الضوء الأخضر لبناء MVP. بعد ذلك بدأ العمل الهندسي لتقليص التأخير وتثبيت الأداء وإنجاز التكاملات.
لماذا جرى التبسيط
صمّم الفريق في البداية، كما يحدث كثيرًا في مشاريع الذكاء الاصطناعي، نظامًا طموحًا أكثر مما ينبغي: خط معالجة صوت خاصًا به، وعدة مصنّفات معقدة، وfine-tuning لنموذج لغوي كبير، وقاعدة بيانات متجهية، وحتى حلقة تعلّم ذاتي. لكن سرعان ما اتضح أن هذا المسار سيمدّد الإطلاق إلى 12–18 شهرًا ويرفع احتمال الفشل بشدة. وبدلًا من محاولة بناء بنية «مثالية»، بدأ المطوّرون يحذفون تدريجيًا كل ما يمكن الاستغناء عنه في الإصدار الأول.
«لم نكن نحارب المشكلات، بل أعدنا تصميم النظام بحيث لا تنشأ هذه المشكلات فيه».
- تخلّوا عن fine-tuning لصالح RAG، كي لا يقضوا أشهرًا في وسم البيانات ولتقليل خطر الهلوسة.
- لم يكتبوا نظام تفريغ صوتي خاصًا بهم، بل استخدموا مقاطع نصية جاهزة من Voximplant.
- بسّطوا مصنّف الاعتراضات: فبدلًا من أكثر من 15 فئة، اكتفوا بمخطط ثنائي «يوجد اعتراض / لا يوجد اعتراض».
- لم يلجؤوا إلى قاعدة بيانات متجهية ثقيلة لبضعة ميغابايتات من البيانات، وحمّلوا ملفات JSON المهيكلة مباشرة في الذاكرة.
- تخلّوا عن واجهات API السحابية لصالح Qwen 8B المحلي على خادم GPU، لكي يلتزموا بزمن الاستجابة ولا يُخرجوا البيانات الحساسة خارج المحيط الداخلي للشركة.
تبيّن أن مجموعة التنازلات هذه كانت العامل الحاسم. فالنماذج السحابية كانت تردّ خلال 7–20 ثانية، أما Qwen 32B فرغم أن إجاباتها أجود، فإنها لم تستوفِ شرط الزمن أيضًا. وجاء نموذج Qwen 8B الأكثر اختصارًا جيدًا بما يكفي لتقديم التلميحات للمدير، وثبّت زمن الاستجابة عند نحو ثانيتين. وفي الوقت نفسه حسم النشر المحلي مسائل أمن المعلومات: فلا حاجة إلى إرسال نصوص المحادثات إلى خدمات خارجية، وبالتالي لم يكن لازمًا بناء طبقة مستقلة لإخفاء البيانات الشخصية ولا دفع كلفتها في صورة تأخير إضافي.
ماذا أظهرت التجربة
لم تكن النماذج أكثر المشكلات التي جرى الاستهانة بها، بل البيانات. فقد أخذ الفريق 200 مكالمة ووزّعها على 12 مشاركًا، وسرعان ما اصطدم بالوسم اليدوي: فلتصنيف الاعتراضات تصنيفًا صحيحًا لا يكفي اقتطاع العبارة، بل يلزم فهم سياق المحادثة ومنطق المبيعات. ونتيجة لذلك أعاد المطوّرون صياغة المهمة نفسها. فبدلًا من محاولة «تعليم الذكاء الاصطناعي أن يفكّر كخبير»، ركّزوا على هدف أضيق: التقاط اللحظة التي يحتاج فيها المدير إلى مساعدة في الوقت المناسب، ثم سحب السكربت المناسب وتوليد التلميح.
وبحسب نتائج التجربة، بلغ متوسط زمن الاستجابة نحو ثانيتين، ولم يرتفع إلى ثلاث ثوانٍ إلا في 2–3% من الحالات. وحققت دقة تصنيف الخدمات أكثر من 70%، أما التعرّف على الكلام فبلغ 92% فما فوق بحسب جودة الاتصال. ويذكر الفريق أن التجربة حققت بالفعل أثرًا نوعيًا: ظهرت إشارات أولى تتعلق بسهولة الاستخدام وتخفيف العبء عن المرشدين والفائدة العامة للمشغّلين. لكن لا توجد حتى الآن استنتاجات ذات دلالة إحصائية بشأن التحويل وKPI، فلتحقيق ذلك يحتاج المنتج إلى التوسّع والتكامل السلس مباشرة داخل CRM.
ماذا يعني ذلك
تُظهر هذه الحالة بوضوح أن المنتج الداخلي القائم على الذكاء الاصطناعي لا يتطلب دائمًا فريق ML جاهزًا من الصفر. فإذا امتلكت الشركة مهندسي backend أقوياء، وألمًا تجاريًا واضحًا، ووصولًا إلى العمليات، أمكن بناء MVP بسرعة أكبر عبر التبسيط الصارم للبنية المعمارية والاستغناء عن المكونات «الذكية» الزائدة.
والخلاصة الرئيسية هنا ليست في اختيار نموذج بعينه، بل في الانضباط: أن تحلّ مشكلة العمل أولًا، ثم تتحقق من قيود السرعة والأمان، وبعد ذلك فقط تعقّد الحزمة التقنية.
- 25 أكتوبر 2026منصة Artificial Analysis تطلق AA-PersonalityBench: تقييم 36 نموذجاً عبر 30 سمة و900 سؤال
- 25 أكتوبر 2026SpaceXAI تمنح Omarchy توكنات Grok بقيمة $1,5 مليون لمراجعة الشيفرة وإصلاح الأخطاء
- 25 أكتوبر 2026عمالقة التكنولوجيا يتجهون إلى الاستدانة: Alphabet وMeta تقترضان مليارات الدولارات لتمويل الذكاء الاصطناعي
- 25 أكتوبر 2026Nvidia تجري محادثات للاستحواذ على Reflection AI أو زيادة استثماراتها فيها
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول كيف بُني الحد الأدنى من المنتج القابل للتشغيل (MVP)؟
أطلقت الشركة على المشروع داخليًا اسم «Суфлёр» (الملقّن). مهمته أن يستمع إلى محادثة جرى تفريغها نصيًا بالفعل، ويحدد المنتج الذي يدور حوله الحديث، ويلتقط اعتراض العميل، ثم يعرض للمدير فورًا تلميحًا نصيًا. بُنيت الحزمة التقنية النهائية على Python وFastAPI وPostgreSQL، وتولّت مصنّفات BERT ونموذج Qwen 8B المحلي مهمتي التصنيف والتوليد. وبالنسبة إلى الأعمال، هذا أسلوب لتخفيف العبء عن المرشدين وتسريع وصول الموظفين الجدد إلى مستوى KPI المطلوب، خصوصًا مع وجود أكثر من 35 منتجًا في المنظومة، ما يضطر المدير إلى الإحاطة بعدد كبير جدًا من السيناريوهات. وكان القيد الأساسي صارمًا: أمام النظ
ما أبرز التفاصيل حول لماذا جرى التبسيط؟
صمّم الفريق في البداية، كما يحدث كثيرًا في مشاريع الذكاء الاصطناعي، نظامًا طموحًا أكثر مما ينبغي: خط معالجة صوت خاصًا به، وعدة مصنّفات معقدة، وfine-tuning لنموذج لغوي كبير، وقاعدة بيانات متجهية، وحتى حلقة تعلّم ذاتي. لكن سرعان ما اتضح أن هذا المسار سيمدّد الإطلاق إلى 12–18 شهرًا ويرفع احتمال الفشل بشدة. وبدلًا من محاولة بناء بنية «مثالية»، بدأ المطوّرون يحذفون تدريجيًا كل ما يمكن الاستغناء عنه في الإصدار الأول. «لم نكن نحارب المشكلات، بل أعدنا تصميم النظام بحيث لا تنشأ هذه المشكلات فيه». تخلّوا عن fine-tuning لصالح RAG، كي لا يقضوا أشهرًا في وسم البيانات ولتقليل خطر الهلوسة
ما أبرز التفاصيل حول ماذا أظهرت التجربة؟
لم تكن النماذج أكثر المشكلات التي جرى الاستهانة بها، بل البيانات. فقد أخذ الفريق 200 مكالمة ووزّعها على 12 مشاركًا، وسرعان ما اصطدم بالوسم اليدوي: فلتصنيف الاعتراضات تصنيفًا صحيحًا لا يكفي اقتطاع العبارة، بل يلزم فهم سياق المحادثة ومنطق المبيعات. ونتيجة لذلك أعاد المطوّرون صياغة المهمة نفسها. فبدلًا من محاولة «تعليم الذكاء الاصطناعي أن يفكّر كخبير»، ركّزوا على هدف أضيق: التقاط اللحظة التي يحتاج فيها المدير إلى مساعدة في الوقت المناسب، ثم سحب السكربت المناسب وتوليد التلميح. وبحسب نتائج التجربة، بلغ متوسط زمن الاستجابة نحو ثانيتين، ولم يرتفع إلى ثلاث ثوانٍ إلا في 2–3% من الحا
Build & Ship Production AI Apps with Vibe Coding
Join Zhemal Khamidun's hands-on Vibe Coding Intensive at hamidun.com/vibecoding — master Claude Code, Cursor, and autonomous agentic workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.