MIT Technology Review: لماذا لم تعد اختبارات الذكاء الاصطناعي القياسية تعكس الفائدة الحقيقية
تشير MIT Technology Review إلى أن معايير الذكاء الاصطناعي المعتادة تقيس النموذج بمعزل عن بيئة العمل، ولذلك تتنبأ بشكل ضعيف بأثره في العمل الفعلي. وتسوق المقالة مثال الأنظمة الطبية: تبدو قوية في الاختبارات، لكنها في المستشفيات تضيف تأخيرات بسبب المراجعة الجماعية ومعايير إعداد التقارير والمتطلبات التنظيمية. والخلاصة بسيطة: ينبغي ألا يقتصر التقييم على إجابة واحدة من النموذج، بل يجب أن يشمل سلوكه داخل العمليات والفرق.
معالج بواسطة الذكاء الاصطناعي من MIT Technology Review؛ بتحرير Hamidun News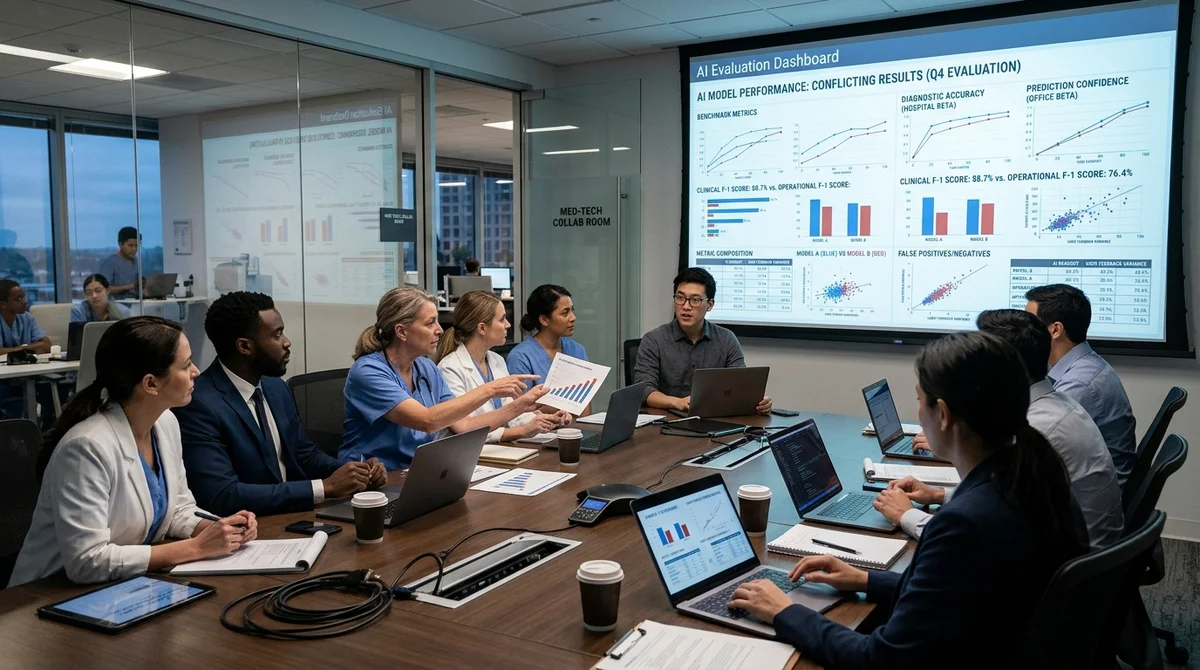
تشير MIT Technology Review إلى أن معايير الذكاء الاصطناعي المعتادة باتت أقل قدرة على إظهار كيفية تصرف الأنظمة في العمل الفعلي. فقد يتفوق النموذج في اختبار معزول، ومع ذلك يبطئ عمل الفريق إذا أُدمج في عملية حية.
لماذا تتباين نتائج الاختبارات؟
على مدى عقود، قيس التقدم في الذكاء الاصطناعي عبر منافسة «الآلة ضد الإنسان». وهو نهج مريح: تُعطى النماذج الشطرنج أو مسائل الرياضيات أو البرمجة أو المقالات، ثم تُقارن نتيجتها بأداء شخص بمفرده. ومن السهل توحيد هذه الاختبارات وتحويلها إلى تصنيفات واستخدامها في التسويق. ولذلك نشأت حول المعايير صناعة كاملة من الأرقام اللافتة ولوحات المتصدرين والمقارنات التي تبدو رائعة في العروض التقديمية.
لكن المشكلة أن الذكاء الاصطناعي لا يُستخدم تقريبًا أبدًا بالطريقة التي يُختبر بها. ففي العمل الفعلي لا يوجد النظام في فراغ، بل يندمج في الفرق والعمليات والقواعد والمواعيد النهائية والمعايير الداخلية. وتظهر قيمته لا في إجابة واحدة، بل في سلسلة من التفاعلات على مدى أسابيع وأشهر. لذلك فإن الدرجة العالية في مهمة معزولة لا تعني بعد أن النموذج سيسرّع العمل أو يقلل الأخطاء، أو أنه سيكون مفيدًا للمؤسسة أصلًا.
أين يختل التقييم؟
تورد المقالة مثالًا لافتًا من الطب. هناك أنظمة لتحليل الصور الطبية تقرأ الصور في الاختبارات أسرع وأدق من أطباء الأشعة ذوي الخبرة. وعلى الورق يبدو ذلك وصفة جاهزة لرفع الإنتاجية. لكن القرار في المستشفى نادرًا ما يتخذه اختصاصي واحد في لحظة واحدة. فقد يعمل حول الحالة الواحدة أطباء الأشعة وأطباء الأورام والفيزيائيون والممرضات وغيرهم من أعضاء الفريق، وتتغير خطة العلاج مع ظهور بيانات جديدة.
وعندما تدخل هذه الأدوات في المسار الفعلي للعمل، يتبين أن الكادر يحتاج إلى وقت إضافي لتفسير إجابات النموذج ومطابقتها مع المعايير المحلية لإعداد التقارير والتحقق من توافقها مع المتطلبات التنظيمية. وفي النتيجة، فإن النظام الذي وعد في الاختبار بالتسريع يخلق أحيانًا تأخيرات في الممارسة. بل قد يعزز «التثبيت» المبكر على إجابة معقولة لكنها غير مكتملة، ويرفع العبء المعرفي، وينقل الأخطاء إلى مراحل لاحقة في السلسلة. وهكذا ينشأ «مقبرة الذكاء الاصطناعي» — منتجات بدرجات تقييم عالية لا تستقر في العمل الفعلي.
ما البديل المقترح؟
بدلًا من الاختبارات الضيقة، يقترح كاتب المقالة معايير HAIC — Human-AI, Context-Specific Evaluation (التقييم الخاص بالسياق للتفاعل بين الإنسان والذكاء الاصطناعي). وهو نهج لا يقيّم النموذج وحده، بل يقيّم أيضًا سلوكه داخل فريق محدد وعملية محددة وبيئة تنظيمية محددة. والغاية تقريب التقييم من الاستخدام الفعلي بدل العرض المخبري.
- نقل التركيز من المهمة المنفردة إلى عمل الفريق والعملية بأكملها
- قياس الأثر لا في تشغيل اختباري واحد، بل على مدى زمني طويل
- عدم الاكتفاء بالسرعة والدقة، بل اعتبار التنسيق وجودة القرار المشترك ووضوح الأخطاء عوامل مهمة
- النظر لا إلى إجابة النموذج فقط، بل إلى النتائج قبل استخدامه وبعده
ويصف الكاتب أيضًا أمثلة مبكرة على هذا النهج. ففي أحد أنظمة المستشفيات البريطانية، لم يُطرح السؤال بصيغة «هل أصبح التشخيص أدق»، بل «هل يغيّر الذكاء الاصطناعي جودة النقاش الجماعي والتفاعل بين الاختصاصيين». وفي القطاع الإنساني، رُصد نظام مشابه على مدى 18 شهرًا، وجرت متابعة منفصلة لمدى سهولة ملاحظة الناس لأخطاء النموذج وتصحيحها. ويتيح هذا الأفق الزمني الطويل تصميم آليات حماية تناسب السياق المحدد، بدل الاعتماد على أن الدرجة العالية في الاختبار تضمن وحدها السلامة والفائدة.
ماذا يعني ذلك؟
تصطدم الصناعة تدريجيًا بحدود المقاييس القديمة: فهي تُظهر جيدًا ما يستطيع النموذج فعله بمفرده، لكنها تُظهر بصورة ضعيفة ما يحدث عندما يصبح جزءًا من مؤسسة حية. وبالنسبة إلى الشركات والدول، هذه إشارة إلى ضرورة النظر لا إلى لوحات المتصدرين فحسب، بل إلى ما إذا كان الذكاء الاصطناعي يساعد الفرق على العمل بثبات وسرعة وأمان أكبر في ظروف حقيقية.
أسئلة وأجوبة حول الخبر
لماذا تتباين نتائج الاختبارات؟
على مدى عقود، قيس التقدم في الذكاء الاصطناعي عبر منافسة «الآلة ضد الإنسان». وهو نهج مريح: تُعطى النماذج الشطرنج أو مسائل الرياضيات أو البرمجة أو المقالات، ثم تُقارن نتيجتها بأداء شخص بمفرده. ومن السهل توحيد هذه الاختبارات وتحويلها إلى تصنيفات واستخدامها في التسويق. ولذلك نشأت حول المعايير صناعة كاملة من الأرقام اللافتة ولوحات المتصدرين والمقارنات التي تبدو رائعة في العروض التقديمية. لكن المشكلة أن الذكاء الاصطناعي لا يُستخدم تقريبًا أبدًا بالطريقة التي يُختبر بها. ففي العمل الفعلي لا يوجد النظام في فراغ، بل يندمج في الفرق والعمليات والقواعد والمواعيد النهائية والمعايير الدا
أين يختل التقييم؟
تورد المقالة مثالًا لافتًا من الطب. هناك أنظمة لتحليل الصور الطبية تقرأ الصور في الاختبارات أسرع وأدق من أطباء الأشعة ذوي الخبرة. وعلى الورق يبدو ذلك وصفة جاهزة لرفع الإنتاجية. لكن القرار في المستشفى نادرًا ما يتخذه اختصاصي واحد في لحظة واحدة. فقد يعمل حول الحالة الواحدة أطباء الأشعة وأطباء الأورام والفيزيائيون والممرضات وغيرهم من أعضاء الفريق، وتتغير خطة العلاج مع ظهور بيانات جديدة. وعندما تدخل هذه الأدوات في المسار الفعلي للعمل، يتبين أن الكادر يحتاج إلى وقت إضافي لتفسير إجابات النموذج ومطابقتها مع المعايير المحلية لإعداد التقارير والتحقق من توافقها مع المتطلبات التنظيمية
ما البديل المقترح؟
بدلًا من الاختبارات الضيقة، يقترح كاتب المقالة معايير HAIC — Human-AI, Context-Specific Evaluation (التقييم الخاص بالسياق للتفاعل بين الإنسان والذكاء الاصطناعي). وهو نهج لا يقيّم النموذج وحده، بل يقيّم أيضًا سلوكه داخل فريق محدد وعملية محددة وبيئة تنظيمية محددة. والغاية تقريب التقييم من الاستخدام الفعلي بدل العرض المخبري. نقل التركيز من المهمة المنفردة إلى عمل الفريق والعملية بأكملها قياس الأثر لا في تشغيل اختباري واحد، بل على مدى زمني طويل عدم الاكتفاء بالسرعة والدقة، بل اعتبار التنسيق وجودة القرار المشترك ووضوح الأخطاء عوامل مهمة النظر لا إلى إجابة النموذج فقط، بل إلى الن
ماذا يعني ذلك؟
تصطدم الصناعة تدريجيًا بحدود المقاييس القديمة: فهي تُظهر جيدًا ما يستطيع النموذج فعله بمفرده، لكنها تُظهر بصورة ضعيفة ما يحدث عندما يصبح جزءًا من مؤسسة حية. وبالنسبة إلى الشركات والدول، هذه إشارة إلى ضرورة النظر لا إلى لوحات المتصدرين فحسب، بل إلى ما إذا كان الذكاء الاصطناعي يساعد الفرق على العمل بثبات وسرعة وأمان أكبر في ظروف حقيقية.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.