DeepSeek وGemma: كيف حطّمت تجربة نموذج لغوي هجين على Kaggle مكتبة Transformers
جرّب مطوّرون على Kaggle ما يبدو شبه مستحيل: أخذوا أوزان Gemma بحجم 31B، وزرعوها في هيكل MoE الخاص بـ DeepSeek، وشغّلوا النموذج الهجين دون أي إعادة تدريب. ولتحقيق ذلك اضطروا إلى ترقيع مكتبة Transformers، وتجاوز خلل في تهيئة الأوزان بدقة 4 بت، والبحث يدويًا عن الخبراء المخفيين في البنية. النتيجة أن النموذج يتحدث بكلام غير مترابط، لكن التجربة نفسها تُظهر إلى أي مدى يمكن الذهاب باستخدام PyTorch وHugging Face ومجموعة من الحيل البرمجية.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News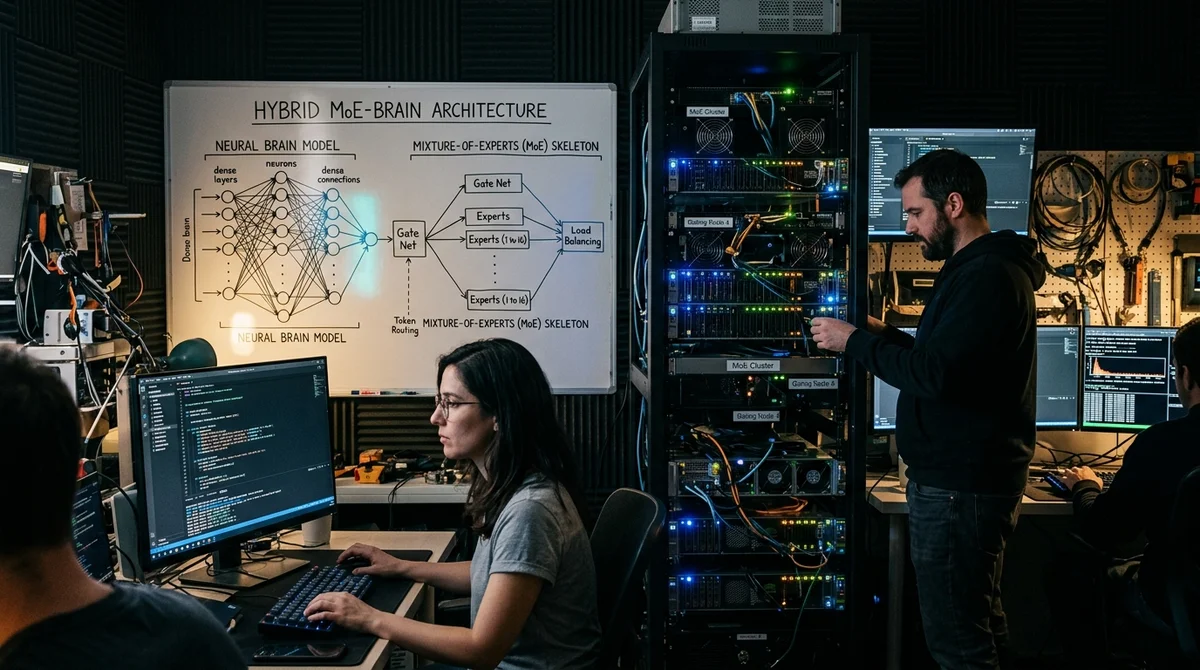
جمع هواة نموذجًا لغويًا هجينًا بما يكاد يخالف القواعد المتعارف عليها: أخذوا أربع طبقات من نموذج Gemma بحجم 31B، ودمجوها في بنية MoE فارغة من DeepSeek-V4 دون أي إعادة تدريب. لم ينتج عن ذلك منافس عملي لـ ChatGPT، لكن العملية كشفت إلى أي عمق يمكن العبث ببنية PyTorch وTransformers لاختبار فكرة متطرفة.
لماذا الحاجة إلى نموذج هجين
نشأت الفكرة من قيود صارمة للغاية: وحدتا T4 مجانيتان في Kaggle، وحوالي 30 غيغابايت من ذاكرة RAM، ولا ميزانية لإجراء fine-tuning كامل. وبدلًا من التدريب، قرر المؤلفون اختبار سيناريو أكثر خشونة، هو الدمج البنيوي بين النماذج. وكان المتبرّع هو Gemma-4-31B بعد ضغطها إلى صيغة NF4 بدقة 4 بت، أما «الهيكل» فكان DeepSeek-V4 فارغًا بموجّه Mixture-of-Experts. بدت المهمة أقرب إلى نكتة: نقل جزء من الأوزان من بنية إلى أخرى ومعرفة ما إذا كان بالإمكان بعث الحياة في هذا الكائن الهجين أصلًا.
من الناحية الهندسية، لم تكن قيمة المشروع في جودة الإجابات، بل في مجرد إمكانية التوافق. فبين Gemma وDeepSeek اختلاف في الأبعاد، ومنطق خاص للتطبيع، وكتل attention مختلفة، وقواعد مستقلة لتوجيه الرموز بين الخبراء. وفي الكتب الدراسية يُصنَّف هذا النوع من النقل عادةً ضمن المستحيل دون إسقاطات وسيطة وإعادة تدريب. تعمّد المؤلفون مخالفة هذه القاعدة، وجعلوا التجربة اختبار بقاء للمكتبات: ما الذي سينهار أولًا، النموذج أم ذاكرة Kaggle أم حزمة Hugging Face نفسها.
أين كان كل شيء ينهار
بدأ أول خلل مبكرًا في مرحلة التحميل. فقد رفضت Transformers التعرف على النوع المخصص `gemma4` بشكل سليم، ثم انهارت بخطأ `dict.to_dict()`، لأن إحدى الوحدات الداخلية حوّلت الإعداد إلى قاموس عادي ثم حاولت التعامل معه فورًا ككائن. وللمضي قدمًا، سجّل المؤلفون هذا النوع يدويًا في `CONFIG_MAPPING`، وأضافوا monkey patch للفئة `GenerationConfig` يغلّف القاموس بكائن وسيط أثناء التشغيل. ودون ذلك كانت العملية بأكملها تنتهي قبل أن يُنشأ النموذج الهجين أصلًا.
بعد ذلك حاولت المكتبة تهيئة المناطق الفارغة في DeepSeek بضوضاء عشوائية عبر استدعاء `normal_`. وهنا أصدرت PyTorch الخطأ `NotImplementedError`: فقد حُمّلت أوزان المتبرّع عبر bitsandbytes بصيغة 4 بت وخُزّنت بنوع `uint8`، بينما يعمل مولّد التوزيع الطبيعي مع تنسورات float فقط. وجاء الحل مباشرًا إلى أقصى حد: اعترض المؤلفون `TORCH_INIT_FUNCTIONS["normal_"]` ومنعوا هذه الدوال من لمس التنسورات البايتية. ليس هذا إصلاحًا أنيقًا، بل التفافًا جراحيًا، لكن عملية الزرع ما كانت لتبدأ بدونه.
وكان الجزء الأكثر إزعاجًا هو خبراء DeepSeek والذاكرة. فقد كانت كتل MoE مخبّأة لا في `ModuleList` عادية، بل داخل فئة مخصصة لا يمكن المرور عليها بحلقة تكرار بسيطة. يضاف إلى ذلك أن فك ضغط طبقة Gemma بحجم 31B في ذاكرة Kaggle كان يؤدي تقريبًا فورًا إلى OOM. وللالتفاف على ذلك كتب المؤلفون «سونارًا» تعاوديًا يبحث عن الطبقات الفرعية المطلوبة عبر السمات `gate_proj` و`up_proj` و`down_proj`، ونقلوا الأوزان على دفعات صغيرة عبر CPU، مع توزيع النماذج على وحدتي GPU واستدعاء جامع المهملات باستمرار.
«في تعلّم الآلة لا توجد جدران معمارية منيعة».
كيف خُيّط النموذج
جمع السكربت النهائي العملية كلها في سلسلة من الترقيعات الصارمة ونسخ الأوزان. فمن أجل كل طبقة من الطبقات الأربع، كان يختار المصفوفات بما يناسب حجم الطبقة المستهدفة، ويملؤها بالأصفار عند الحاجة، ثم يزرع إسقاطات attention على حدة، ومكوّنات MLP على حدة لدى كل خبير عُثر عليه. وبعد كل عملية نسخ كبيرة كانت الذاكرة تُنظَّف فورًا. وبعد الزرع اضطر المؤلفون أيضًا إلى إعادة كتابة موجّه MoE، كي لا ينهار النموذج أثناء الاستدلال بسبب تعارض الأبعاد، وكي يتمكن من إنتاج نص ما على الأقل.
كانت الخطوات التقنية الرئيسية كالتالي:
- تسجيل إعداد Gemma المخصص في السجل العام لـ Transformers
- Monkey patch للفئة `GenerationConfig` يتجاوز خطأ `dict.to_dict()`
- حظر `normal_` على أوزان `uint8` بدقة 4 بت
- بحث تعاودي عن الخبراء ونقل المصفوفات على دفعات صغيرة عبر CPU
أظهر اختبار النموذج الهجين الناتج ما كان متوقعًا: فقد عمل النموذج فعلًا، لكنه ولّد نصًا غير مترابط، خليطًا من رموز عشوائية وفتات جمل. ومع ذلك عدّ المؤلفون ذلك نجاحًا، لأن الهدف لم يكن جودة الإجابات بل إثبات المبدأ. فهم لم يوحّدوا المعاجم، ولم يدرّبوا إسقاطات انتقالية، ولم يجروا fine-tuning بعد الزرع، لذلك كان تدفق الرموز الفوضوي عند المخرجات شبه حتمي. لكن التجربة أثبتت أن القيود المعمارية كثيرًا ما تكون ليست جدارًا، بل قائمة طويلة من المشكلات منخفضة المستوى التي يمكن تجاوزها بالشيفرة.
ماذا يعني هذا
لا تنتج مثل هذه التجارب منتجًا جاهزًا، لكنها تُظهر جيدًا حدود نماذج LLM مفتوحة المصدر الحالية. فإذا أمكن ولو جزئيًا ربط الأوزان والتكميم والتوجيه وhidden states دون إعادة تدريب، فإن ذلك يفتح المجال أمام نماذج هجينة أكثر عملية، بإسقاطات سليمة وتكييف للمعجم وضبط لاحق. وبالنسبة للمطورين، فهذه إشارة إلى أن الحزمة البرمجية المحيطة بالنماذج لا تزال هشة، وبالتالي فإن المجال أمام التجميعات غير التقليدية يتسع فحسب.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.