Google DeepMind تطلق Gemini Robotics-ER 1.6 لتنفيذ المهام المستقلة في العالم الحقيقي
حدّثت Google DeepMind نموذج Gemini Robotics-ER إلى الإصدار 1.6 وركّزت على سيناريوهات العالم الحقيقي: من التعرف على الأجسام والتحقق من إنجاز المهام إلى قراءة المستشعرات ومقاييس الضغط. يتعامل النموذج بشكل أفضل مع عدة كاميرات، ويعدّ الأشياء ويحدد مواقعها بدقة أعلى، ويدعم استدعاء الأدوات الخارجية. وهو متاح بالفعل عبر Gemini API وGoogle AI Studio.
معالج بواسطة الذكاء الاصطناعي من DeepMind Blog؛ بتحرير Hamidun News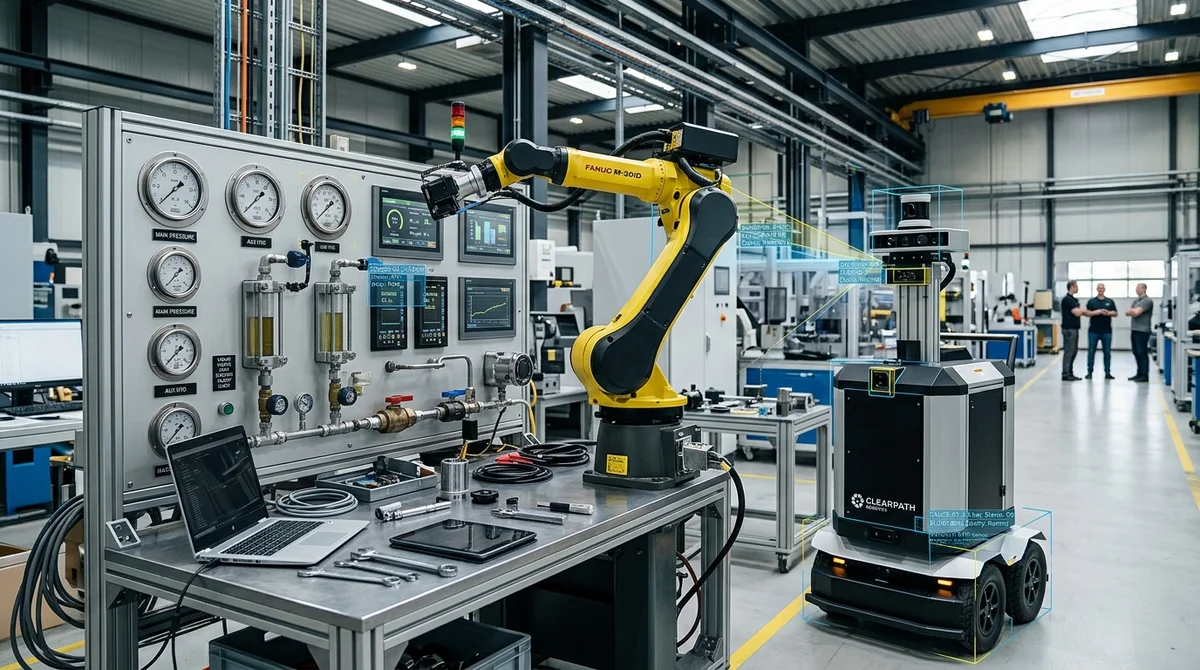
قدّمت Google DeepMind في 14 أبريل 2026 نموذج Gemini Robotics-ER 1.6، وهو نموذج استدلال محدَّث للروبوتات، صُمّم لا لمجرد تنفيذ الأوامر، بل لفهم البيئة المادية. وتراهن الشركة على ما يُعرف بالاستدلال المتجسّد (embodied reasoning)، أي قدرة النظام على الربط بين الإدراك البصري وسياق المهمة والفعل الحقيقي. وفي الإصدار الجديد ينصبّ التركيز على تفكير مكاني أدق، وفهم المشهد من عدة كاميرات، وتحديد ما إذا اكتملت المهمة بنجاح، وقراءة العدادات الصناعية. وبعبارة أخرى، يتعلق الأمر بـ«دماغ» رفيع المستوى للروبوت، يمكنه استدعاء أدوات خارجية ونماذج VLA ودوال مخصصة من المستخدم لتنفيذ سيناريوهات معقدة في العالم الحقيقي.
من أبرز التحسينات التعامل مع المهام المكانية. وتوضح DeepMind أن عملية أساسية مثل الإشارة إلى جسم ليست أمراً هامشياً بالنسبة للروبوت، بل هي الأساس لسلوك أكثر تعقيداً. فعبر النقاط، يستطيع النموذج لا العثور على الأشياء فحسب، بل عدّها أيضاً ومقارنة أحجامها وبناء العلاقات بينها واختيار أنسب نقاط الإمساك والتحقق من القيود الواردة في الأمر النصي (prompt). فعلى سبيل المثال، إذا كان على النظام أن يشير إلى كل الأجسام التي تتسع داخل كوب أزرق، فعليه أن يتعرف في الوقت نفسه على شكل الأشياء وحجمها وموضعها بالنسبة لبعضها. وفي العروض التوضيحية، حدّد Gemini Robotics-ER 1.6 عدد الأدوات في الإطار بدقة أكبر، ولم يشر إلى أجسام غير موجودة، وتفوّق عموماً بشكل ملحوظ في هذه المهام على Gemini Robotics-ER 1.5 وGemini 3.0 Flash.
المحور المهم الثاني هو فهم المشهد من عدة زوايا، إضافة إلى ما يسمى success detection، أي القدرة على تحديد ما إذا كانت المهمة قد أُنجزت فعلاً. وهذا أمر حاسم في الروبوتات المستقلة: فلا يكفي أن يبدأ الروبوت الفعل، بل عليه أن يدرك هل يجب إعادة المحاولة أم يمكنه الانتقال إلى الخطوة التالية في الخطة. وفي التركيبات الفعلية يزداد الأمر صعوبة، لأن الكاميرات غالباً ما تنظر إلى المشهد من الأعلى ومن الذراع الآلية في آن واحد، وقد يحجب بعض الأجسام بعضها بعضاً، كما تتغير الإضاءة والخلفية.
ويقوم Gemini Robotics-ER 1.6 بمطابقة عدة تدفقات فيديو بشكل أفضل ويكوّن منها صورة متكاملة. وكمثال، تعرض DeepMind سيناريو يحدد فيه النظام، انطلاقاً من عدة زوايا، ما إذا كانت مهمة «وضع القلم الأزرق في حامل الأقلام الأسود» قد اكتملت.
أما الإضافة الأكثر ارتباطاً بالتطبيق العملي فهي قراءة العدادات. وقد طوّرت DeepMind هذه القدرة بالتعاون مع Boston Dynamics، استناداً إلى مهام تفتيش المنشآت الصناعية. ففي المصانع والمرافق التقنية، يحتاج الروبوت إلى فحص منتظم لموازين الحرارة ومقاييس الضغط ومقاييس مستوى السوائل الكيميائية وزجاج المعاينة والشاشات الرقمية.
ولا يكفي لذلك التعرف على الصورة: إذ يجب أن يفهم النظام موضع المؤشر ومستوى السائل وحدود المقياس والتدريجات وتسميات وحدات القياس، بل أحياناً أن يدمج قراءات عدة مؤشرات تمثل خانات مختلفة من الرقم. وإذا كان الأمر يتعلق بزجاج معاينة، فعليه أيضاً أن يراعي التشوهات الناتجة عن زاوية الكاميرا. ووفق بيانات DeepMind، ارتفعت دقة قراءة العدادات من 23% لدى Gemini Robotics-ER 1.
5 و67% لدى Gemini 3.0 Flash إلى 86% لدى Gemini Robotics-ER 1.6.
ومع تفعيل وضع agentic vision تصل النسبة إلى 93%: إذ يقرّب النموذج أولاً المنطقة المطلوبة، ثم يستخدم الإشارة إلى النقاط الرئيسية وتنفيذ الشيفرة لتقدير النسب والفواصل، ثم يفسّر القيمة النهائية.
وتشدد DeepMind بشكل منفصل على السلامة. فهي تصف Gemini Robotics-ER 1.6 بأنه أكثر نماذجها أماناً للروبوتات حتى الآن. فهو يلتزم بشكل أفضل بسياسات Gemini في المهام المكانية العدائية، ويتقيّد بدقة أعلى بشكل ملحوظ بالقيود الفيزيائية، كما في الحالات التي لا يُسمح فيها للنظام بالتعامل مع السوائل أو برفع أجسام يزيد وزنها على 20 كيلوغراماً. إضافة إلى ذلك، في السيناريوهات المبنية على تقارير حقيقية عن الإصابات، يتفوق Robotics-ER على Gemini 3.0 Flash بزيادة قدرها 6 نقاط مئوية في المهام النصية و10 نقاط في مهام الفيديو المتعلقة بالتعرف على المخاطر.
والنموذج متاح للمطورين بالفعل عبر Gemini API وGoogle AI Studio، ومع الإصدار نشرت DeepMind مثالاً على Colab ودعت الشركاء إلى إرسال صور موسومة لأخطاء شائعة بهدف تحسين الإصدارات اللاحقة.
ويُظهر هذا التحديث الاتجاه الذي تنتقل إليه المنافسة في الروبوتات: فالميكانيكا وحدها تحسم أقل فأقل، وتحسم طبقة الاستدلال فوقها أكثر فأكثر. فإذا كان النموذج قادراً على رؤية المشهد من عدة نقاط، واستخدام الأدوات، وقراءة العدادات، والتحقق من النتيجة، مع مراعاة قيود السلامة، يتحول الروبوت من جهاز تنفيذي بحت إلى منظومة قادرة على العمل بحسب الموقف. وبالنسبة لعمليات التفتيش الصناعي والمستودعات وسيناريوهات الخدمة، فهذه من أكثر الإشارات عملية على أن نماذج الذكاء الاصطناعي الكبيرة تقترب من الاستقلالية الحقيقية خارج المختبر.
- 29 أكتوبر 2026Anthropic تكشف في نموذج S-1: 11 900 عميل يدفعون 100 ألف دولار سنويًا فأكثر
- 29 أكتوبر 2026Google DeepMind تكتشف عيبًا في softmax: التدرّج ينعدم عند فارق 16,6
- 28 أكتوبر 2026شبكة CNN من عام 2015 تتفوق على GPT-6 Astra وClaude Fable 5.1 في تشخيص سرطان الجلد
- 28 أكتوبر 2026Google تعلّم نماذج LLM «النوم»: SLEEP يثبّت المعرفة في الأوزان، وحتى 10 ملايين توكن
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.