لماذا يتفوق الدماغ على GPT-4 في كفاءة الطاقة بمئات الملايين من المرات، وإلى أين تتجه الرقاقات العصبية الشكل
يستهلك الدماغ البشري في كل فعل تفكير طاقة أقل بملايين المرات مما تستهلكه نماذج LLM الحديثة، والسبب لا يقتصر على العتاد. فالفارق الجوهري يكمن في الحوسبة التناظرية، والتنشيط المتناثر، والتكرارية، والتعلم المحلي. وفي المقابل، بدأت الرقاقات العصبية الشكل تخرج من المختبرات، وتُظهر منصات SpiNNaker2 وAkida وXylo الاتجاه الذي قد يسلكه عتاد الذكاء الاصطناعي في السنوات القريبة. ويقارن المقال بين الدماغ ونماذج LLM بدءًا من الأرقام الأساسية، ثم ينتقل إلى المبادئ الحاسوبية التي تفسّر الفجوة: الحوسبة التناظرية، والتكرارية والديناميكية الزمنية، والتناثر، والتعلم المحلي، وفيزياء الركيزة المادية نفسها. أما على الصعيد العملي، فلا تزال أفضل الحلول العصبية الشكل متأخرة عن الدماغ بنحو ثلاث رتب من حيث كفاءة الطاقة، وتتطلب بيئة برمجية مختلفة تمامًا. ومن المرجح أن تنمو هذه الرقاقات في 2026–2028 في الروبوتات وأجهزة التحكم الصناعية وأجهزة الاستشعار والأنظمة المستقلة.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News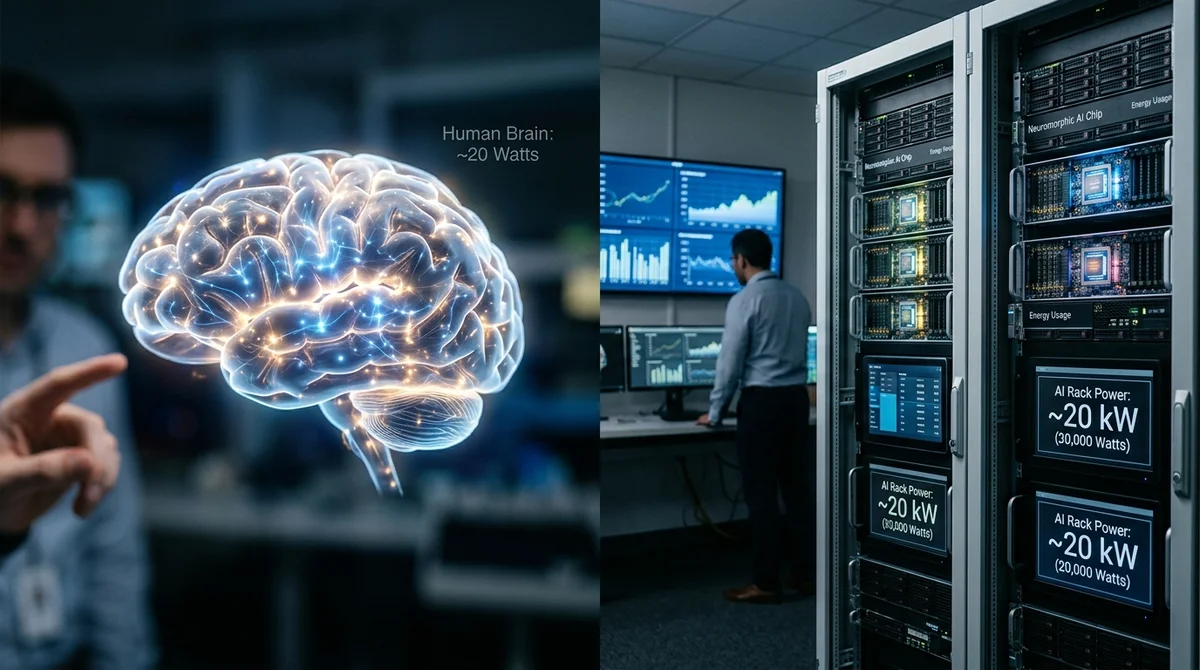
تكشف المقارنة بين الدماغ البشري ونماذج LLM الحديثة حقيقة محرجة لصناعة الذكاء الاصطناعي: حتى أقوى النماذج لا تزال شديدة الاستهلاك للطاقة. فالدماغ يعمل بنحو 20 واط، بينما قد تتطلب النماذج اللغوية الكبيرة كيلوواتات أثناء الاستدلال (inference)، وميغاواتات من القدرة في مرحلة التدريب. وإذا تجاوزنا اختبارات الأداء التسويقية ونظرنا إلى كلفة فعل التفكير الواحد، يتضح أن الفارق هائل: فالبيولوجيا ما زالت تنجز العمل نفسه بتكلفة أقل بعدة رتب من السيليكون.
يبدأ المقال المقارنة بالأرقام الأساسية. يُقدَّر أن الدماغ ينفّذ نحو 10 مرفوعة إلى القوة 16 عملية مشبكية في الثانية، باستهلاك طاقة يبلغ نحو 20 واط. أما نماذج LLM الحديثة فتبلغ مقياسًا حسابيًا مماثلًا بالاعتماد على وحدات GPU وTPU، لكن كلفة كل عملية أعلى بكثير. وعلى مستوى الطاقة اللازمة للعملية الواحدة، نتحدث عن أتوجول (attojoule) في الدماغ مقابل بيكوجول (picojoule) فأكثر في المسرّعات الرقمية.
ويورد المؤلف مثالًا أوضح: للإجابة عن سؤال بسيط، مثل الفرق بين الميثان والإيثان، ينشّط الدماغ نسبة صغيرة فقط من الخلايا العصبية ويستهلك نحو أعشار الجول، في حين يتعيّن على GPT-4 تحميل مصفوفة ضخمة من المعاملات وتنفيذ حجم هائل من العمليات المصفوفية. وفي هذا الطرح قد تصل الفجوة إلى مئات الملايين من المرات.
والسبب ليس أن لدى المهندسين عتادًا سيئًا ببساطة، بل يعود إلى مبادئ الحوسبة ذاتها. فالدماغ يعمل بطريقة تناظرية: إذ تتعامل الخلايا العصبية والمشابك مع تدرجات مستمرة وجهود غشائية وتيارات أيونية. ويقوم العنصر البيولوجي الواحد بتخزين الحالة والمشاركة في الحساب في آن واحد. أما في نماذج LLM فالأمر مختلف: البيانات تُمثَّل بالبتات، والحساب منفصل عن الذاكرة، وكل عملية مصفوفية تتفكك إلى سلسلة طويلة من التبديلات الرقمية.
الميزة الثانية للدماغ هي التكرارية والديناميكية الزمنية. فالخلية العصبية نفسها تشارك مرارًا في معالجة الإشارة، ويصبح الزمن جزءًا من الحساب. أما المحوّل (Transformer) فيمرّر كل توكن عبر مجموعة ثابتة من الطبقات، ويدفع ثمن ذلك عددًا ضخمًا من العمليات المتوازية.
الفارق الثالث هو التناثر (sparsity). ففي الدماغ لا ينشط في اللحظة الواحدة سوى جزء ضئيل من الخلايا العصبية، ولذلك لا تهدر المنظومة الطاقة في تشغيل الشبكة بأكملها. أما في نماذج LLM فيجري في كل خطوة استخدام مصفوفات هائلة من الأوزان، حتى لو كانت المهمة بسيطة نسبيًا.
العامل الرابع هو التعلم المحلي. فالنظام البيولوجي يعدّل مشابك بعينها حيث نشأت تجربة جديدة، ولا يمرّر الانتشار العكسي العام للخطأ عبر شبكة عملاقة. والخامس هو فيزياء الركيزة نفسها: فالقنوات الأيونية والعمليات الكيميائية الحيوية تعمل قرب الحد الأدنى الترموديناميكي، بينما تتبدّل حتى أحدث الترانزستورات بهدر أكبر بكثير.
وأخيرًا، يحصل الدماغ على جزء من بنيته مجانًا: فالقشرة البصرية والحُصين والمخيخ وغيرها من الوحدات المتخصصة جاءته نتيجة للتطور، في حين تضطر نماذج LLM إلى تعلّم بنية العالم من جديد عبر مجموعات بيانات ضخمة وتدريب باهظ التكلفة.
ولا يعني ذلك أن النماذج الكبيرة بلا مستقبل. الأرجح أن بنية المحوّلات الحالية اصطدمت بالثمن الطاقي لراحتها. وتبحث الصناعة بالفعل عن حلول بديلة: التكميم إلى 4–8 بت، والمحوّلات المتناثرة، ومزيج الخبراء (MoE)، والشبكات السائلة والنبضية (spiking). وتحقق بعض هذه المقاربات مكسبًا يتراوح بين 5 و10 أضعاف، لكنه لا يكفي للاقتراب من المستوى البيولوجي. لذلك يتجه الاهتمام أكثر فأكثر نحو العتاد العصبي الشكل.
وهذه الأنظمة موجودة بالفعل: يُنشر SpiNNaker2 كحاسوب فائق متخصص، ويمكن حتى استئجاره عبر السحابة، وتتجه BrainChip Akida إلى الذكاء الاصطناعي على الأطراف (edge AI)، أما SynSense Xylo وInnatera Pulsar فتستهدفان سيناريوهات الميكروواط والاستشعار. ومع ذلك، لا تزال حتى أفضل هذه الحلول متأخرة عن الدماغ بنحو ثلاث رتب من حيث كفاءة الطاقة، وتتطلب حزمة برمجية مختلفة تمامًا.
ويبدو الأفق العملي واقعيًا كذلك. ففي الفترة 2026–2028 يُرجَّح أن تنمو الرقاقات العصبية الشكل في الروبوتات وأجهزة التحكم الصناعية وأجهزة الاستشعار والأنظمة المستقلة، حيث يمثّل زمن الاستجابة واستهلاك الطاقة عاملين حاسمين. أما الإلكترونيات الاستهلاكية، كالهواتف الذكية والساعات، فإن حصلت على معالجات مساعدة من هذا النوع، فسيكون ذلك قرب عام 2030 وما بعده. والعائق الرئيسي هنا ليس تصنيع الرقاقات فحسب، بل البرمجيات أيضًا: فالأدوات المعتادة مثل PyTorch وTensorFlow لا تعمل مع الشبكات النبضية دون تكييف جدي، ولا يوجد حتى الآن معيار تدريب موحد لمثل هذه الأنظمة.
والخلاصة الرئيسية بسيطة: الدماغ اليوم ليس أذكى في مهام معينة فحسب، بل هو آلة حاسبة أكثر اقتصادًا بصورة جذرية. ولذلك فإن القفزة الكبرى التالية في الذكاء الاصطناعي ستأتي على الأرجح لا من نموذج LLM أكبر على عنقود GPU أضخم، بل من تغيير النموذج الحاسوبي الأساسي. أما حتى ذلك الحين، فيبقى GPT-4 وخلفاؤه وسيلة قوية جدًا، لكنها مكلفة طاقيًا، للحصول على سلوك يشبه الذكاء.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.