Playwright وMCP: كيف يتحقق وكيل ذكاء اصطناعي من واجهة المستخدم وقاعدة البيانات دون تأكيدات SQL يدوية
ظهور رسالة نجاح خضراء بعد إتمام الدفع لا يثبت أن الطلب أُنشئ فعلًا. يقترح نمط التحقق الشامل (full-stack) إسناد الجزء الأول والثاني من السيناريو إلى وكيل ذكاء اصطناعي واحد: يمر عبر الواجهة باستخدام Playwright، ثم يتحقق عبر خادم MCP ثانٍ من سجل الطلب في قاعدة البيانات وبنود الطلب وخصم المخزون. يقلّل هذا النهج حجم شيفرة الاختبار، ويُخرج فحوصات SQL اليدوية من اختبارات end-to-end.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News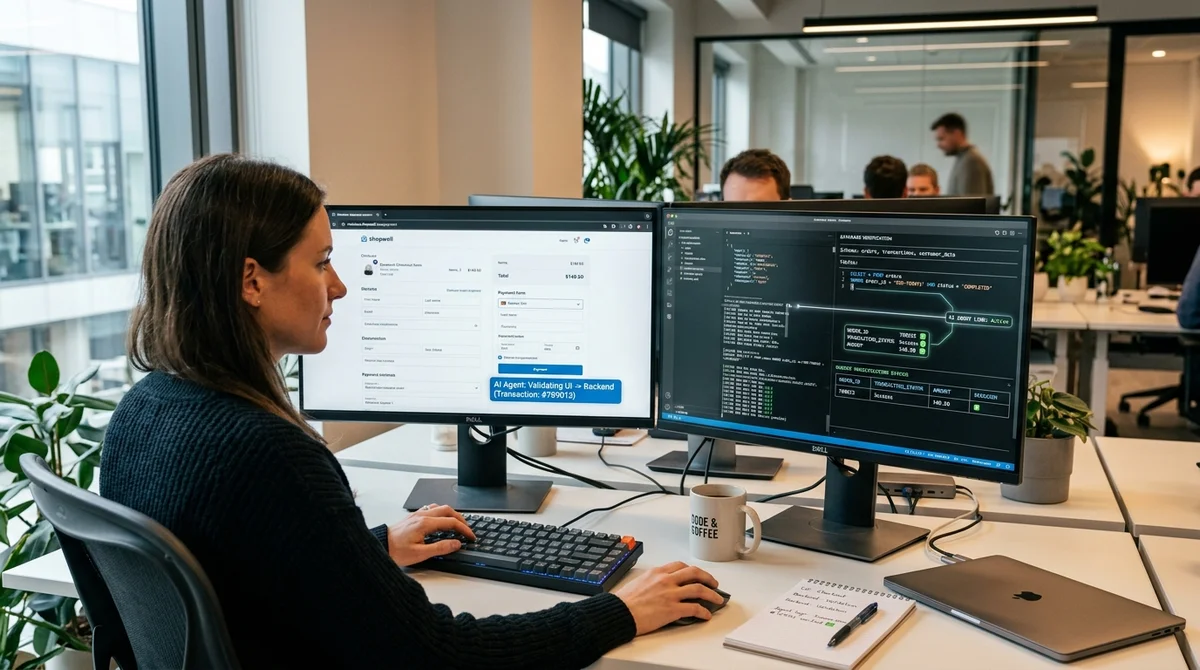
ظهور رسالة نجاح خضراء واحدة بعد الضغط على زر «إتمام الطلب» لا يعني أن الطلب أُنشئ فعلًا. فإذا تراجعت المعاملة (rollback)، وفقدت قائمة الانتظار رسالة، وظلت الواجهة مع ذلك تعرض «تمّ بنجاح»، فإن اختبار end-to-end سيمنح إحساسًا زائفًا بالموثوقية. لهذا يتجه عدد متزايد من الفرق إلى التحقق الشامل (full-stack)، الذي لا يفحص الواجهة وحدها، بل الحالة الفعلية للبيانات في قاعدة البيانات أيضًا.
في النهج التقليدي، تحتاج بنية الاختبار إلى وصول مباشر إلى قاعدة البيانات عبر ORM أو عبر برنامج تشغيل منخفض المستوى. ومن هنا تبدأ التكاليف الإضافية: بيانات اعتماد منفصلة، وإعداد الاتصالات، وتأكيدات SQL يدوية، وصيانة الاستعلامات عند كل تغيير في المخطط. من الناحية الشكلية يحل هذا المشكلة، لكن الكلفة ترتفع مع زيادة عدد السيناريوهات. وكل اختبار end-to-end جديد لا يعود مجرد فحص لسلوك المستخدم، بل يتحول إلى مشروع صغير لصيانة شيفرة الاختبار.
تستعرض المقالة نمطًا أخف: وكيل ذكاء اصطناعي واحد يعمل بالتتابع مع خادمي MCP. في البداية ينفّذ السيناريو في المتصفح عبر Playwright كأي مستخدم عادي: يملأ السلة، ويمر بمرحلة الدفع، ويضغط زر التأكيد، ويسجّل المؤشرات الرئيسية للنتيجة. بعد ذلك ينتقل الوكيل نفسه إلى خادم قادر على قراءة بنية قاعدة البيانات والإجابة عن استعلامات التحقق، دون أن يضطر المختبِر إلى كتابة SQL يدويًا.
وعمليًا، يكفي أن يصوغ الوكيل ما يجب تأكيده: هل يوجد سجل للطلب، وهل تتطابق بنود الطلب، وهل خُصم مخزون المنتج، وهل تغيّرت حالة الدفع. يسدّ هذا النهج الفجوة الرئيسية بين «الواجهة أظهرت النجاح» و«العملية التجارية اكتملت فعلًا». ويستطيع الوكيل مطابقة البيانات الظاهرة في الواجهة مع السجلات في الجداول، وفحص الآثار الجانبية، بل ومراعاة عدم التزامن إذا كان النظام لا يكتب في قاعدة البيانات فورًا.
تزداد أهمية ذلك للفرق المسؤولة عن المنتجات في السيناريوهات التي يطلق فيها زر واحد سلسلة من الإجراءات: إنشاء الطلب، وحجز المخزون، والتسجيل في نظام الخدمات اللوجستية، وتحديث حالة العميل. وفي هذه المواضع تحديدًا تنشأ في الغالب الأخطاء المكلفة التي لا يلتقطها اختبار الواجهة العادي.
تكمن القيمة العملية للنمط في أنه يخفض عتبة الدخول إلى الاختبار الشامل. فلا يحتاج الفريق إلى إدخال ORM في الاختبارات من أجل بضعة فحوصات فقط، ولا إلى تكرار معرفته بمخطط قاعدة البيانات داخل شيفرة التأكيدات. وبدلًا من ذلك تظهر طبقة تحقق موحدة على مستوى النوايا: «بعد إتمام الطلب يجب أن يظهر سجل»، «يجب أن يتطابق عدد البنود»، «يجب أن ينقص مخزون المستودع بوحدة واحدة». وإذا تغيّر المخطط، تنتقل الصيانة إلى خادم MCP أو إلى وصف الوصول إلى البيانات، بدل أن تتوزع على عشرات الاختبارات. والنتيجة اختبارات أقصر وأوضح وأقرب إلى لغة الأعمال.
ومع ذلك، لا يلغي هذا السيناريو الانضباط الهندسي الأساسي. فلا يجوز الاعتماد على وكيل الذكاء الاصطناعي وحده: ما زالت اختبارات الوحدة (unit) واختبارات التكامل (integration) ضرورية لتحديد مكان الأخطاء بسرعة على مستوى الدوال والخدمات والعقود. ويجب أن يكون وصول الوكيل إلى قاعدة البيانات محدودًا، ويفضّل أن يكون للقراءة فقط (read-only) وفي بيئة الاختبار حصرًا. كما تلزم إجراءات لضمان القابلية للتنبؤ: بيانات اختبار مستقرة، وقواعد انتقاء واضحة، وحماية تمنع الوكيل من فحص طلب خاطئ عن طريق الخطأ في قاعدة بيانات مشتركة. وإلا فسرعان ما تتحول الأداة المريحة إلى مصدر لإخفاقات مشوِّشة يصعب إعادة إنتاجها.
والخلاصة الرئيسية بسيطة: الخطوة التالية في تطور اختبارات end-to-end هي الانتقال من فحص الشاشات إلى فحص العواقب الفعلية لإجراء المستخدم. ويجعل الجمع بين Playwright وMCP هذا الانتقال أقل كلفة بكثير، لأنه يزيل SQL اليدوي من العمل اليومي للمختبِر، ويتيح لأتمتة واحدة أن تقطع الطريق من النقر على الزر حتى واقعة الكتابة في قاعدة البيانات. وبالنسبة إلى الفرق التي تختبر المدفوعات والطلبات والحجوزات وغيرها من المعاملات الحرجة، فهذه ليست مجرد تقنية مريحة، بل وسيلة لتقليل عدد الاختبارات ذات الإيجابيات الكاذبة (false positives) واكتشاف الأخطاء التي كانت تتسرب سابقًا إلى بيئة الإنتاج في وقت أبكر.
Delegate Deep Research, Coding & Multi-Step Workflows to Nomad Agent
Deploy autonomous task execution with Nomad Agent (agent.nomadnet.ai) — automated web research, data synthesis, code generation, and MCP tool orchestration.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.