Wildberries & Russ تحدد مستوى نضج البيانات اللازم لوكلاء ذكاء اصطناعي دقيقين
اقترحت Wildberries & Russ نموذجًا لنضج وصف البيانات يمتد من Rare إلى Well-Done، وبيّنت أنه من دون بيانات وصفية جيدة يبدأ وكلاء الذكاء الاصطناعي بالهلوسة حتى في مهام SQL البسيطة. يتطلب المستوى الأساسي مالكًا للبيانات ونموذجًا فيزيائيًا ووسوم سرية، ويتطلب المستوى المتوسط قاموسًا للمصطلحات وطبقة منطقية، أما المستوى المستهدف فيتطلب طبقة دلالية متكاملة لتحويل النص إلى SQL (text-to-SQL) وحساب مؤشرات الأعمال بدقة.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News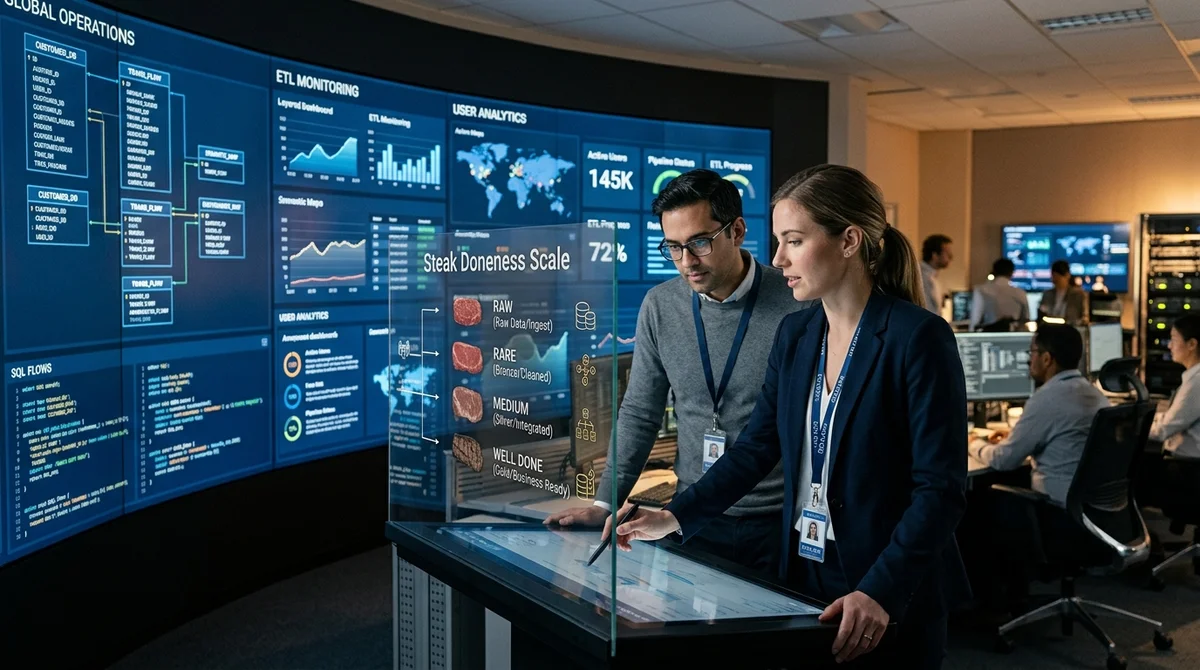
تقترح Wildberries & Russ النظر إلى جودة وصف البيانات بالبراغماتية نفسها التي ننظر بها إلى درجة نضج شريحة الستيك: من Rare إلى Well-Done. والفكرة بسيطة: كلما أحسنت الشركة وصف جداولها وحقولها ومصطلحاتها التجارية ومؤشراتها، قلّت هلوسة وكلاء الذكاء الاصطناعي واقتربوا من رؤى أعمال حقيقية بدلًا من إجابات تبدو معقولة لكنها عديمة الفائدة. وترى الشركة أن المشكلة الرئيسية في البيانات الضخمة اليوم ليست نقص النماذج، بل ضعف مواكبة البيانات نفسها بالوصف والتوثيق.
ففي المؤسسات الكبيرة، تظهر جداول جديدة أسرع مما تستطيع الفرق وصفها يدويًا. ونتيجة لذلك، يقضي المحللون وقتًا في البحث عن المصادر المناسبة، وتبدأ المؤشرات بالتباين بين التقارير، ويتحول الوصول إلى مجموعات بيانات غير موسومة إلى خطر أمني. ويبدو ذلك أشد حدة حيث توجد بيانات شخصية ومتطلبات صارمة للتحكم في الوصول. وفي بيئة كهذه، لم يعد النهج اليدوي قابلًا للتوسع.
يُعدّ المستوى الأول من النضج، Rare، في هذا النموذج الحد الأدنى الكافي للعمل الآمن مع البيانات. ويجب أن يكون لكل مجموعة بيانات على هذا المستوى مالك ونموذج فيزيائي ووسم للسرية. ويمكن استخراج النموذج الفيزيائي تلقائيًا من الجداول النظامية وكتالوجات البيانات. وإذا كانت أوصاف الحقول فارغة، فقد يحاول الذكاء الاصطناعي استعادتها اعتمادًا على اصطلاحات التسمية (naming convention) وقواعد المعرفة المؤسسية. أما مع المالكين فتعمل الأتمتة بصورة أضعف: يمكن للنموذج اقتراح مرشح، لكن المسؤولية تُسنَد في جميع الأحوال يدويًا. في المقابل، يبدو وسم البيانات الحساسة من أولى المهام العملية لنماذج LLM: إذ يستطيع النموذج تحليل أسماء الجداول والأعمدة والمصطلحات التجارية ووضع وسوم الأمان قبل إجراء فحص معمّق للمحتوى.
على مستوى Medium، ينتقل التركيز من البنية التقنية إلى المعنى التجاري. وهنا يظهر قاموس المصطلحات والطبقة المنطقية، وهي طبقة تترجم لغة الجداول والأعمدة إلى كيانات وسمات مفهومة للأعمال. وتخفي هذه الطبقة البادئات الخدمية وعمليات الربط (join) المعقدة وتفاصيل التخزين، بينما يستطيع أمناء البيانات (data stewards) استخدام الذكاء الاصطناعي كطيّار مساعد لربط الحقول بالمصطلحات القائمة وللعثور على الثغرات في الأوصاف.
وإذا كان الوكيل متصلًا بكتالوج البيانات الوصفية عبر MCP، فبإمكانه عند الطلب جلب المخططات اللازمة ومطابقتها مع القاموس وتسريع عمل كان يستغرق سابقًا ساعات. كما تقترح Wildberries & Russ استخراج العلاقات لا من بنية المستودع فحسب، بل أيضًا من سجلات استعلامات SQL: فمن خلالها يمكن معرفة الجداول التي يربطها المحللون في أغلب الأحيان، وأي عوامل التصفية يستخدمونها، وكيف تُستهلك البيانات فعليًا.
أما المستوى الأعلى، Well-Done، فلا يُطلب لمجرد التنقل بين البيانات، بل للعمل الكامل لأنظمة text-to-SQL والأنظمة الوكيلية. وتُبنى هنا فوق الوصف الفيزيائي والمنطقي طبقة دلالية: حقائق ومؤشرات وأبعاد وعلاقات وعوامل تصفية واستعلامات موثّقة بلغة طبيعية مع إجابات SQL جاهزة. وهذه الطبقة تحديدًا هي التي تشرح للنموذج ما تقصده الشركة بـ«العميل النشط» أو «الإيرادات الإجمالية» أو أي مؤشر آخر، بدلًا من إجباره على تخمين المعنى من أسماء الحقول.
ويورد المقال مثالًا دالًّا: إذا سألنا الذكاء الاصطناعي عن عدد العملاء النشطين في مارس، فقد يكتفي النموذج الذي يفتقر إلى الدلالات بعدّ الصفوف ذات الحالة active، بينما يُعدّ العميل نشطًا وفق قواعد الشركة إذا أجرى طلبًا واحدًا على الأقل يتجاوز حدًّا معينًا. ويرى كاتب المقال أن المعايير المفتوحة، مثل OSI، تصبح هنا بالغة الأهمية، لأنها تتيح وصف معنى البيانات بصيغة قابلة للنقل ومتوافقة مع أدوات الطبقة الدلالية الحديثة. كما يشير المقال إلى أثر عملي: ففي مواد Snowflake الخاصة بـ Cortex Analyst يُذكر ارتفاع في الدقة بنحو 20 بالمئة عند العمل عبر دلالات موصوفة بشكل صحيح، بينما يبلغ المستوى المستهدف للسيناريوهات الواقعية أكثر من 90 بالمئة من دقة SQL.
ما معنى ذلك عمليًا؟ يبتعد السوق تدريجيًا عن فكرة أن مجرد ربط LLM بقاعدة البيانات كافٍ لانتظار نتائج سحرية. ويعرض نهج Wildberries & Russ مسارًا أكثر رصانة: أولًا ترتيب شؤون المالكين وبنية البيانات وتصنيفها، ثم بناء قاموس منطقي، ولا يأتي بناء الطبقة الدلالية للوكلاء إلا بعد ذلك. وبالنسبة إلى الشركات التي ترغب في إدخال مساعدي الذكاء الاصطناعي إلى التحليلات، فهذه حقيقة غير مريحة لكنها مفيدة: إذ لم تعد جودة إجابة النموذج تعتمد على النموذج وحده، بل أيضًا على نضج وصف البيانات داخل الأعمال.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.