لماذا تفشل LoRA في بيئة الإنتاج وكيف تنقذ RS-LoRA عملية الضبط الدقيق للنماذج
تؤدي LoRA أداءً جيدًا حين يحتاج النموذج إلى تغيير النبرة أو الصيغة أو الشخصية، لكنها أضعف حين يلزم إدخال حقائق جديدة فيه. تكمن المشكلة في أن الرتبة المنخفضة تقتطع الإشارة عالية الأبعاد، وأن رفع الرتبة ببساطة يُضعف التعلّم. تقترح RS-LoRA تعديلًا بسيطًا: استخدام alpha/√r بدلًا من alpha/r للحفاظ على الاستقرار عند الرتب الكبيرة.
معالج بواسطة الذكاء الاصطناعي من MarkTechPost؛ بتحرير Hamidun News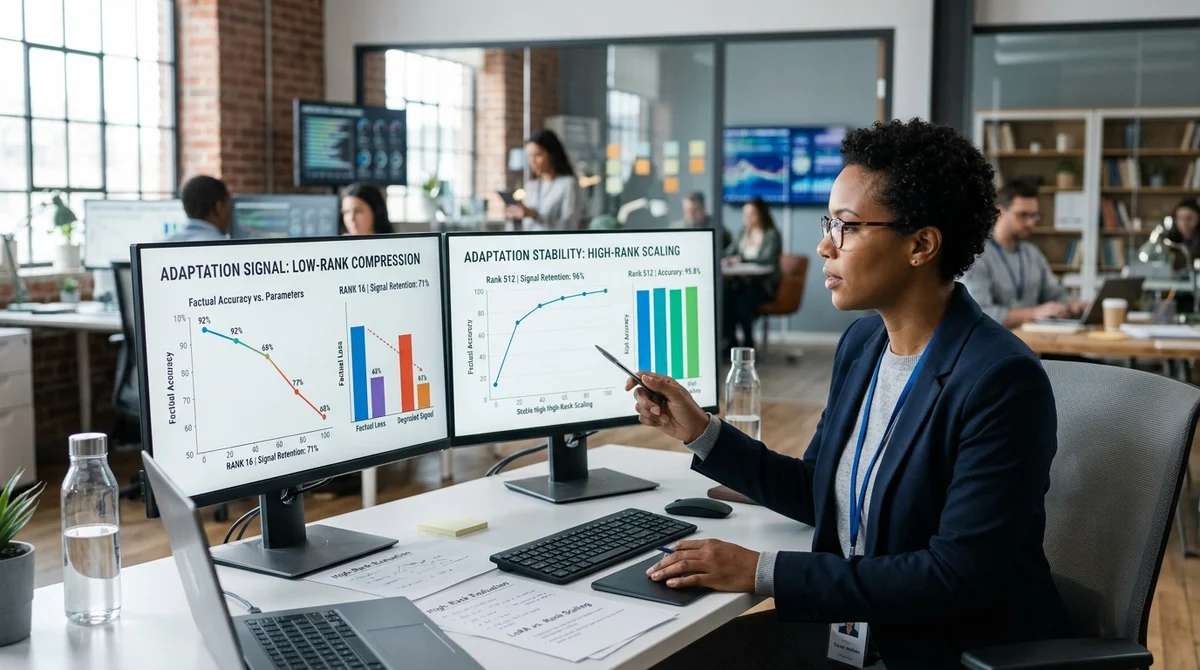
أصبحت LoRA منذ زمن معيارًا للضبط الدقيق الرخيص للنماذج الكبيرة، لكنها تنطوي في بيئة الإنتاج على افتراض خفي: أن جميع تحديثات الأوزان متشابهة في بنيتها. عمليًا ليس الأمر كذلك. فالتغييرات المسؤولة عن الأسلوب مضغوطة فعلًا، أما التحديثات التي تضيف حقائق جديدة وخبرة في مجال معيّن فتتوزع على أبعاد كثيرة، وهنا تحديدًا تبدأ LoRA التقليدية بفقدان البيانات.
شعبية LoRA مفهومة: فهي تتيح ضبط النموذج دقيقًا دون إعادة حساب جميع معاملاته، عبر مصفوفات صغيرة منخفضة الرتبة. وينجح ذلك جيدًا حين يراد تغيير النبرة أو صيغة الإجابة أو الشخصية أو العادات اللغوية للمساعد. يوضح المقال ذلك على مصفوفة أوزان مبسطة بحجم 64×64: في تحديث الأسلوب تهيمن بضع قيم منفردة بوضوح، ولذلك فإن تقريبًا بالرتبة 4 أو 8 يحتفظ بالإشارة كاملة تقريبًا. وفي محاكاتهم، تكفي الرتبة 4 لتغطية أكثر من 99% من التباين المفيد. لذلك يتعلم روبوت الدردشة بسهولة أسلوب تواصل جديدًا أو قالب إجابة أو طريقة مطلوبة دون إعادة تدريب ثقيلة للنموذج بأكمله.
تبدأ المشكلات حين يكون المطلوب تعليم المضمون لا الشكل: حقائق طبية، أو كتالوجات منتجات، أو لوائح داخلية، أو إحصاءات، أو قواعد قطاعية. تتصرف هذه التحديثات كتحديثات عالية الرتبة: المعلومات موزعة على اتجاهات كثيرة ولا تتجمع في بضعة مكونات مهيمنة. وفي تجربة المقال، تحتفظ الرتبة 8 بنحو 28% فقط من الإشارة الواقعية. ومن هنا ينشأ تأثير مألوف في الإنتاج: يبدو النموذج واثقًا، ويستخدم المصطلحات الصحيحة والبنية العامة للإجابة، لكنه يخلط الأرقام أو يُغفل التفاصيل أو يقدّم استنتاجًا ناقصًا. وبالنسبة للمساعدات المؤسسية والتحليلات والدعم الفني والسيناريوهات القائمة على المعرفة، لم يعد هذا خطأً شكليًا، بل خطرًا على الجودة.
يظهر الفرق الجوهري بوضوح في طيف القيم المنفردة. ففي مهام الأسلوب يوجد «مرفق» واضح: بعد عدد قليل من المكونات لا تضيف الأبعاد الإضافية شيئًا يُذكر. أما في الحقائق فيوجد ذيل طويل، تضيف فيه كل مكوّن تالٍ جزءًا من المعرفة المفيدة. وحين تقتطع LoRA هذا التحديث قسرًا إلى رتبة منخفضة، فإنها تقطع هذا الذيل بالذات. وقد يبدو النظام من الخارج محسّنًا، لأن الصيغة والنبرة والبنية أصبحت أنظف، لكن الدقة الواقعية ترتفع بدرجة أضعف بكثير مما توحي به الاختبارات السطحية. وهذا يفسّر لماذا لا تضمن العروض التجريبية ذات الإجابات الجميلة والأسلوب الجيد سلوكًا موثوقًا على بيانات العمل الفعلية.
ردّ الفعل المنطقي للمهندس هو رفع الرتبة ببساطة. لكن في LoRA القياسية مشكلة خفية ثانية: معامل القياس alpha/r. فكلما ارتفعت الرتبة انكمش المعامل وضعفت إشارة التعلّم. في المثال مع alpha = 16 ينخفض المقياس من 16 عند الرتبة 1 إلى 0,25 عند الرتبة 64. وينشأ تناقض: تضيف إلى النموذج سعة ليتمكن من تمثيل تحديث أعقد، وفي الوقت نفسه تقلّل التأثير الفعلي لهذا التحديث في الأوزان. ويضطر المُحسِّن إلى التعويض بخطوات أكثر عدوانية، فيتراجع التقارب أو يصبح التدريب غير مستقر. لذلك فإن نصيحة رفع الرتبة في الإنتاج كثيرًا ما لا تحل المشكلة، بل تُخفيها أحيانًا فقط.
تقترح RS-LoRA تعديلًا بسيطًا لكنه مهم: استخدام alpha/√r بدلًا من alpha/r. من الناحية الشكلية هو استبدال رمز واحد تقريبًا، لكن أثره عمليًا كبير. فعند الرتبة 64 يبقى المقياس 2,0 بدلًا من 0,25، وبذلك تحافظ التهيئة عالية الرتبة على قيمة ذات معنى ولا تُضعف الإشارة. يعرض المقال ذلك دون حلقات تدريب ثقيلة أو أطر عمل، وإنما عبر NumPy وتحليل SVD ومقارنة أخطاء إعادة البناء فقط. وهذا يجعل الحجة واضحة بوجه خاص: فمهام الأسلوب منخفضة الرتبة ما زالت تُحل جيدًا بـ LoRA التقليدية، أما مهام إضافة المعرفة فتتطلب إما RS-LoRA وإما استراتيجية تكييف مختلفة من الأساس.
الخلاصة للفرق التي تطلق نماذج LLM مضبوطة دقيقًا في بيئة الإنتاج مباشرة إلى حد كبير: ينبغي اختيار إعدادات المهايئ (adapter) لا بحسب الميزانية والسرعة فحسب، بل بحسب نوع التحديث أيضًا. إذا كنت تغيّر النبرة أو الشخصية أو صيغة الإجابة، فإن LoRA القياسية منخفضة الرتبة تكفي عادةً. أما إذا كنت تُدخل حقائق جديدة أو بيانات مرجعية أو قواعد أو خبرة في مجال معيّن، فقد تخلق الرتبة المنخفضة وهمًا بنجاح التدريب بينما تفقد بصمت جزءًا كبيرًا من المعلومات. وفي مثل هذه الحالات لا تبدو RS-LoRA تحسينًا طفيفًا، بل شرطًا لموثوقية النموذج في التشغيل الفعلي.
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.