Databricks وInfosys: لماذا تُبطئ البيانات اعتماد الذكاء الاصطناعي؟
تبيّن أن العائق الرئيسي أمام الذكاء الاصطناعي في المؤسسات أقل إثارة من النماذج نفسها: إنه البيانات. فالشركات تريد الانتقال من روبوتات الدردشة إلى أتمتة العمليات ووكلاء الذكاء الاصطناعي، لكنها تحتاج لذلك إلى مخازن بيانات موحّدة، وصلاحيات وصول واضحة، وتتبّع لمصدر البيانات، وربط بين الأنظمة التحليلية والمعاملاتية. من دون هذه القاعدة تبدو التجارب التجريبية مبهرة، لكن التوسع بها يصطدم سريعًا بالفوضى والمخاطر.
معالج بواسطة الذكاء الاصطناعي من MIT Technology Review؛ بتحرير Hamidun News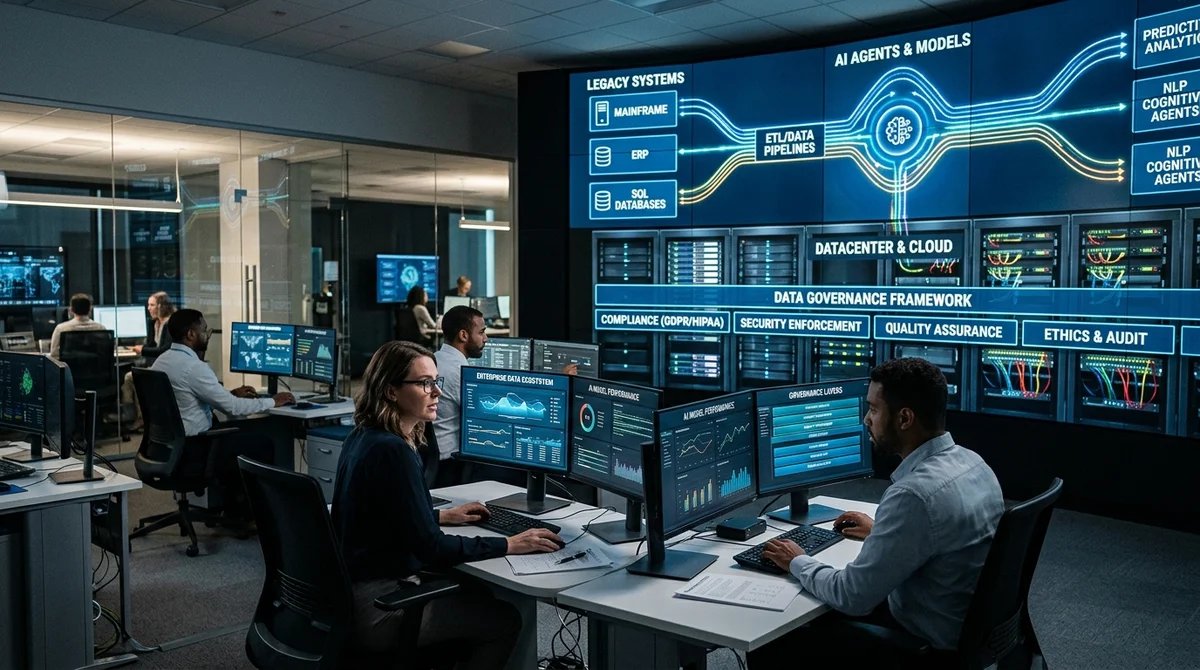
تناقش الشركات الذكاء الاصطناعي بنشاط متزايد على مستوى مجالس الإدارة، لكن إطلاقه فعليًا في الأعمال لا يتعطل في الغالب بسبب النماذج أو القدرات الحاسوبية، بل بسبب حالة بيانات المؤسسة. فالخدمات الاستهلاكية عوّدت السوق على النتائج الفورية، أما داخل المؤسسات الكبيرة فسرعان ما يتضح أمر أكثر واقعية: من دون بنية تحتية للبيانات تكون موحّدة وخاضعة للإدارة وصالحة للتشغيل، يبقى الذكاء الاصطناعي عرضًا تقديميًا جذابًا لا أداة عمل حقيقية.
المشكلة الرئيسية أن بيانات الشركات تتوزع عادةً على طبقات متباينة أكثر مما ينبغي. فجزء منها يقيم في واجهات البيانات التحليلية وبحيرات البيانات، وجزء في الأنظمة المعاملاتية مثل CRM وERP والتطبيقات الداخلية، وجزء آخر مشتّت بين الملفات والبريد الإلكتروني وقواعد المعرفة وتذاكر الدعم والخدمات السحابية. يمكن تحمّل هذا المشهد في إعداد التقارير المعتادة. لكن حين تريد الشركة منح النموذج وصولًا إلى البيانات في الزمن الحقيقي، أو دمج الذكاء الاصطناعي في العمليات، أو تشغيل وكلاء لا يكتفون بالإجابة عن الأسئلة بل ينفّذون إجراءات، يتحول التشتت إلى قيد مباشر. فقد يكون النموذج قويًا، لكن إذا لم يرَ السياق الحالي، ولم يفهم مصدر البيانات، ولم يعمل ضمن صلاحيات وصول محددة بدقة، فإن النتيجة تكون غير مستقرة ومحفوفة بالمخاطر.
ولهذا ينتقل الحديث عن الذكاء الاصطناعي في المؤسسات تدريجيًا من النماذج إلى البنية المعمارية. إحدى الأطروحات الأساسية أن المؤسسات لا تحتاج إلى مجموعة أدوات ذكاء اصطناعي متفرقة، بل إلى data stack جديدة تُخزَّن فيها البيانات بصيغ مفتوحة، وتُوصَّف بالبيانات الوصفية، وتتاح عبر سياسات موحّدة، وتصلح في الوقت نفسه للتحليلات وللسيناريوهات التشغيلية. ومن هنا الاهتمام بالمعماريات التي تجمع بين عالمي OLAP وOLTP: فالشركات تحتاج من جهة إلى عمق التحليلات والسجل التاريخي والقدرة على التوسع، ومن جهة أخرى إلى زمن استجابة منخفض ودعم للمعاملات وقدرة على التحرك بسرعة.
وضمن هذا النهج تروّج Databricks لـ Lakebase بوصفها طبقة Postgres بلا خوادم (serverless) لأحمال الذكاء الاصطناعي التشغيلية، ولـ Unity Catalog بوصفه طبقة موحّدة لإدارة الوصول والتتبّع الأصلي للبيانات والحوكمة (governance) للبيانات وأصول الذكاء الاصطناعي. والمغزى ليس في منتجات بعينها، بل في الاتجاه ذاته: تحتاج الأعمال إلى أساس يعمل عليه الذكاء الاصطناعي في بيئة الإنتاج، لا في المرحلة التجريبية وحدها.
وثمة مسألة منفصلة هي كيفية قياس الأثر. ففي المرحلة المبكرة تكتفي الشركات غالبًا بمقاييس لافتة، مثل عدد الطلبات الموجهة إلى روبوت الدردشة أو نسبة الموظفين الذين فتحوا المساعدين الذكيين (copilots). لكن مع نضج التجربة لا يعود ذلك كافيًا.
فإذا كان الذكاء الاصطناعي مطالبًا بأتمتة العمليات، وتقصير دورة التنفيذ، ورفع معدل التحويل، أو خلق مصادر إيرادات جديدة، فلا بد من تقييمه بوصفه نظام أعمال متكاملًا. لذلك يظهر في النقاش حول data stack الجديدة موضوع قياس القيمة أيضًا: ينبغي ربط أثر الذكاء الاصطناعي بنتائج محددة للأعمال لا بتأثير الإبهار. ويكتسب ذلك أهمية خاصة مع الانتقال إلى الذكاء الاصطناعي القائم على الوكلاء، حيث يحصل النموذج على قدر أكبر من الاستقلالية، وبالتالي تصبح متطلبات قابلية المراقبة وتسجيل الأحداث وجودة البيانات وسياسة الوصول أكثر صرامة بكثير.
يبدو تطور الذكاء الاصطناعي في المؤسسات هنا واضحًا إلى حد كبير. تبدأ الشركات بإدخال أدوات إنتاجية فردية: مساعدين للبحث والتلخيص وكتابة الشيفرة أو إعداد المستندات. ثم تنتقل إلى أتمتة العمليات: معالجة الطلبات، وتوجيه المهام، والدعم الداخلي، والسيناريوهات المالية والتشغيلية. وبعد ذلك فقط تُفتح المرحلة الثالثة: إطلاق منتجات وخطوط أعمال جديدة تُبنى منذ البداية حول الذكاء الاصطناعي. وفي كل مرحلة لاحقة ترتفع متطلبات البيانات. فما كان كافيًا للمساعد الذكي الشخصي (copilot) لا يعود كافيًا لعملية تتطلب الدقة وسجلًا كاملًا للإجراءات وإمكانية تنفيذ العمليات بأمان نيابةً عن الشركة.
ومن هنا الاستنتاج الرئيسي: المعركة المقبلة على الذكاء الاصطناعي في المؤسسات لا تدور حول أفضل واجهة للنموذج، بل حول إعادة بناء البيانات لتناسب الاستخدام الآلي. ولن يفوز من يربط أسرع من غيره روبوت دردشة جديدًا، بل من ينجح في جعل بياناته موحّدة وخاضعة للإدارة ومتوافقة مع سيناريوهات الوكلاء. وهذا يعني للأعمال حقيقة غير مريحة لكنها مفيدة: الطريق إلى الذكاء الاصطناعي على نطاق واسع لا يبدأ باختيار النموذج، بل بإعادة تجميع data stack.
- 29 أكتوبر 2026OvisOCR3: نموذج بـ 0.8 مليار معامل يقرأ الوثائق أفضل من الأنظمة المتخصصة
- 28 أكتوبر 2026Liquid AI تطلق LFM2.5-24B-A2B: وكيل ذكي بمعاملات نشطة لا تتجاوز 2B
- 28 أكتوبر 2026Apertus 1.5 السويسري يكتسب الرؤية والسمع وسياقًا بطول 262 ألف رمز
- 28 أكتوبر 2026AWS تطلق Multi-Turn RL في SageMaker: gpt-oss-20b يرتفع من 15 إلى 69% بتكلفة $339
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.