مؤلف يُحيي لوحة من القرن التاسع عشر طبقةً بعد طبقة: مقابل كل مقطع صالح 4–5 مقاطع فاشلة
إذا سلّمتَ نموذج الفيديو اللوحة كاملة، أعاد رسم الوجوه والبزّات العسكرية والجسر. لذلك فكّك المؤلف لوحة ألما-تاديما عن عبور نهر بيريزينا إلى طبقات في Photoshop، وحرّك الشخصيات واحدةً تلو الأخرى في MiniMax H3، ثم جمع المشهد في After Effects. وثمن هذا التحكم هو الوقت: فمقابل كل مقطع صالح كان يُهدر 4–5 مقاطع فاشلة. وفي المشاهد المعقدة، الأجدى تقسيم المهمة والتحقق من كل جزء على حدة.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News
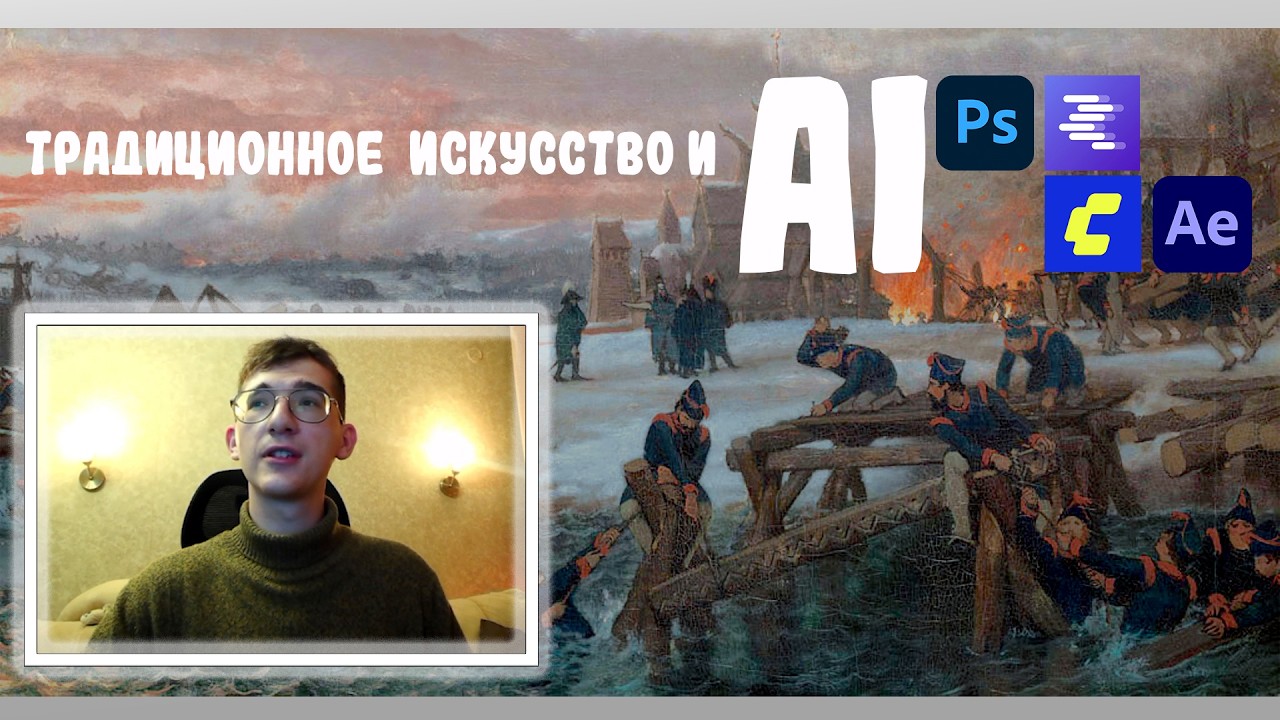
تعلّمت مولّدات الفيديو تحريك الصورة بأسلوب جميل، لكن ما إن تُعطيها مشهدًا معقدًا فيه عشرات الأشخاص حتى تبدأ باختلاق تفاصيل من عندها: تغيّر الوجوه والبزّات العسكرية والعمارة، بل وحتى عدد الأيدي. تخيّل أنك تطلب من النموذج إحياء لوحة تاريخية، فيظهر على الجندي بدل المعطف لباس آخر، ويُبنى الجسر في اتجاه مغاير. تجاوز كاتب Habr دميتري (قناة Dmitrii DAK) هذه المشكلة على مثال لوحة لورنس ألما-تاديما «Anno 1812.
Kapitein Benthien aan de Beresina»، التي تصوّر مهندسي الجسور العائمة الهولنديين وهم يبنون معبرًا عبر نهر بيريزينا أثناء انسحاب جيش نابليون. وبدل طلب واحد من نوع «أحيِ كل شيء»، قسّم العمل إلى أجزاء صغيرة يسهل التحكم بها. وثمن هذا التحكم هو الوقت: فبحسب ملاحظته، يقابل كل مقطع صالح 4–5 توليدات فاشلة أو «شبه ناجحة».
هذه تجربة عملية واحدة وليست إحصائية عامة، لكنها تُظهر بوضوح أين يذهب الجهد فعلًا.
الطبقات أولًا، ثم الحركة
تجري المرحلة الأولى في Photoshop. يحدّد المؤلف الشخصيات والعناصر وينقل كلًّا منها إلى طبقة مستقلة، ثم يجمع الطبقات حسب المعنى: الماء، والناس، والمنشآت. والقاعدة الأساسية أن تبقى الأجزاء في نظام إحداثيات اللوحة الأصلي، أي دون قصّها إلى أصغر مستطيل ممكن. عندها تتراكب الطبقات في After Effects دون ضبط يدوي للمقياس والموضع.
ثم تظهر مشكلة الفجوات. فإذا أُزيل أحد الجنود، يجب أن يظهر خلفه ألواح خشبية وكتف شخص آخر وثلج. تُملأ هذه المواضع بتقنية inpainting (إكمال الخلفية بالشبكة العصبية) بحيث يتطابق اللون والإضاءة واتجاه ضربات الفرشاة والمنظور. وفي الصورة الثابتة قد لا يُلاحَظ الدرز، أما في الحركة فتبدو الخلفية «عائمة» بالنسبة إلى الشخصية، لذلك يفحص المؤلف الوصلات بعناية خاصة.
وخطوة منفصلة تخصّ الوجوه. فكثير من الشخصيات في اللوحة صغيرة، وعند التحريك يفضح الوجه «الضبابي» أن ثمة استبدالًا. تُمرَّر الشخصيات عبر تحسين التفاصيل بشرط ألّا تتغير الوضعية ولا النسب ولا الطابع التصويري للوحة. وفي الوقت نفسه تُستبدل الخلفية خلفها بلون أخضر، ثم تُزال لاحقًا بأداة القطّارة أثناء التركيب، لأن خلفها شخصيات أخرى ستُحرَّك هي أيضًا.
نموذج لغوي محلي يكتب الموجّهات، وMiniMax H3 يحرّك الأجزاء
ولتجنّب كتابة أوصاف طويلة يدويًا، يشغّل المؤلف في LM Studio نموذجًا محليًا متعدد الوسائط هو Qwen 3.8 27B بتكميم Q5_K_XL (نسخة مضغوطة تتسع في ذاكرة الفيديو). يُمرَّر إليه ثلاثة أشياء: وصف أساسي للحركة المطلوبة، والجزء المعني من اللوحة، وقائمة قيود (الملابس، والمظهر، وموضع الجيران، وكاميرا ثابتة). ينظر النموذج إلى الصورة ويُنتج موجّهًا إنجليزيًا مفصّلًا. مثال ذلك: ثمانية جنود بزّات داكنة يسيرون من اليسار إلى اليمين على شاطئ مثلج حاملين جذوعًا، والكاميرا ثابتة، ولقطة متوسطة بعدسة 35 ملم، مع ملمس قماش اللوحة.
يُولَّد الفيديو في ComfyUI بنموذج الفيديو MiniMax H3. وللتسريع يستخدم المؤلف LoRA بـ10 خطوات (إضافة صغيرة تتيح الحساب بوتيرة أسرع)، وSageAttention، وعقدة Spectrum. أُنجزت اللقطة القريبة بدقة 1,8 ميغابكسل (1824×1024)، أما بقية اللقطات فبدقة 0,3 ميغابكسل (736×416).
لا يُقيَّم الناتج بمعيار «جميل أم لا»، بل بمدى صلاحيته للمونتاج:
- هل بقيت الوضعية الأصلية محفوظة؛
- هل بقي عدد العناصر والأطراف كما هو؛
- هل تخترق يدُ أحد الأبطال أو رجله جسدَ بطل آخر؛
- هل تتوافق الحركة مع فيزياء الوسط.
وبحسب هذه المعايير تحديدًا تتراكم تلك المحاولات الفاشلة الأربع أو الخمس مقابل كل محاولة ناجحة. فمشهد الضباط والجذوع اضطُر المؤلف إلى إعادة تركيبه أكثر من 15 مرة: كان أحد الضباط يمرّ عبر جندي يصلح الجسر. أما الأشخاص الغارقون في الماء الجليدي حتى الخصر وهم يدفعون الجذوع ويتشبثون ببعضهم، فتأتي النتائج معهم أسوأ مما هي عليه مع الشخصيات على الشاطئ.
التجميع في After Effects وكلفة التجربة
في After Effects تُرتَّب الطبقات والمقاطع المولَّدة وفق الإحداثيات الأصلية. ولفصل الشخصيات عن الخلفية يُستخدم Roto Brush: يتحقق المؤلف من ثبات القناع ويصحّح الحواف، وينظر بصورة منفصلة إلى الملابس واليدين والقدمين، حيث تكون الأخطاء أوضح ما تكون. وفي النهاية يوازن اللون والإضاءة كي لا تبرز الأجزاء عن الطابع التصويري العام.
جرى العمل على محطة عمل بمعالج Intel Core i9-14900K وبطاقة NVIDIA GeForce RTX 5090 بذاكرة فيديو 32 غيغابايت، وبالكامل محليًا. ويشدّد المؤلف على أن هذه البطاقة ليست إلزامية: إذ يمكن تنفيذ المراحل على عتاد أضعف، أو استخدام نسخ مخففة من النماذج، أو نقل التوليد إلى السحابة. وعندها ستتغير الدقة والسرعة ومجموعة النماذج المتاحة.
ماذا يعني هذا للممارس
تصف المقالة تجربة مؤلف واحد، وليست اختبارًا معياريًا (benchmark) قابلًا للتكرار، وهذا قيدها الرئيسي. لكن الاستنتاج ينطبق على نطاق أوسع. فكلما زاد تعقيد المشهد، كان تقسيمه إلى أجزاء مستقلة، وإشراك الإنسان في فحص كل خطوة، أجدى. وطول المقطع النهائي لا يعكس حجم الجهد المبذول، إذ قد تكلّف بضع ثوانٍ من الرسوم المتحركة عشرات التوليدات وتحسينًا يدويًا. وإذا حُسب الأمر في السحابة، فسيكون ذلك رموزًا (tokens) أو أرصدة، ويُستحسن رصد ميزانية بهامش 4–5 محاولات لكل جزء. وفي المعارض المتحفية والفعاليات والمشاريع التعليمية، يمنح هذا الخط الإنتاجي ما لا يمنحه طلب واحد إلى نموذج الفيديو: الحفاظ على تكوين العمل الأصلي.
- 21 نوفمبر 2026MLCommons تبدأ قياس واجهات الذكاء الاصطناعي تحت حمل حقيقي: 7 قياسات للوكلاء
- 21 نوفمبر 2026Unsloth تحدّث نسخ Qwen3.8-27B المضغوطة: الدقة ارتفعت بنسبة 5–10% عند الحجم نفسه
- 21 نوفمبر 2026Google تفتح الطلب المسبق على نظارات Gemini الذكية بسعر يبدأ من 395 دولارًا — والبيع اعتبارًا من 10 ديسمبر
- 21 نوفمبر 2026عبر OpenRouter ردّت نسخة DeepSeek مخترَقة لثلاثة أيام: انخفضت نسبة الرفض من 83–98% إلى 1%
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول الطبقات أولًا، ثم الحركة؟
تجري المرحلة الأولى في Photoshop. يحدّد المؤلف الشخصيات والعناصر وينقل كلًّا منها إلى طبقة مستقلة، ثم يجمع الطبقات حسب المعنى: الماء، والناس، والمنشآت. والقاعدة الأساسية أن تبقى الأجزاء في نظام إحداثيات اللوحة الأصلي، أي دون قصّها إلى أصغر مستطيل ممكن. عندها تتراكب الطبقات في After Effects دون ضبط يدوي للمقياس والموضع. ثم تظهر مشكلة الفجوات. فإذا أُزيل أحد الجنود، يجب أن يظهر خلفه ألواح خشبية وكتف شخص آخر وثلج.
ما أبرز التفاصيل حول نموذج لغوي محلي يكتب الموجّهات، وMiniMax H3 يحرّك الأجزاء؟
ولتجنّب كتابة أوصاف طويلة يدويًا، يشغّل المؤلف في LM Studio نموذجًا محليًا متعدد الوسائط هو Qwen 3.8 27B بتكميم Q5_K_XL (نسخة مضغوطة تتسع في ذاكرة الفيديو). يُمرَّر إليه ثلاثة أشياء: وصف أساسي للحركة المطلوبة، والجزء المعني من اللوحة، وقائمة قيود (الملابس، والمظهر، وموضع الجيران، وكاميرا ثابتة). ينظر النموذج إلى الصورة ويُنتج موجّهًا إنجليزيًا مفصّلًا. مثال ذلك: ثمانية جنود بزّات داكنة يسيرون من اليسار إلى اليمين على شاطئ مثلج حاملين جذوعًا، والكاميرا ثابتة، ولقطة متوسطة بعدسة 35 ملم، مع ملمس قماش اللوحة.
ما أبرز التفاصيل حول التجميع في After Effects وكلفة التجربة؟
في After Effects تُرتَّب الطبقات والمقاطع المولَّدة وفق الإحداثيات الأصلية. ولفصل الشخصيات عن الخلفية يُستخدم Roto Brush: يتحقق المؤلف من ثبات القناع ويصحّح الحواف، وينظر بصورة منفصلة إلى الملابس واليدين والقدمين، حيث تكون الأخطاء أوضح ما تكون. وفي النهاية يوازن اللون والإضاءة كي لا تبرز الأجزاء عن الطابع التصويري العام. جرى العمل على محطة عمل بمعالج Intel Core i9-14900K وبطاقة NVIDIA GeForce RTX 5090 بذاكرة فيديو 32 غيغابايت، وبالكامل محليًا.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.