ويكيبيديا تفتح محتواها لشركات الذكاء الاصطناعي عبر اتفاقيات ترخيص
أبرمت Wikimedia Enterprise اتفاقيات ترخيص مع كبرى شركات الذكاء الاصطناعي، من بينها Microsoft وMeta وAmazon. وبموجبها ستتمكن هذه الشركات من استخدام محتوى ويكيبيديا في تدريب نماذجها، في خطوة تمثّل مرحلة جديدة في تطور الذكاء الاصطناعي وفي تحقيق عائد مالي من المعرفة. *أُدرجت Meta في روسيا ضمن المنظمات المتطرفة وهي محظورة فيها.
معالج بواسطة الذكاء الاصطناعي من Ars Technica؛ بتحرير Hamidun News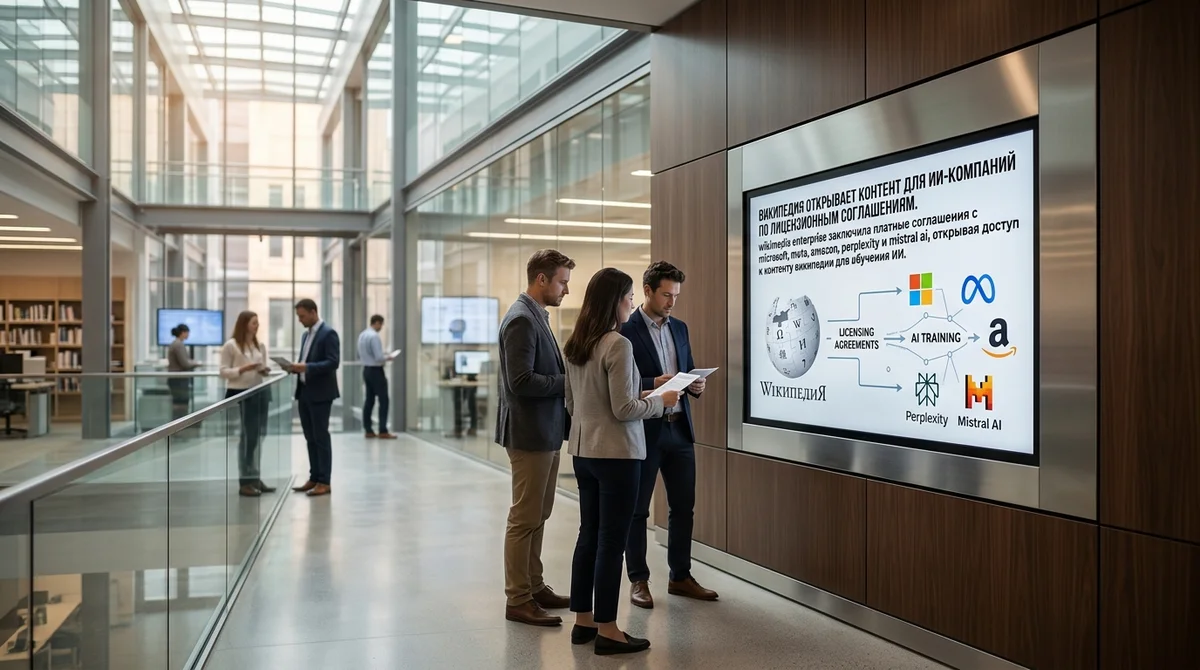
تفتح ويكيبيديا، إحدى أكبر مصادر المعرفة في العالم، أبوابها أمام الذكاء الاصطناعي. فقد أبرمت Wikimedia Enterprise، الذراع التجارية لمؤسسة Wikimedia، سلسلة من اتفاقيات الترخيص مع عمالقة التقنية، مثل Microsoft وMeta وAmazon، إضافة إلى شركتين ناشئتين واعدتين هما Perplexity AI وMistral AI. وتمنح هذه الاتفاقيات شركات الذكاء الاصطناعي إمكانية الوصول إلى مجموعة ضخمة من بيانات ويكيبيديا لتدريب نماذجها وتحسينها.
ظلّت ويكيبيديا طوال سنوات مورداً مجانياً ومفتوحاً متاحاً للجميع. لكن مع تزايد شعبية النماذج اللغوية الكبيرة (LLM)، ارتفع الطلب على البيانات عالية الجودة لتدريبها ارتفاعاً حاداً. ورأت Wikimedia Enterprise في ذلك فرصة لتحقيق عائد من محتواها دون المساس بمبادئ الانفتاح وإتاحة المعرفة التي تقوم عليها ويكيبيديا. وتوفّر التراخيص المدفوعة للشركات وصولاً منظماً ومحسّناً إلى البيانات، إضافة إلى دعم تقني، ما يبسّط إلى حد كبير عملية تدريب نماذج الذكاء الاصطناعي.
فماذا يعني ذلك لصناعة الذكاء الاصطناعي؟ أولاً، يتيح هذا التوجه الوصول إلى كمّ هائل من المعلومات الموثّقة والمنظمة، وهو أمر بالغ الأهمية لتدريب نماذج LLM عالية الجودة وموثوقة. فتضم ويكيبيديا ملايين المقالات بلغات متعددة، تغطي طيفاً واسعاً من الموضوعات، من التاريخ والعلوم إلى الثقافة والتقنيات. ومن شأن استخدام هذه البيانات أن يساعد نماذج الذكاء الاصطناعي على فهم العالم بصورة أفضل وتقديم إجابات أكثر صلة ودقة. ثانياً، توفّر اتفاقيات الترخيص مصدر تمويل مستداماً لمؤسسة Wikimedia Foundation، ما يتيح للمنظمة مواصلة دعم ويكيبيديا وتطويرها بوصفها مورداً معرفياً عالمياً.
غير أن لهذه الخطوة مخاطر محتملة. فمن المهم أن يتوافق استخدام محتوى ويكيبيديا مع مبدأي الحياد والموضوعية اللذين تقوم عليهما الموسوعة. ويجب منع حالات تنشر فيها نماذج الذكاء الاصطناعي المدرَّبة على بيانات ويكيبيديا معلومات مضللة أو آراء متحيزة. وعلى Wikimedia Foundation أن تراقب استخدام محتواها بدقة وأن تستجيب سريعاً لأي انتهاكات. كما يتعين ضمان الشفافية بشأن بيانات ويكيبيديا المستخدمة في تدريب كل نموذج من نماذج الذكاء الاصطناعي.
يمثّل إبرام اتفاقيات الترخيص مع شركات الذكاء الاصطناعي خطوة مهمة لويكيبيديا ولصناعة الذكاء الاصطناعي بأكملها. فهي تفتح فرصاً جديدة لتطوير الذكاء الاصطناعي، لكنها تتطلب نهجاً مسؤولاً والتزاماً بمبادئ الانفتاح والحياد. وفي المستقبل، من المرجح أن نشهد مصادر بيانات كبرى أخرى تحذو حذو ويكيبيديا وتبدأ في تحقيق عائد من محتواها عبر تدريب الذكاء الاصطناعي. وقد يؤدي ذلك إلى نشوء سوق جديدة لبيانات الذكاء الاصطناعي، ما سيترك بدوره أثراً كبيراً في تطور تقنيات الذكاء الاصطناعي.
*أُدرجت Meta في روسيا ضمن المنظمات المتطرفة وهي محظورة فيها.
Executive AI Consulting, Custom Agents & Team Workshops
Work directly with Zhemal Khamidun at hamidun.com — enterprise AI architecture, production RAG & multi-agent systems, and executive training.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.