مقارنة نماذج الذكاء الاصطناعي لتوليد الفيديو: Sora 2 وVeo 3.1 وKling وGrok
قارن كتّاب Habr بين خمسة من أبرز مولّدات الفيديو بالذكاء الاصطناعي، وهي Veo 3.1 وKling v3 Omni وSora 2 Pro وLTX-2.3 Pro وGrok Imagine Video 1.5، عبر سبعة سيناريوهات متطابقة: فارس من العصور الوسطى، ومشعوذ يؤدي حركات الجغلة، وقط مذعور، وويل سميث وهو يأكل السباغيتي. اعتمد الاختبار الموجّهات نفسها والإعدادات نفسها وظروف التشغيل المتكافئة، ما يجعله اختبار ضغط نزيهاً في منتصف عام 2026.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News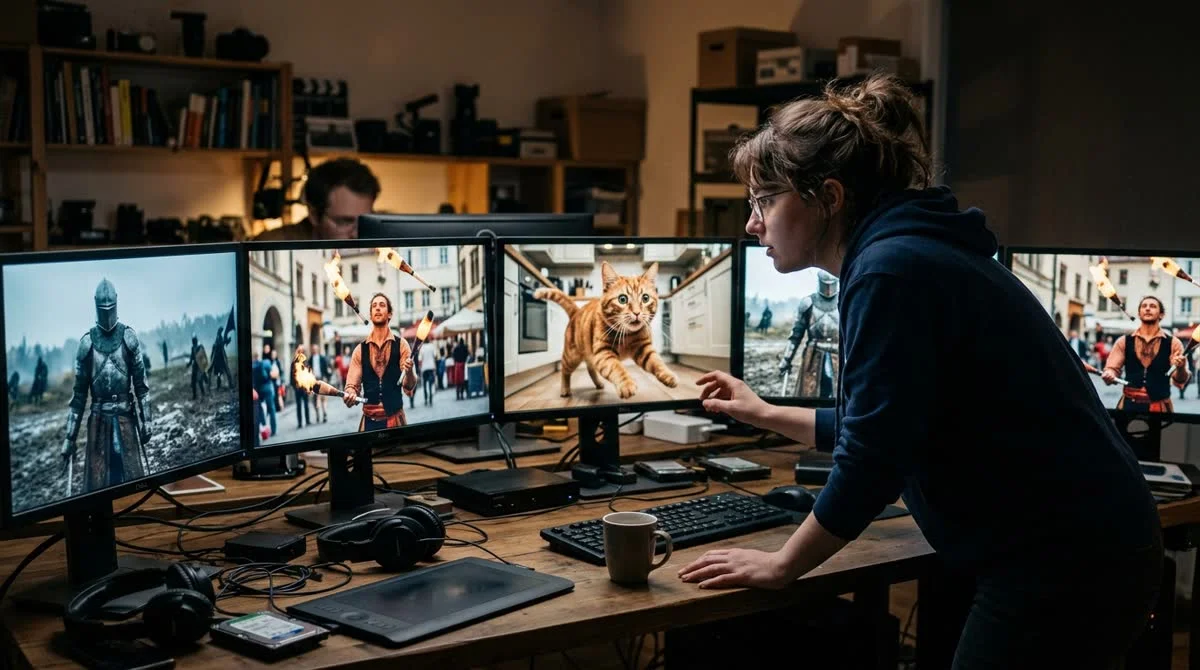
اختبر كتّاب Habr خمسة من أفضل نماذج الذكاء الاصطناعي لتوليد الفيديو، وهي Veo 3.1 وKling v3 Omni وSora 2 Pro وLTX-2.3 Pro وGrok Imagine Video 1.5، وشغّلوا كل نموذج منها عبر سبعة سيناريوهات متطابقة بالموجّهات (prompts) والإعدادات نفسها.
ما الذي شمله الاختبار
تنتمي الأدوات الخمس المشاركة في المقارنة إلى منظومات مختلفة:
- Veo 3.1 — أحدث نموذج فيديو من Google DeepMind، وهو الجيل الثالث من هذه السلسلة
- Kling v3 Omni — النموذج الرائد لدى استوديو Kuaishou الصيني
- Sora 2 Pro — مولّد متقدم من OpenAI يطوّر نموذج Sora الأصلي الصادر عام 2024
- LTX-2.3 Pro — حل مفتوح المصدر من Lightricks، وبديل بارز للنماذج المغلقة
- Grok Imagine Video 1.5 — نموذج فيديو من منظومة xAI، مدمج في منصة Grok
تغطي العينة شرائح سوقية متنوعة: مختبرات الذكاء الاصطناعي الأمريكية، والاستوديوهات الصينية، والمشاريع مفتوحة المصدر، دون انحياز إلى لاعب بعينه.
كيف صُمّمت المنهجية
المبدأ الأساسي في الاختبار هو قابلية إعادة الإنتاج الصارمة. تلقّى كل نموذج الموجّه نفسه بالمعاملات نفسها: الدقة والمدة وإعدادات التوليد الأساسية. وتتدرج السيناريوهات السبعة في صعوبتها.
تشمل هذه السيناريوهات فارساً من العصور الوسطى في حالة حركة، ومشعوذاً يؤدي حركات الجغلة بأدواته، وقطاً مذعوراً، إضافة إلى اختبار الضغط الكلاسيكي: ويل سميث وهو يلتهم السباغيتي. وقد تحوّل هذا السيناريو الأخير إلى ميم في مجتمع الذكاء الاصطناعي، إذ أنتجت النماذج الأولى فيه نتائج فاشلة بوضوح، بأيدٍ مشوهة وفيزياء غير طبيعية.
تغطي المجموعة عمداً نقاط الضعف التاريخية في الفيديو التوليدي: فيزياء حركة اليدين والأصابع، وتعابير الوجه، والتفاعل مع الأشياء، وواقعية الفضاء.
لماذا تبدو المقارنة مهمة الآن تحديداً
حتى عام 2024، كان من السهل التعرف على فيديو الذكاء الاصطناعي من عيوبه المميزة: وجوه متموجة، وأصابع زائدة، وحركات متقطعة. وخلال عام ونصف إلى عامين، قطع السوق شوطاً من المواد الطريفة إلى أدوات تُستخدم فعلاً في التسويق والسينما والإعلان.
«في السنوات الماضية كان فيديو الشبكة العصبية يُعرف من عيوبه المميزة.
فكيف الحال في منتصف 2026؟» — بهذه الصيغة يطرح الكتّاب السؤال المحوري للاختبار.
يواجه المستخدم اليوم تحدياً مختلفاً: لم يعد المطلوب «التمييز عن الفيديو الحقيقي»، بل «اختيار الأداة المناسبة من بين عشرات الأدوات المتاحة». فكل نموذج يروّج لمقاييسه الخاصة (benchmarks) ومقاطعه الإعلانية، ويظل الاختبار المستقل في ظروف متكافئة أمراً نادراً.
ماذا يعني ذلك
تُعد المقارنة بموجّهات موحدة من أكثر صيغ التقييم نزاهة، إذ لا تؤخذ في الحسبان الادعاءات التسويقية للشركات المطوّرة. وتفيد النتائج من يختار أداة لمهام محددة، مثل المقاطع التسويقية ونماذج المشاهد البصرية الأولية ومحتوى وسائل التواصل الاجتماعي. لقد خرج سوق فيديو الذكاء الاصطناعي نهائياً من مرحلة العروض التوضيحية، وصار اليوم خياراً عملياً تترتب عليه رهانات حقيقية.
ما نماذج الفيديو بالذكاء الاصطناعي التي جرى اختبارها؟
Veo 3.1 (Google DeepMind) وKling v3 Omni (Kuaishou) وSora 2 Pro (OpenAI) وLTX-2.3 Pro وGrok Imagine Video 1.5.
ما أفضل نموذج ذكاء اصطناعي لتوليد الفيديو؟
قارن اختبار Habr بين خمس أدوات: Veo 3.1 (Google DeepMind) وKling v3 Omni (Kuaishou) وSora 2 Pro (OpenAI) وLTX-2.3 Pro وGrok Imagine Video 1.5. وخاض كل نموذج سبعة سيناريوهات متطابقة لضمان مقارنة موضوعية.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.